Nextflow还是得懂一点!
Nextflow还是得懂一点!
之前小编做上游,因为样本不多,一般都是自己写shell脚本,但是最近终于也遇到了因为fastq损坏,脚本无法断点重续的问题。请教了一下学校core的老师,他给我科普了很多关于工作流(workflow/pipeline) 的知识,我才发现其实很多时候我是在重复造轮子......
从炒菜说起
如果你在准备一顿年夜饭。你需要:
- 买菜(下载数据)
- 洗菜切菜(质控)
- 炒不同的菜(比对、定量、差异分析)
- 摆盘上桌(结果可视化)
如果你一个人按顺序做,效率很低。但如果你能:
- 并行处理:洗菜的同时让电饭煲煮饭
- 断点续做:某道菜做坏了不影响其他菜
- 资源调度:炒菜用大火,炖汤用小火
- 可重复性:写好菜谱,下次照做就行
这就是工作流管理系统的核心思想。
在生信界,工作流工具就像编程语言一样多:Snakemake、WDL、CWL、Galaxy等等。其中Nextflow的自由度高、支持容器,而且本地、HPC环境、云端都能跑(界面也比较好看lol),所以这里用NF做例子啦。
最重要的是,Nextflow拥有非常活跃的社区,比如今天要讲的 nf-core,里面有很多经过验证的、现成的工作流,可以拿来就用。
一些基础知识
我们先了解一下Nextflow的一些核心概念。
安装
具体的安装指引可以查看官方指南,我们使用conda安装:
conda install -c bioconda nextflow
Params(参数):灵活的调节器
params用于定义工作流全局的参数。比如我们定义input参数,就可以在之后的运行中使用--input 自定义输入目录。
// 这是注释,用双斜杠标注
// === 在脚本中定义默认参数 ===
params.input = "data/*.fastq.gz"

// === 在脚本中使用参数 ===
println "处理文件: ${params.input}"

// 在process中使用参数
process HEAD {
    script:
    """
    zcat ${params.input} | head -5
    """
}
Process(进程):工作流的基本单元
进程相当于脚本中的函数,用于定义某个具体步骤。
process FASTQC {

    input:
    path reads  // 输入路径

    output:
    path "*.html"  // 输出路径

    script:
    """
    fastqc ${reads}  // 执行步骤
    """
}
Channel(通道):数据的高速公路
通道用于将数据在进程间传递。
Channel
// 原始数据的位置
    .fromPath('data/*.fastq.gz')
// 设置该路径为fastq_files
    .set { fastq_files }
// 数据在通道中流动,自动分配给process
Workflow(工作流):流程的指挥家
主工作流用于编排各个步骤,一般存储在.nf文件中。
workflow {
    // 编排各个process
    FASTQC(fastq_files)
    TRIMMING(FASTQC.out)
    ALIGNMENT(TRIMMING.out)
}
极简示例
我们来创建一个非常简单的例子:数fastq文件的行数。
将以下内容存储为simple_count.nf:
#!/usr/bin/env nextflow

// 定义参数
params.input_dir = "data"

// 定义process
process count_lines {
    input:
    path fastq_file

    output:
    stdout

    script:
    """
    # 计算行数
    lines=\$(cat ${fastq_file} | wc -l)

    # 输出到stdout
    echo "${fastq_file}: \${lines} lines"
    """
}

// 定义workflow
workflow {
    // 创建输入文件通道
    fastq_ch = Channel.fromPath("${params.input_dir}/*.fastq")

    // 运行process并显示结果
    count_lines(fastq_ch) | view
}
运行一下试试:
nextflow run simple_count.nf

N E X T F L O W   ~  version 25.04.6
Launching `simple_count.nf` [tender_noether] DSL2 - revision: 57798a27f6
executor >  local (2)
[f5/3263ca] count_lines (2) | 2 of 2 ✔
sample1.fastq: 8 lines
sample2.fastq: 4 lines
nf-core
上文提到,nf-core包含数十个标准化而完善的现成工作流。其中,nf-core/rnaseq可能是使用最广泛的RNA-seq分析流程。每个pipeline都有流程图展示具体步骤,rnaseq工作流的流程图如下。
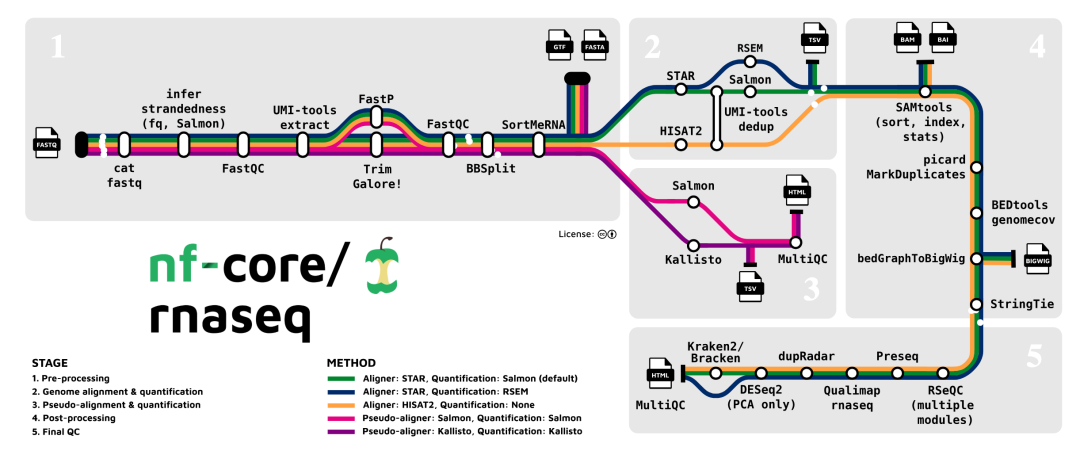 rnaseq流程图,来源:nf-core
nf-core已经集成一个pip包,安装后就可以直接运行已有的工作流,不必处理繁琐的配置文件,也不用额外下载工作流文件。
安装
pip install nf-core
# 查看可用的pipeline
nf-core pipelines list
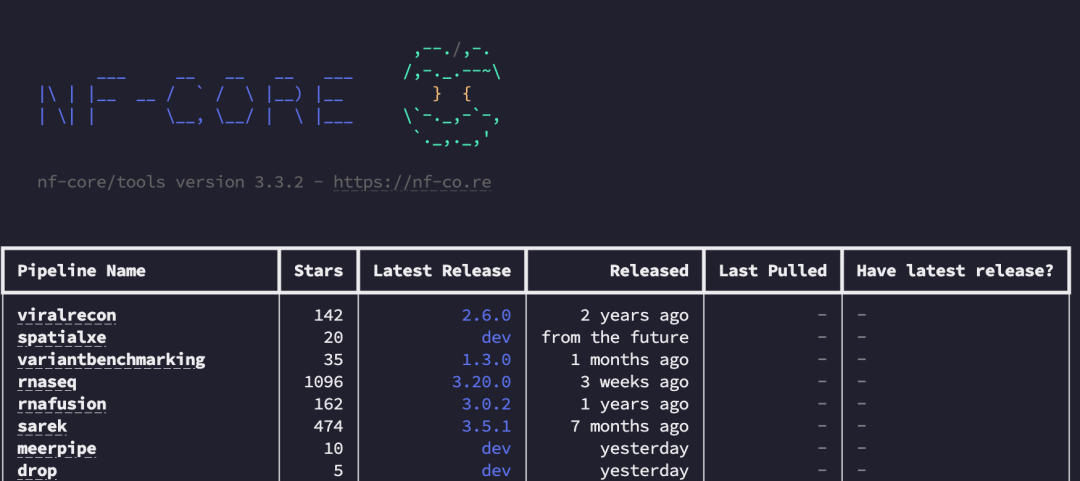
有兴趣的读者可以去研究此工作流的完整文档,这里不做赘述。
获取pipeline
从nf-core拉取rna-seq的pipeline:
nextflow pull nf-core/rnaseq
# 可以检查是否已经pull
nf-core pipelines list rnaseq -s pulled
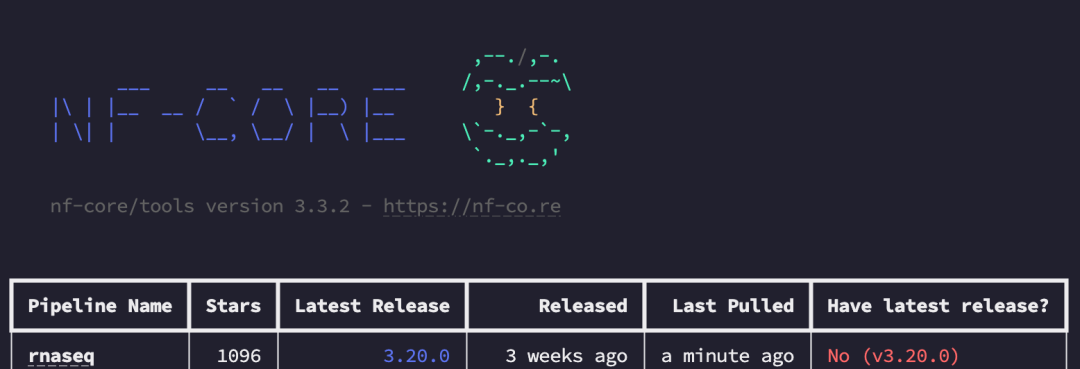
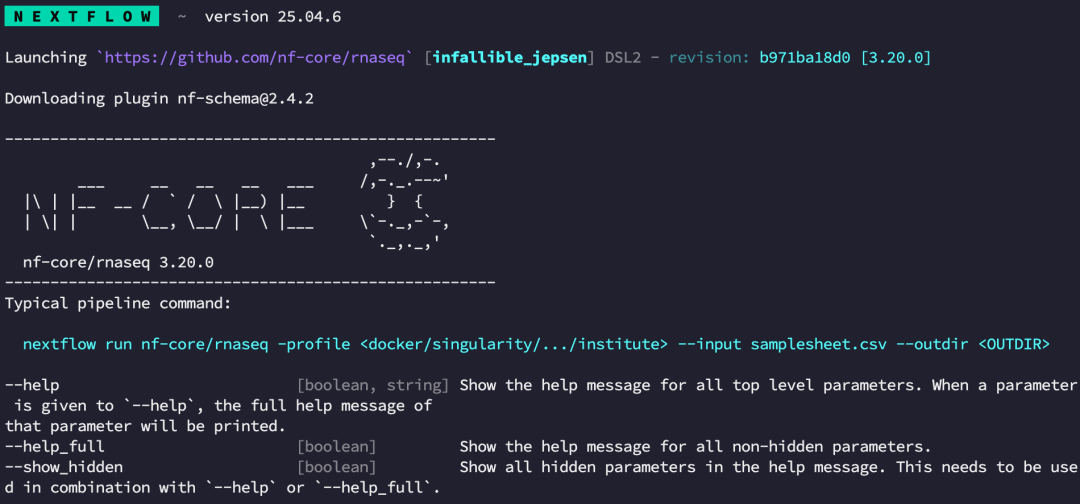
接下来查看一下pipeline的具体参数和帮助:
nextflow run nf-core/rnaseq -r 3.20.0 --help
测试pipeline
如果你只是想测试一下,可以运行以下命令:
nextflow run nf-core/rnaseq \
  -r 3.20.0 \
  -profile test,singularity \
  --outdir results
这会从网站上实时获取测试数据和依赖包的镜像,并且运行pipeline。
运行pipeline
实际运行的时候,需要创建一个样本表(samplesheet.csv),比如:
sample,fastq_1,fastq_2,strandedness
CONTROL_1,ctrl_1_R1.fastq.gz,ctrl_1_R2.fastq.gz,auto
CONTROL_2,ctrl_2_R1.fastq.gz,ctrl_2_R2.fastq.gz,auto
TREATED_1,treat_1_R1.fastq.gz,treat_1_R2.fastq.gz,auto
TREATED_2,treat_2_R1.fastq.gz,treat_2_R2.fastq.gz,auto
如果一个样本有多个fastq,只需要保证sample一栏一致就行。
如果不打算使用docker或singularity镜像,建议提前安装好依赖包(详见GitHub):
运行pipeline的一般语法:
nextflow run nf-core/rnaseq \
    --input <SAMPLESHEET> \
    --outdir <OUTDIR> \
    --gtf <GTF> \
    --fasta <GENOME FASTA> \
    -profile <docker/singularity/.../institute>
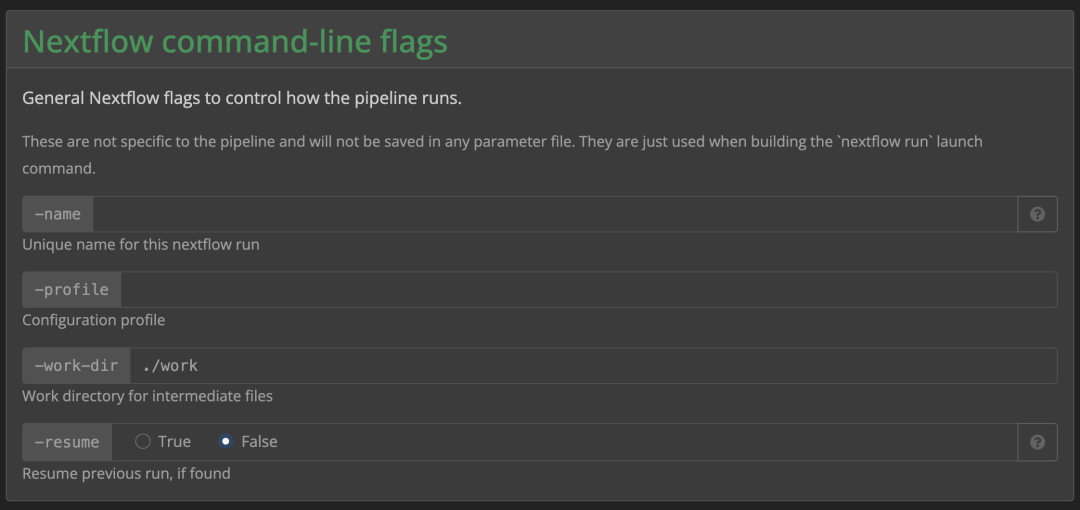
也可以使用以下命令进行交互式运行:
nf-core pipelines launch -r 3.20.0 rnaseq
选择Web based会唤起一个浏览器页面,可以交互式填充各项参数
选择Command Line则会在命令行中填充参数。
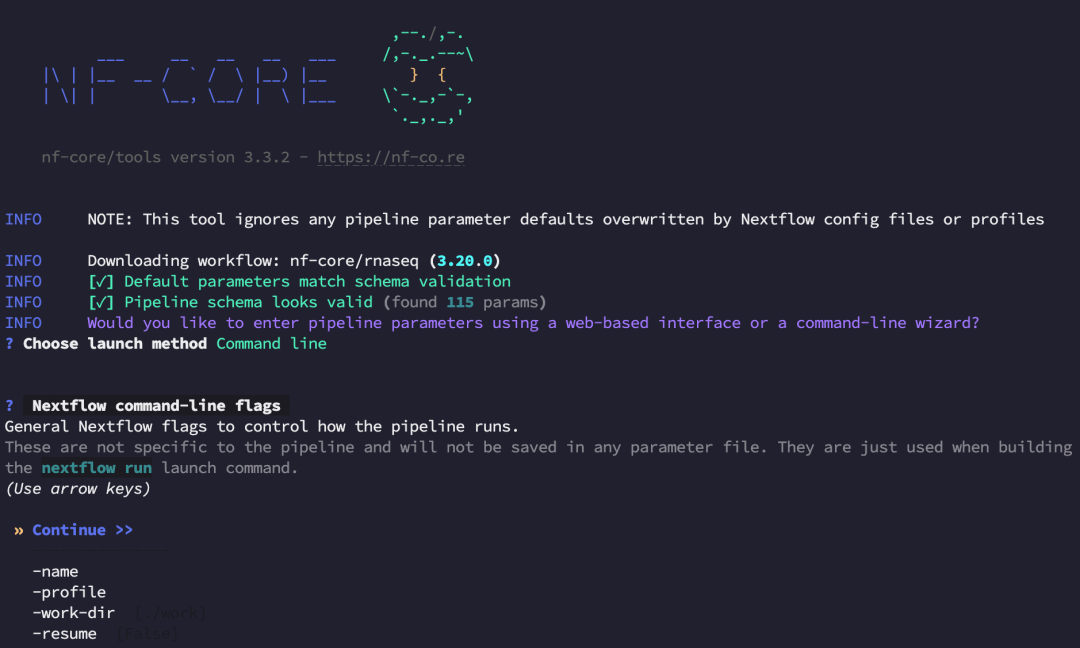
需要注意的是,工作流默认你已经自行安装了所有依赖包。如果你不确定,可以考虑加上-profile docker(或singularity) or -profile conda这个选项,让工作流自动下载依赖包的镜像或者配置conda环境。
离线运行
上述方式会动态获取最新的配置和工作流文件,运行中需要网络连接。如果想完全离线运行,可以将整个pipeline下载下来。
nf-core pipelines download nf-core/rnaseq -r 3.20.0 -s singularity
加上-s singularity这个flag可以确保将依赖包的镜像也下载(需要服务器安装有singularity)。
理解输出结果
pipeline运行结果如没有另外定义输出目录,会存储在当前目录下的results文件夹。来看看具体都有些啥:
results/
├── multiqc/
│   └── star_salmon/
│       └── multiqc_report.html          # 核心报告
│
├── salmon/  或  star_salmon/       # 根据--aligner参数决定
│   ├── salmon.merged.gene_counts.tsv    # 基因表达矩阵(主要分析文件)
│   ├── salmon.merged.gene_tpm.tsv       # TPM标准化表达值
│   ├── salmon.merged.transcript_*.tsv   # 转录本水平数据
│   └── deseq2_qc/
│       ├── deseq2.dds.RData            # DESeq2对象(R分析用)
│       ├── deseq2.pca.vals.txt         # PCA坐标数据
│       └── deseq2.plots.pdf            # 样本聚类图(PCA、热图)
│
├── star_salmon/ (仅star比对时)
│   ├── *.markdup.sorted.bam            # 最终BAM文件(IGV可视化)
│   ├── *.markdup.sorted.bam.bai        # BAM索引
│   └── bigwig/
│       └── *.{forward,reverse}.bigWig  # 覆盖度文件(基因组浏览器)
│
├── fastqc/
│   ├── raw/                            # 原始数据质控
│   └── trim/                           # 去接头后质控
│
├── 专项质控报告/
│   ├── qualimap/                       # RNA-seq特异性QC
│   ├── dupradar/                       # PCR重复率分析
│   ├── rseqc/                          # 读段分布分析
│   └── featurecounts/                  # 生物型分布统计
│
└── pipeline_info/
    ├── execution_report_*.html         # 资源使用报告
    ├── execution_timeline_*.html       # 运行时间线
    └── params_*.json                   # 使用的参数记录
params速查
| 参数类别 | 参数名 | 说明 | 示例值 |
|---|---|---|---|
| 必需参数 | --input | 样本表CSV文件路径 | samplesheet.csv |
| --outdir| 输出目录(云端需绝对路径)| results
参考基因组| --genome| iGenomes参考基因组名称| GRCh38, GRCm39
| --fasta| 自定义基因组FASTA| genome.fa
| --gtf| GTF注释文件| genes.gtf
| --star_index| 预建STAR索引| /ref/star_index
| --salmon_index| 预建Salmon索引| /ref/salmon_index
| --gencode| 是否为GENCODE格式GTF| true/false
比对选项| --aligner| 比对软件选择| star_salmon, star_rsem, hisat2
| --pseudo_aligner| 伪比对软件(额外运行)| salmon, kallisto
| --min_mapped_reads| 最低比对率阈值(%)| 5 (默认)
| --extra_star_align_args| STAR额外参数| "--outFilterMultimapNmax 999"
| --extra_salmon_quant_args| Salmon额外参数| "--numBootstraps 100"
去接头选项| --trimmer| 去接头工具| trimgalore (默认), fastp
| --min_trimmed_reads| 最少保留reads数| 10000 (默认)
| --extra_trimgalore_args| Trim Galore额外参数| "--length 50"
质控选项| --skip_fastqc| 跳过FastQC| true/false
| --skip_multiqc| 跳过MultiQC| true/false
| --skip_dupradar| 跳过重复率分析| true/false
| --skip_qualimap| 跳过Qualimap| true/false
| --skip_rseqc| 跳过RSeQC| true/false
| --skip_deseq2_qc| 跳过DESeq2质控图| true/false
去污染选项| --remove_ribo_rna| 去除rRNA| true/false
| --bbsplit_fasta_list| BBSplit过滤参考序列| contaminants.txt
| --skip_bbsplit| 跳过BBSplit| true (默认)
UMI选项| --with_umi| 启用UMI去重| true/false
| --umitools_bc_pattern| UMI模式| "NNNNNN"
| --umi_dedup_tool| UMI去重工具| umitools (默认), umicollapse
保存选项| --save_trimmed| 保存去接头reads| true/false
| --save_align_intermeds| 保存中间BAM文件| true/false
| --save_unaligned| 保存未比对reads| true/false
| --save_reference| 保存生成的索引| true/false
定量选项| --featurecounts_feature_type| 计数特征类型| exon (默认)
| --gtf_extra_attributes| 额外GTF属性| gene_name (默认)
| --gtf_group_features| 分组属性| gene_id (默认)
参考文献
- Carpentries Nextflow教程
- nf-core rnaseq