上游笔记4: 速通BD单细胞上游
上游笔记4: 速通BD单细胞上游
📢 本期干货预告:
- 为什么选择BD Rhapsody? 深入解析其独特优势
- 从零开始: 完整的环境配置攻略
- 实战演练: 手把手教你跑通分析流程
大家好啊!生物医学领域的同学们对BD应该不陌生吧?大家常用的流式分析仪、流式分选仪大概率就是BD的仪器。作为流式领域的领头羊,BD当然也不会错过单细胞这个风口啦~今天就跟大家详细介绍下BD Rhapsody 平台以及对应的上游分析流程。
🤔 为什么选择BD Rhapsody?
1️⃣ 工作原理
与10x的**"微流控+油滴"** 不同,BD选择微孔板 的策略来分离单细胞。具体流程是这样的:
- 细胞悬液和带条形码的磁珠被加入微孔板
- 重力作用下,细胞和磁珠沉降到孔底
- 细胞裂解后,mRNA被磁珠上的oligo(dT)捕获
- 收集磁珠进行后续文库构建
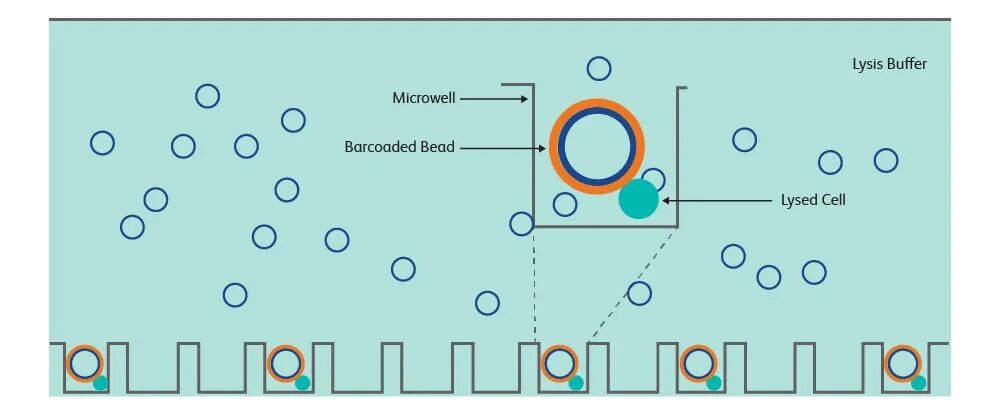 Source: BD Biosciences
2️⃣ 平台特色
两大平台各有千秋,一起来看看具体的对比:
| BD Rhapsody| 10x Genomics
---|---|---
分离方式| 微孔板| 微流控
细胞捕获率| >80%| ~65%
起始细胞量| 低至数百个| 通常需要数千个
样本类型| 支持FFPE| 主要支持新鲜样本
成本| 较高| 相对较低
通量| 较高| 高
总的来说,BD的优势在于:
- 更高的捕获效率(>80%)
- 支持低细胞数起始
- 可以处理FFPE样本
- 支持多组学测序(如AbSeq,scRNA+ATAC,scTCR/BCR)
所以如果你的样本比较珍贵(细胞数少)或者比较脆弱(如中性粒细胞),BD会是一个不错的选择。当然,这些优势的代价就是更高的成本和相对低一些的通量(BD的微孔板设计没那么容易scale up)。
3️⃣ 文库结构特点
跟10x其实很像,都包含:
- Cell Barcode (CB): 标记细胞来源
- Molecular Index (MI): 类似UMI,用来去PCR重复
- 基因序列: 实际的转录本序列
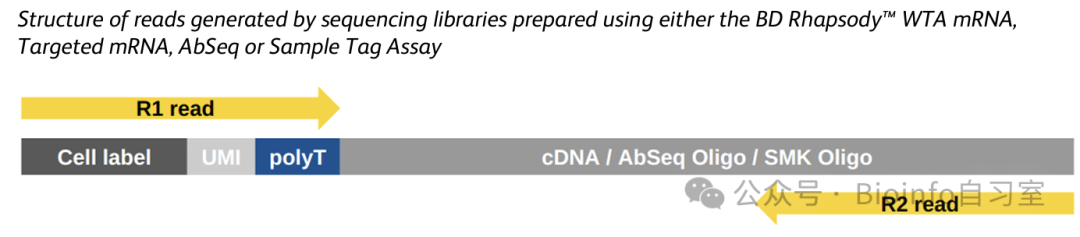 Source: BD Biosciences
💻 前期准备
⚠️ 环境要求:
- 系统: Linux或MacOS
- 内存: 至少96GB
- 存储: 至少256GB
- CPU: 8核心及以上
- 必需软件: Docker, Python3, CWL-runner
安装Docker engine
以下以Ubuntu系统为例,其他系统,以及其他安装方式请详见官方文档。用root的情况比较简单直接,没有root权限的小伙伴可以联系管理员协助安装。如果实在没有办法获取root权限,官方文档提到了无root权限的安装与配置,这里不做赘述。
# 检查docker是不是已经安装
which docker

# 如果安装了,请直接跳到下一环节
# 以下是安装docker的命令
# 卸载冲突包
for pkg in docker.io docker-doc docker-compose docker-compose-v2 podman-docker containerd runc;do sudo apt-get remove $pkg;done

# 添加Docker官方GPG key到系统:
sudo apt-get update
sudo apt-get install ca-certificates curl
sudo install -m 0755-d /etc/apt/keyrings
sudo curl -fsSL https://download.docker.com/linux/ubuntu/gpg -o /etc/apt/keyrings/docker.asc
sudo chmod a+r /etc/apt/keyrings/docker.asc

# 添加Docker库到系统:
echo \
"deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/keyrings/docker.asc] https://download.docker.com/linux/ubuntu \
  $(. /etc/os-release && echo "$VERSION_CODENAME") stable"| \
  sudo tee/etc/apt/sources.list.d/docker.list >/dev/null
sudo apt-get update

# 安装Docker
sudo apt-get install docker-ce docker-ce-cli containerd.io docker-buildx-plugin docker-compose-plugin
安装好了后,运行一个镜像试试:
sudo docker run hello-world
# 如果成功安装,应该看到:
#Hello from Docker!
#This message shows that your installation appears to be working correctly.
为了方便非root用户运行docker镜像,可以做以下的一次性配置(需要root):
# 创建docker用户组
sudo groupadd docker
# 将目标用户/目前用户加入组
sudo usermod -aG docker $USER

# 不使用sudo运行测试镜像:
docker run hello-world
需要注意的是以上配置赋予了用户部分root权限。如果有安全方面的考虑,还是建议按照无root权限的安装与配置里的方法进行(功能会有部分限制)。
安装其他依赖包和Pipeline
# 1. 创建conda环境
conda create -n bd-rhapsody python=3.11
conda activate bd-rhapsody

# 2. 安装依赖包
pip install -U pip
pip install cwlref-runner

# 3. 下载YML和CWL配置文件
# 以下链接可能不是最新的,建议到bitbucket.org/CRSwDev/cwl/downloads/查看最新的repo
wget https://bitbucket.org/CRSwDev/cwl/get/8d252728f875.zip
# 检查下载的配置文件
ls CRSwDev-cwl-8d252728f875/
#README.md  v1.0  v1.02  v1.10  v1.10.1  v1.11  v1.11.1  v1.12  v1.12.1  v1.3  v1.5  v1.6  v1.6.1  v1.7.1  v1.8  v1.9  #v1.9.1  v2.0  v2.2  v2.2.1
# 查看最新的v2.2.1配置
tree CRSwDev-cwl-8d252728f875/v2.2.1
#├── Extra_Utilities
#│   ├── AnnotateCellLabelUMI_2.2.1.cwl
#│   ├── make_rhap_reference_2.2.1.cwl
#│   ├── PhiXContamination_2.2.1.cwl
#│   └── README.md
#├── pipeline_inputs_template_2.2.1.yml
#└── rhapsody_pipeline_2.2.1.cwl

# 4. 下载镜像文件
docker pull bdgenomics/rhapsody
# 检查镜像
docker images
# REPOSITORY            TAG       IMAGE ID       CREATED         SIZE
# bdgenomics/rhapsody   latest    6d2c53b1b712   6 months ago    3.53GB
# hello-world           latest    d2c94e258dcb   19 months ago   13.3kB
准备参考基因组
BD提供预构建的人和小鼠参考基因组。
# 仅转录组
# 人h38+小鼠m38
wget https://bd-rhapsody-public.s3.amazonaws.com/Rhapsody-WTA/Pipeline-version2.x_WTA_references/RhapRef_Human42Mouse24_WTA_2023-02.tar.gz
# 人h38+小鼠m39
wget https://bd-rhapsody-public.s3.amazonaws.com/Rhapsody-WTA/Pipeline-version2.x_WTA_references/RhapRef_Human42Mouse31_WTA_2023-02.tar.gz
# 仅人
wget https://bd-rhapsody-public.s3.amazonaws.com/Rhapsody-WTA/Pipeline-version2.x_WTA_references/RhapRef_Human_WTA_2023-02.tar.gz
# 仅小鼠
wget https://bd-rhapsody-public.s3.amazonaws.com/Rhapsody-WTA/Pipeline-version2.x_WTA_references/RhapRef_Mouse_WTA_2023-02.tar.gz

# 转录组+ATAC
# human+mouse
wget https://bd-rhapsody-public.s3.amazonaws.com/Rhapsody-WTA-ATAC/Pipeline-version2.x_WTA_ATAC_references/RhapRef_Human-Mouse_WTA-ATAC_2023-11.tar.gz
# human
wget https://bd-rhapsody-public.s3.amazonaws.com/Rhapsody-WTA-ATAC/Pipeline-version2.x_WTA_ATAC_references/RhapRef_Human_WTA-ATAC_2023-08.tar.gz
# mouse
wget https://bd-rhapsody-public.s3.amazonaws.com/Rhapsody-WTA-ATAC/Pipeline-version2.x_WTA_ATAC_references/RhapRef_Mouse_WTA-ATAC_2023-09.tar.gz
也可以自己构建参考基因组,比如:
cd CRSwDev-cwl-8d252728f875/v2.2.1
cwl-runner Extra_Utilities/make_rhap_reference_2.2.1.cwl \
    --Genome_fasta GRCh38.primary_assembly.genome.fa \#替换成实际fasta
    --Gtf gencode.v43.primary_assembly.annotation.gtf \#替换成实际gtf
    --Archive_prefix testrefhuman43 \#自定义基因组名字
    --WTA_only # 是否只构建转录组
🚀 运行实战
这里我们使用Illumina 发布的PBMC 2k数据做演示,具体下载方法可以看这里,有需要的小伙伴也可以后台暗号BD获取~
1️⃣ 准备配置文件
修改模版pipeline_inputs_template_2.2.1.yml,并储存为pbmc2k.yml
#!/usr/bin/env cwl-runner
cwl:tool:rhapsody
Reads:
-class:File
location:"pbmc2k/BD-Bio-NS2K-P2-600c-Sym-FL-10-2K-TD-mRNA_S1_L001_R1_001.fastq.gz"
-class:File
location:"pbmc2k/BD-Bio-NS2K-P2-600c-Sym-FL-10-2K-TD-mRNA_S1_L001_R2_001.fastq.gz"

Reference_Archive:
class:File
location:"ref/RhapRef_Human_WTA_2023-02.tar.gz"

Run_Name:pbmc2k
Maximum_Threads:32
Generate_Bam: true
2️⃣ 启动分析
mkdir results_folder
cwl-runner --parallel \
    --outdir results_folder \
    rhapsody_pipeline_2.2.1.cwl \
    pbmc2k.yml
3️⃣ 输出文件解读
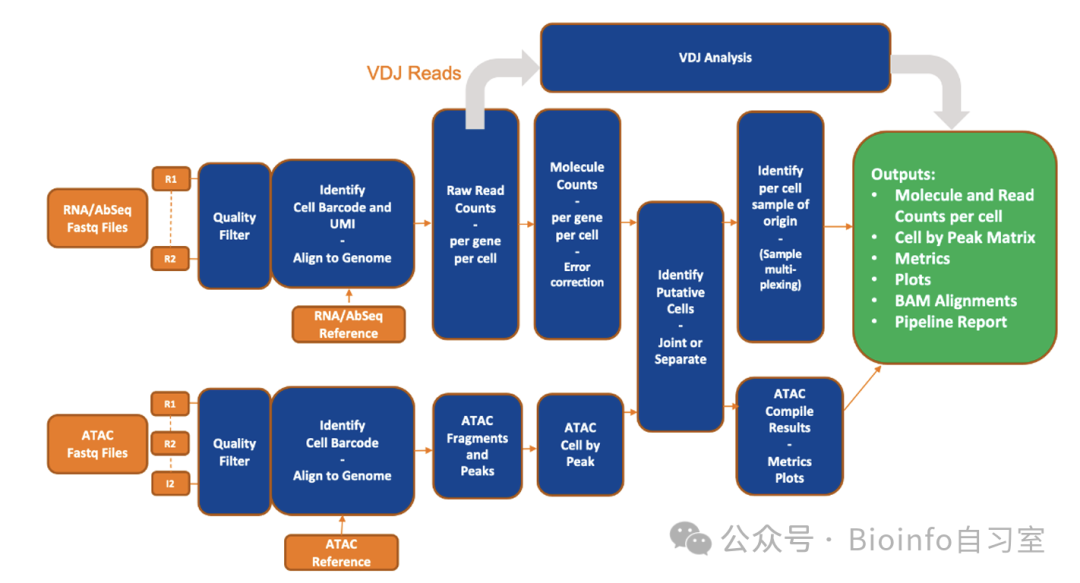
分析完成后会得到以下主要文件:
pbmc2k_Pipeline_Report.html: 分析报告pbmc2k_Seurat.rds: Seurat对象pbmc2k.h5mu: Scanpy对象pbmc2k_RSEC_MolsPerCell_MEX.zip: 计数矩阵pbmc2k_Bioproduct.bam: BAM文件
 Source: BD Biosciences
参考资料
- BD Rhapsody Bioinfo 官方文档
💌 后台回复BD获取本教程中用到的样本数据、配置文件、参考基因组、以及PDF版官方文档(英文)。如果有任何疑问,或者有别的想法和建议,欢迎在评论区告诉我!
#生物信息学 #单细胞测序 #BD_Rhapsody #数据分析