上游笔记3: 多重捕获测序?你的Multi来了
上游笔记3: 多重捕获测序?你的Multi来了
上一篇笔记讲到,多样本或者多模式(比如TCR/BCR+Gene Expression)的10x Genomics数据处理通常会用到cellranger multi来处理数据以及生成表达量矩阵。这里的"multi",指的是multiplex(多重)或者multimodal(多模态)的意思,这两个都是现代生物学研究中常用的术语。考虑到multiplex的应用更加广泛,本文将主要介绍这个方向。
Multiplexing(多重捕获)简介
Multiplexing,在测序的语境下是指在单次测序运行中同时测序多个样本的过程,是一个非常常用的技术。当样本数目较多、对通量要求较高、或是想消除批次效应 的情况下,multiplexing可以显著降低测序成本和提高测序效率。
例如,在不使用multiplexing的情况下,测序10个样本可能需要10次独立的测序运行。而使用multiplexing技术,我们可以在一次测序运行中完成所有10个样本的测序,大大节省了时间和成本。
具体来说,multiplexing包括三个主要步骤:添加样本标记、混合、测序 。其中最关键的一步就是添加标记,以便于之后可以将每个样本的数据分离出来。这个分离的过程就叫做demultiplexing(解复用) 。
按照multiplexing的步骤反推,demultiplexing需要:
1. 分析原始测序数据中的标签序列 (又称CMO, cell multiplexing oligos,或HTO, hashtag oligos)。
2. 根据CMO将测序读段(reads)分配回它们原来的样本。
3. 对样本序列数据进行下一步处理(比对、定量等等)。
cellranger multi正是用于实现以上步骤的流程。
CMO vs Barcode vs UMI
看到上面的介绍,有些朋友可能有些困惑。不是已经有barcode和UMI了吗?为什么还需要CMO?CMO跟barcode、UMI有什么区别?
让我们先来看一下这三者的主要特征对比:
| 特征 | CMO | Barcode | UMI |
|---|---|---|---|
| 用途 | 区分样本 | 区分细胞 | 区分mRNA分子 |
| 添加时机 | 样本制备阶段 | 单细胞分离阶段 | 反转录阶段 |
| 长度 | 较短 | 中等 | 较短 |
| 位置 | 细胞表面 | cDNA 5'端 | cDNA 5'端,Barcode之后 |
CMO通常是连接到抗体或磁珠上的寡核苷酸(也可以是自由片段,不连接磁珠/抗体),这些寡核苷酸具有特定的序列标签,用于标记不同的样本或细胞群。与细胞悬液混合后,通过磁力或者免疫相互作用与细胞结合,比如BioLegend的TotalSeq系列。
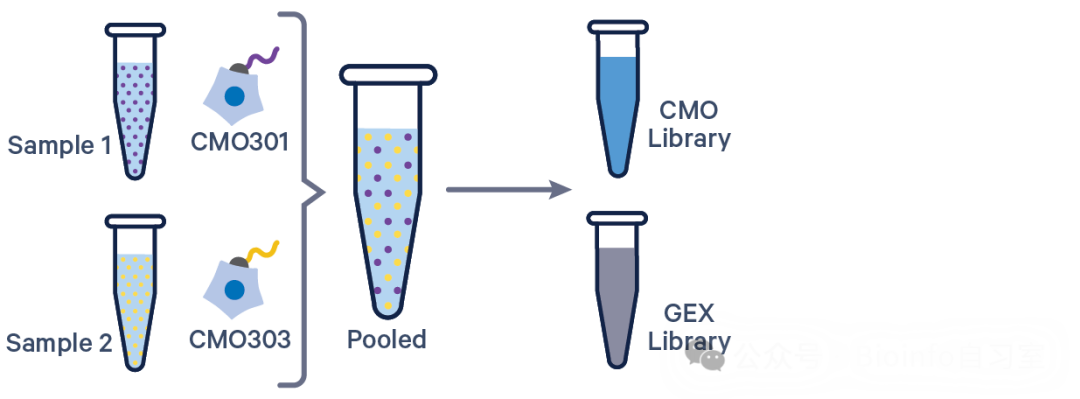
CMO配置示例。来源:10X Genomics
Multiplexing 实验流程
我们来看看CMO具体是怎么使用,又是如何将序列和样本对应起来的:
1. 样本制备: 在实验开始时,我们给每个样本加上唯一的CMO。这些CMO会与细胞表面的蛋白结合。
2. 单细胞分离: 当我们使用微流控技术将细胞分离到油滴中时,CMO也会跟随细胞进入同一个油滴。此时的理想情况下,每个油滴中包含了一个细胞(带有CMO)、一个凝胶珠(带有barcode和UMI)、以及反转录所需的试剂。
3. 反转录,PCR: 在每个油滴中,我们会同时进行两种反应: a) CMO会被扩增并加上特定的接头序列。 b) 细胞内的mRNA会被反转录成cDNA,并加上barcode、UMI和特定的接头序列。 关键在于,这两种产物(CMO和cDNA)会共享相同的细胞barcode 。
4. 文库制备: 反应完成后,油滴被打破,所有产物被收集在一起。此时,CMO和cDNA产物是混合在一起的,但它们有不同的特征:cDNA产物通常较长,包含基因特异性序列、UMI和barcode 。CMO产物较短,包含CMO特异性序列和barcode 。
5. 文库分离: 利用CMO和cDNA产物的长度差异,我们可以通过凝胶电泳 或磁珠纯化 等方法将它们分离。这一步是关键,它允许我们将CMO和cDNA产物分开。
6. 分别测序: 分离后的CMO和cDNA文库被分别进行测序。
7. 数据分析: 在数据分析阶段,我们首先处理CMO测序数据,建立barcode和样本之间的对应关系。然后,我们分析cDNA测序数据,获得每个barcode对应的基因表达谱。最后,我们将这两部分信息整合,得到每个样本中各个细胞的基因表达情况。
这种方法不仅能够准确地将不同样本的细胞数据分开,还能在数据分析阶段追溯每个细胞的来源,即使样本在早期就被混合在一起。例如,如果一个barcode在CMO数据中对应于样本A的CMO,在cDNA数据中对应于某个基因表达谱,我们就知道这个基因表达谱来自样本A的一个细胞。
Cellranger multi实战
了解了multiplex的原理,我们来看看cellranger multi具体应该怎么运行吧。
准备数据
除了必要的cellranger本体和提前下载好的参考基因组,你还需要:
• 测序数据: fastq文件
• CMO序列: feature_reference.csv
• 配置文件: multi_config.csv
测序数据
刚才提到,multiplexing实验的CMO和cDNA是分开测序的,所以我们会得到两组fastq文件:
fastq/
├── CMO/
│├── run1_CMO_L001_I1_001.fastq.gz
│├── run1_CMO_L001_I2_001.fastq.gz
│├── run1_CMO_L001_R1_001.fastq.gz
│├── run1_CMO_L001_R2_001.fastq.gz
│└──...
└── cDNA/
├── run1_cDNA_L001_I1_001.fastq.gz
├── run1_cDNA_L001_I2_001.fastq.gz
├── run1_cDNA_L001_R1_001.fastq.gz
├── run1_cDNA_L001_R2_001.fastq.gz
└── ...
复习一下fastq的命名规则:
样本 通道(L001/L002等)读序(I1/I2/R1/R2)_组别(001).fastq.gz
我特意把fastq文件的开头改成了run1以避免混淆。因为在multiplex的实验中,这个“样本”部分其实指的是单次测序运行,不一定是跟真实样本一一对应的 。比如,我可以把6个样本混合到一起,分在一次运行的两个不同通道上测序。此时会产生8个CMO的fastq(每个通道分别产生R1,R2,I1,I2)以及8个cDNA的fastq,总计16个文件,但是这一点在fastq文件名上很可能是看不出来的,因为他们的“样本”部分名字可能都是一样的(如上图,都是run1)。如果是正常测序,不做multiplexing,实际应该得到6*4=24个 fastq文件,比做multiplexing多了8个。
CMO序列
除了fastq文件,我们还需要一个csv表格,列出CMO的id、对应的样本、读序中的规律、具体序列,以及用途。
举例,我们用了BioLegend的TotalSeq-A anti-mouse Hashtag系列的CMO。这一系列的CMO结合小鼠的泛细胞表面抗原MHC-I和MHC-II以求尽量覆盖到免疫和非免疫的细胞。在官网查找到对应序列后可生成feature_reference.csv如下:
id,name,read,pattern,sequence,feature_type
A0307,CMO1,R2,^(BC),GAGTCTGCCAGTATC,Multiplexing Capture
A0308,CMO2,R2,^(BC),TATAGAACGCCAGGC,Multiplexing Capture
A0303,PS1,R2,^(BC),CTTGCCGCATGTCAT,Multiplexing Capture
A0304,PS2,R2,^(BC),AAAGCATTCTTCACG,Multiplexing Capture
A0305,PSP1,R2,^(BC),CTTTGTCTTTGTGAG,Multiplexing Capture
A0306,PSP2,R2,^(BC),TATGCTGCCACGGTA,Multiplexing Capture
这里的id我就填了产品的编号,理论上是可以自定义的,只要序列是对的就可以。同理name也可以自定义名称。
read和pattern这两栏要遵循特定的格式,如R2,^(BC) 的意思是,CMO的序列(barcode)位于Read 2的开头(^是regex中字符串开头)。这是最常见的一种情况,10x和BioLegend的CMO都是这个格式。
当然,如果用了其他第三方的CMO,也可能会出现其他格式。举几个例子:
• R1,(CB+BC): CMO在cellular barcode后面,位于R1
• R1,(16C+8B): R1含有16bp长的cellular barcode和8bp长的CMO
• I2,^(BC): CMO位于I2开头
诸如此类。划重点:首先是CMO所在读序(R1/R2/I1/I2) ,然后位置(开头^,结尾$,不明确无) ,然后长度(可填可不填) ,最后是细胞序列(C/CB)和CMO序列(B/BC)的相对位置(如BC,CB+BC) 。
sequence ,即具体序列,顾名思义,略过。最后一栏feature_type填Multiplexing Capture 。这是Multiplexing的情况,其他情况不固定,比如蛋白丰度填Antibody Capture 。此时CMO就不叫CMO了,叫feature barcode ,也可以理解为CMO是feature barcode的一种。
配置文件
cellranger multi跟cellranger count不同的一点是,它的选项和配置都要另外包含在一个csv中,而不是写在命令行里。
比如以下的 multi_config.csv :
[gene-expression]
reference,refdata-gex-GRCm39-2024-A/
create-bam,true

[feature]
reference,feature_ref.csv

[libraries]
fastq_id,fastqs,feature_types
run1_cDNA,fastq/cDNA,GeneExpression
run1_CMO,fastq/cDNA,MultiplexingCapture

[samples]
sample_id,cmo_ids
Sample1,A0301
Sample2,A0302
Sample3,A0303
Sample4,A0304
Sample5,A0305
Sample6,A0306
文件结构
文件由几个部分组成,每个部分都以方括号中的标题开始,如[gene-expression]、[feature]、[libraries]和[samples]。每个部分下面是该部分的具体配置项。
1. [gene-expression]
这部分配置与基因表达分析相关的参数。
格式要求:
• 每行为一个配置项
• 格式为
参数名,参数值
可能包含的参数:
 reference,<path-to-reference>
chemistry,<chemistry-name>
expect-cells,<number>
force-cells,<number>
no-secondary,<true/false>
create-bam,<true/false>
...
示例:
[gene-expression]
reference,refdata-gex-GRCm39-2024-A/
create-bam,true
2. [feature]
这部分用于配置额外的feature信息,如抗体标记/CMO序列或CRISPR的guideRNA序列。
格式要求:
- • 通常只有一行,指定特征参考文件的位置
示例:
[feature]
reference,feature_ref.csv
3. [libraries]
这部分定义了实验中使用的所有测序文库。
格式要求:
• 第一行是标题行,定义了列名
• 后续每行代表一个文库
• 列之间用逗号分隔
必需的列:
•
fastq_id: 文库的唯一标识符•
fastqs: FASTQ文件的路径•
feature_types: 文库类型(如Gene Expression, Antibody Capture等)
示例:
[libraries]
fastq_id,fastqs,feature_types
run1_cDNA,fastq/cDNA,Gene Expression
run1_CMO,fastq/cDNA,Multiplexing Capture
4. [samples]
这部分定义了实验中的样本信息。需要注意的是,cmo_ids需要和feature_reference的第一列id对应。
格式要求:
• 第一行是标题行,定义了列名
• 后续每行代表一个样本
• 列之间用逗号分隔
必需的列:
•
sample_id: 样本ID•
cmo_ids: 对应的CMO的ID
示例:
[samples]
sample_id,cmo_ids
Sample1,A0301
Sample2,A0302
Sample3,A0303
注意事项
1. 文件格式应为纯文本的CSV格式。
2. 确保所有路径都是正确的,可以是相对路径或绝对路径。
3. 在
[libraries]部分,确保每个文库都有唯一的fastq_id。这也适用于CMO和cDNA,这两个部分应当被看作是独立的文库。4. cmo_ids需要和feature_reference的第一列id对应。
命令行运行
cellranger multi --id=cellranger_outs --csv=multi_config.csv --localcores=48 --localmem=128
万事俱备,最后一步就是运行cellranger multi啦!这一步能够定义的选项有:
• id: 实验id,也就是最后输出目录的名字
• csv: 配置文件的csv,注意路径是否正确
• localcores:核心数,我用了48核
• localmem:内存占用,我用了128G
cellranger multi 输出解析
运行完成后,cellranger multi 会在指定的输出目录(本例中为 cellranger_outs)中生成多个文件和子目录。以下是一些关键输出及其用途:
1. outs/per_sample_outs/ : 这个目录包含了每个样本的单独分析结果。对于每个样本,你会看到类似以下的文件:
•
filtered_feature_bc_matrix/: 包含过滤后的基因表达矩阵•
raw_feature_bc_matrix/: 包含原始的基因表达矩阵•
cloupe.cloupe: 用于在Loupe Browser中可视化数据的文件•
metrics_summary.csv: 包含关键质量指标的摘要
2. outs/count/ : 包含所有样本合并后的计数矩阵和相关文件。
3. outs/multiplexing_analysis/ : 这个目录包含了多重测序分析的结果,其中最重要的文件包括:
•
assignment_confidence_table.csv: 显示每个细胞被分配到特定样本的置信度•
tag_calls_summary.csv: 总结了每个样本的细胞数量和标记调用情况
4. outs/multi/multiplexing_analysis.html : 一个交互式的HTML报告,summarizes提供了多重测序分析的总体情况,包括样本分配、多重标记效率等。
5. outs/multi/gemgroup_*.html : 每个GEM组的详细HTML报告,包含了质量指标、细胞计数等信息。
6. outs/multi/config.csv : 运行时使用的配置文件的副本。
对于后续分析,最有用的文件通常包括:
• 过滤后的特征-细胞矩阵(
filtered_feature_bc_matrix/):这是进行下游分析(如聚类、差异表达分析等)的主要输入。• 样本分配结果(
assignment_confidence_table.csv):用于了解每个细胞属于哪个样本。• 质量指标摘要(
metrics_summary.csv):用于评估测序质量和实验成功程度。• Loupe文件(
cloupe.cloupe):用于快速可视化和探索数据。
当然,如果你在配置文件中设置了生成bam文件,你还可以通过bam2fastq反向生成每个样本的fastq文件。也就是说,cellranger multi也可以用于分离每个样本单独的fastq。
那么本期笔记就到这里,感谢观看!