上游笔记2: cellranger count也没那么难
上游笔记2: cellranger count也没那么难
首先:一些说明
 source: 10x Genomics
Cellranger 只能在 Linux 系统上运行,不支持 MacOS 或 Windows。 如果你想在 Mac上做计数,可以试试 salmon/alevin 或 kallisto/bustools(先🐎着,以后出教程)。此外也可以尝试STARsolo,据称通过调整参数可以输出几乎和 cellranger 相同的结果并且快10倍,甚至如果你平时就用STAR做RNA-seq的比对定量,还不用额外安装(同样先🐎着,以后研究一下是不是真的)。
以下教程假设服务器已经装好了cellranger(具体怎么安装就不赘述啦,可以参考官方文档,我用的是v8.0.1)并且下载了对应的参考基因组(可以在官网下载已经build好的压缩文件,我用的是GRCm39-2024-A)。
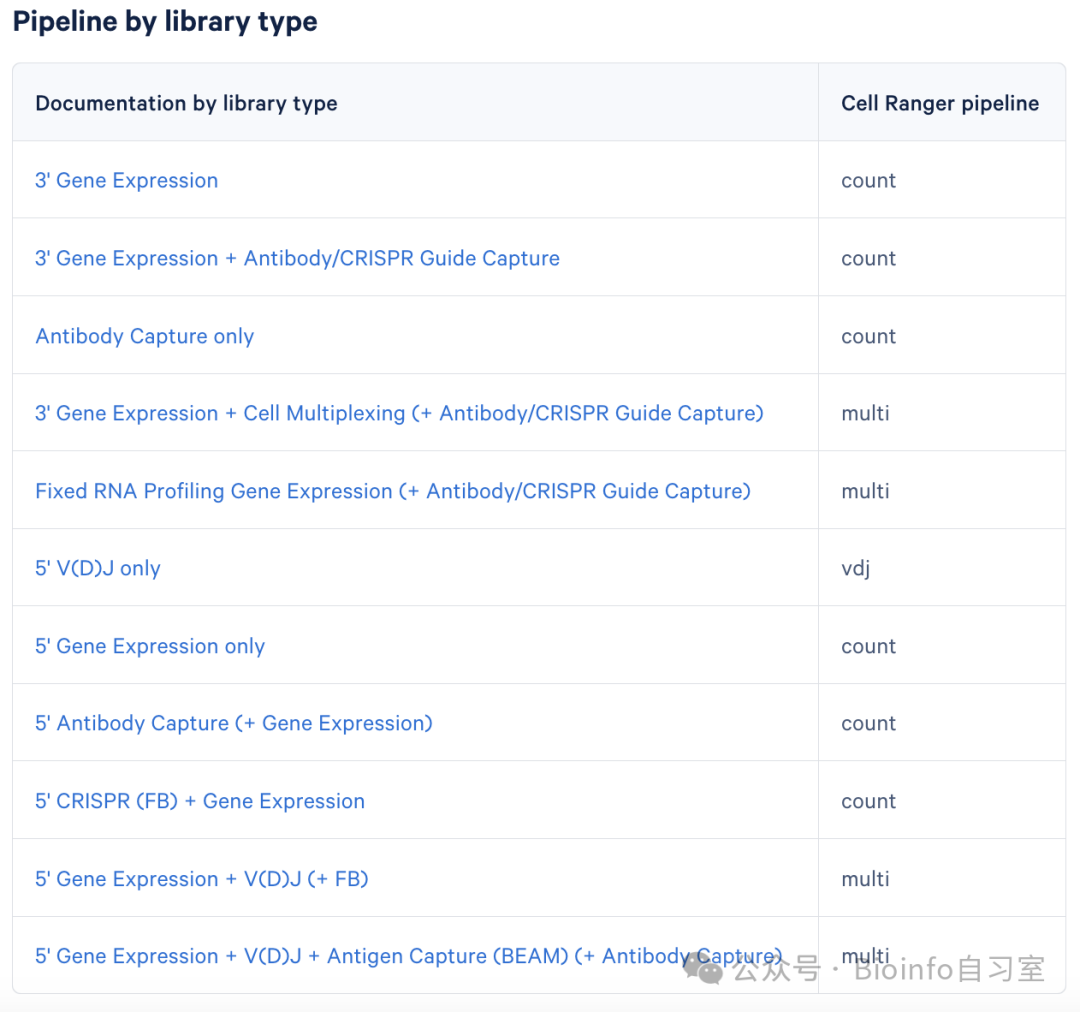
cellranger做单细胞上游有三个流程,分别是cellranger count ,cellranger vdj 和cellranger multi 。还有一个中游的流程cellranger aggr ,本来是用于整合数据 的,但是对于转换某些格式错误的数据 (指从molecule_info.h5重新生成count matrix)有奇效。简单来说,单样品单模度 (如转录组 或蛋白组 )用count ,免疫组 (TCR/BCR)用vdj , 多样本或者多模度 一律用multi 。具体根据库的类型可以看下面这个表。对于SRA下载的数据,大部分情况下跑count 就可以了,当然你要是懒的话也可以一律跑multi 。
 source:
Cellranger count流程
代码模版
cellranger count --id=Tumor_sample1 \
--transcriptome=/opt/refdata-gex-GRCh38-2024-A \
--fastqs=/home/runs/fastq \
--sample=sample1 \
--create-bam=false \
--expect-cells=5000 \
--nosecondary  \
--localcores=24 \
--localmem=128 \
--output-dir=/home/cellranger_outs
选项解释
除了id和transcriptome是必填,其他选项都是可选的。
• (必填)id: 样本名,这个可以随便写,流程会创建一个叫这个名字的文件夹,然后把输出的文件放在这里。所以要注意跑流程的时候输出目录不能有同名文件夹 ,不然就会出现xxx is not a pipestance directory这个错误
• (必填)transcriptome: 参考基因组的目录。人和小鼠的样本可以在10x官网下载提前建好的基因组(其他物种就需要自己建了):
人+小鼠,适合混合样本,比如PDX
wget "https://cf.10xgenomics.com/supp/cell-exp/refdata-gex-GRCh38_and_GRCm39-2024-A.tar.gz"
仅人
wget "https://cf.10xgenomics.com/supp/cell-exp/refdata-gex-GRCh38-2024-A.tar.gz"
仅小鼠
wget "https://cf.10xgenomics.com/supp/cell-exp/refdata-gex-GRCm39-2024-A.tar.gz"
解压
tar -xvzf refdata-gex-*.tar.gz
• fastqs: 存放fastq文件的目录,必须是目录名而不是文件名,而且目录名内不能含有跟id选项名字一样的文件夹,包括子/母文件夹 (不然还是会出现xxx is not a pipestance directory这个错误),比如id叫Tumor_sample1的话,fastq目录不能是Tumor_sample1/fastqs,但是可以是Tumor_sample1_fastqs。如果不填,默认读取当前目录下的fastq
• sample: fastq样本名,注意这个选项跟id是不一样的,这个样本名必须跟fastq文件开头的样本名一致(具体在下一节会讲)。比如fastq文件叫mysample _S1_L001_R1_001.fastq.gz, 这个地方就要填mysample ,如果不填的话会自动识别fastq目录下所有的sample
• create-bam: 是否创建bam文件。默认是true,但是改成false也不影响流程 ,所以如果想节省时间/存储空间的话可以填false
• expect-cells: 预期细胞数,一个非常大概的范围是1000-5000,不确定可以不填,不影响流程
• no-secondary: 不做二次分析(如差异分析和聚类)。如果打算自己跑下游,可以加上这个选项,能显著缩短流程时间
• localcores: 最大处理核心/线程数,多核处理可以显著缩短跑流程的时间,但是填的时候要注意机器有几核(或者提交job的时候request了几个核)。实在不确定的话,这个选项可以不填,不影响流程
• localmem: 最大内存占用(单位GB)。加大内存可以一定程度缩短跑流程的时间,一般来说localmem小于localcores的10倍(也就是每个核心负担<10G)比较稳妥,比如我用24核,这里就可以写不多于240G。同样,不确定可以不填,不影响流程
• output-dir: 输出目录,不填这个选项的话默认放在当前目录
以上是比较常用的选项,其他选项可以通过cellranger count --help查看。
fastq文件命名规则
cellranger输入的 fastq 文件必须遵循特定的命名规则,简单来说,应该按照以下方式:
< 名称>< 编号>< 泳道>< 读数>< 批次>.fastq.gz
• 名称: 样本的名称,如sample1,这部分可以自定义
• 编号: 机器区分不同样本的编号,大部分时候为S1,也就是一次测序测一个样本。
• 泳道: 即测序通道号,如L001、L002。
• 读数: 即测序时的读取编号,普通RNA测序一般是双端,也就是R1和R2;单细胞测序还会有index文件,即I1、I2。
• 批次: 大部分时候为001, 除非单次实验内分批进行了测序
示例: 对于一个名为 sample1 的样本,且在两个通道上进行了测序,FASTQ 文件命名如下:
• Lane 1,Read 1:sample1_S1_L001_R1_001.fastq.gz
• Lane 1,Read 2:sample1_S1_L001_R2_001.fastq.gz
• Lane 2,Read 1:sample1_S1_L002_R1_001.fastq.gz
• Lane 2,Read 2:sample1_S1_L002_R2_001.fastq.gz
如果是从SRA上下载的单细胞数据,会有3-4个fastq文件。如果是3个文件,按后缀名1-3顺序分别代表I1(i7 index),R1(cell barcode & BMI)和R2(真实序列)。如果是4个,则分别是 I1,I2(i5 index),R1和R2 。按照这个顺序改好文件名就可以跑cellranger count流程了。
关于文件目录
命名好fastq文件之后,你可以选择将不同样本的测序文件放在不同的目录,也可以都放在同一个目录下。但是要注意,如果不同样本的fastq在同一个目录,文件名的编号 就需要进行修改。比如放了5个样本在同一个目录下,编号就分别为S1,S2,S3,S4,S5 ,理论上样本名 也要是不同的。否则的话,cellranger会默认编号相同的文件都属于同一个样本。
实战案例
数据检视与预处理
假设我下载了SRR26213698,SRR26213699,SRR26213700三个Run的数据。根据元数据,这三个Run来自同一只小鼠,样本编号为GSM7810377(关于如何使用sra-toolkit下载单细胞数据,详阅上一篇笔记)。 此时,我的当前目录有三个文件夹,每个文件夹下面有4个fastq文件 :
• SRR26213698
• SRR26213698_1.fastq
• SRR26213698_2.fastq
• SRR26213698_3.fastq
• SRR26213698_4.fastq
• SRR26213699
• SRR26213699_1.fastq
• SRR26213699_2.fastq
• SRR26213699_3.fastq
• SRR26213699_4.fastq
• SRR26213700
• SRR26213700_1.fastq
• SRR26213700_2.fastq
• SRR26213700_3.fastq
• SRR26213700_4.fastq
解读fastq文件
看一下fastq的前几行:
head -n 8 SRR26213698_1.fastq
#output
@SRR26213698.1 A00814:455:HHF52DSX2:1:1101:1841:1016 length=10
GTAGCCCTGT
+SRR26213698.1 A00814:455:HHF52DSX2:1:1101:1841:1016 length=10
FFFFFFFFFF
@SRR26213698.2 A00814:455:HHF52DSX2:1:1101:2275:1016 length=10
GTAGCCCTGT
+SRR26213698.2 A00814:455:HHF52DSX2:1:1101:2275:1016 length=10
FFFFFFFFFF
fastq文件是4行一组,每组第一行由@开头 ,代表序列部分的开始,而且第一行还会记录序列的一些技术信息 ,比如:
• SRR26213698.1 序列ID
• A00814 测序仪ID
• 455 运行ID
• HHF52DSX2 Flowcell (流动池) ID
• 1 Lane (通道) ID,即L001
• 1101 Tile (瓷块) 编号
• 1841 Cluster (测序簇) X坐标
• 1016 Cluster (测序簇) Y坐标
• length=10 序列长度,为10个碱基
接下来每组第二行是实际序列 ,如GTAGCCCTGT。第三行以+开头 ,代表质控部分的开始,后面的部分可能是空的,也可能重复第一行的内容。第四行则是Phred分数 ,每一个ASCII字符对应一个碱基。其中“F”代表37分,即小于1/5000的概率读出了错误的碱基,这算是一个非常高的分数。
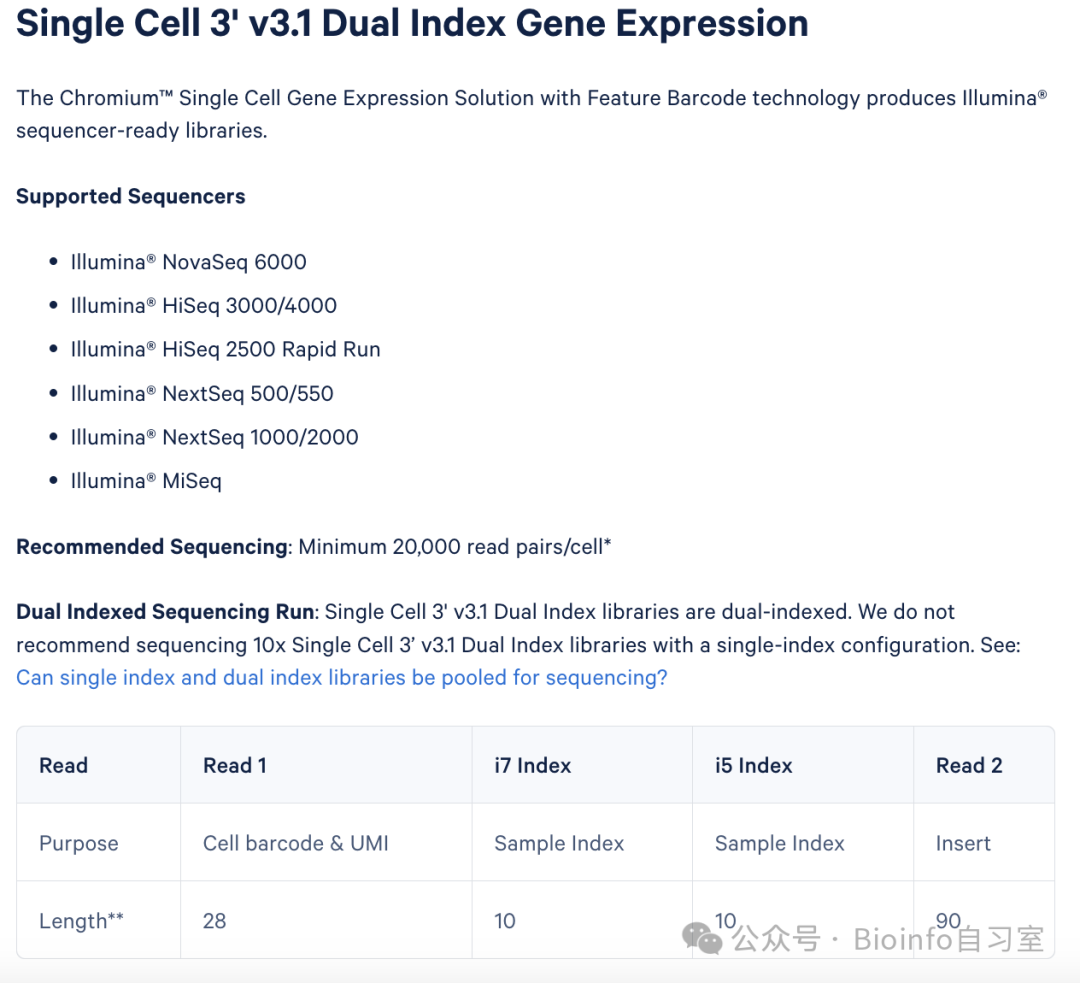
继续检视其他的fastq,可以发现4个fastq文件的单个序列长度分别是是10,10,28,90 ,这跟10x第三代双索引,或者第四代单/双索引的配置是一致的 (见下图),也验证了我们之前的说法,即文件名后缀1-4分别是I1, I2, R1和R2。同时,我们发现SRR26213699, SRR26213700的Lane ID分别是2和3,所以我们可以猜测这是一个生物学样本分在了3个泳道上测序。
 source:
运行流程
按照命名规则改名后,我们把所有fastq文件压缩成.gz然后放到同一个目录下。
• GSM7810381
• GSM7810381_S1_L001_I1_001.fastq.gz (原SRR26213698_1.fastq)
• GSM7810381_S1_L001_I2_001.fastq.gz(原SRR26213698_2.fastq)
• GSM7810381_S1_L001_R1_001.fastq.gz(原SRR26213698_3.fastq)
• GSM7810381_S1_L001_R2_001.fastq.gz(原SRR26213698_4.fastq)
• GSM7810381_S1_L002_I1_001.fastq.gz (原SRR26213699_1.fastq)
• 其他略
接下来就可以跑cellranger count流程了, 代码如下:
cellranger count --id=Pten1 \
--transcriptome=/home/Ref/refdata-gex-GRCm39-2024-A \
--fastqs=/home/PRJNA1022038/GSM7810381 \
--sample=GSM7810381 \
--create-bam=false \
--nosecondary  \
--localcores=24 \
--localmem=200 \
--r1-length=26 \
--output-dir=/home/result
Notes: 加上--r1-length=26的原因是这个样本里的R1序列长度不一致(可能是因为用了不同版本的kit,或者是质控的时候剪切掉了?),cellranger报错,所以统一剪切到26bp了。如果遇到类似的问题,要看一下具体的错误报告提示需要剪切到多长。
这一个样本在24核200G内存的设置下,大概跑了45分钟。具体运行时间需要看服务器配置、文件大小、单/多模组和程序的具体设置。
感谢阅读!如果觉得有用的话,欢迎留言、评论、分享、点赞~下一篇笔记带大家继续了解cellranger multi 和cellranger aggr这两个流程~