上游笔记1:Let's 下载数据!
上游笔记1:Let's 下载数据!
做科研的小伙伴在读paper的时候,可能会有想要获取作者的(基因表达)数据进行复现或是二次分析的时候吧?
通常这个时候我们会在“Data Availability”这个部分找神秘代码 ,比如这篇文章(Pakula et al.)自主产生的数据储存在GEO数据库,编码GSE244267,GSE244269 ,以及GSE248466的地方,同时还用了其他几个公开的数据集,也给出了对应的编码。如果我们想要下载小鼠的单细胞数据,对应GSE244269,应该如何完成呢?
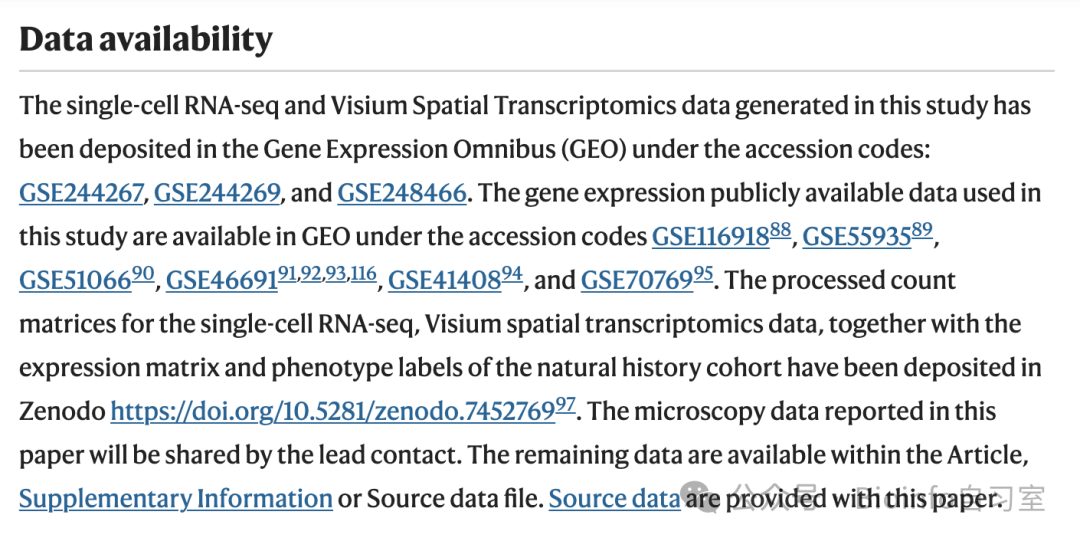 Source: Pakula H, Omar M, Carelli R, Pederzoli F et al. Distinct mesenchymal cell states mediate prostate cancer progression. Nat Commun 2024 Jan 8;15(1):363. PMID: 38191471
一般情况:GEO直接下载表达量矩阵
这串GSE开头的数字代表这组数据在GEO(Gene Expression Omnibus,也就是基因表达数据库) 的编码。一般来讲,文章作者会将经过一定处理的基因表达数据 在GEO上公开(最常见的是各种格式的表达量矩阵,也有直接上传Seurat对象或者Anndata对象的)。这些处理可能包括质控筛选(QC/filtering)、标准化 (Normalization)、缩放 (Scaling)、取对数 (Log-transform) 等等。大多数情况下,表达量矩阵就足够我们进行二次分析了,而且也不会特别大(bulk一般几M-几十M,single-cell可能会有几百M到几G),普通的个人电脑也可以处理。
怎么知道作者上传的数据是什么格式呢? 在页面最下方“Supplemental file”的部分会显示可供下载的数据。我们通过文件后缀可以粗略判断是数据的形式:
• .txt/.csv 很可能是包含基因名和样品名(或细胞barcode)的表达量矩阵。Bulk RNA-seq以这种格式居多,如果是single-cell,很可能是经过处理再单独导出的表达量矩阵。
• .h5 是cellranger流程生成的原始单细胞表达量矩阵。
• .tsv/.mtx 是另一种形式的原始单细胞表达量矩阵。这种格式下一个样本会有三个文件分别储存gene信息、barcode信息和表达量信息。
• .rds 很可能是Seurat对象或者SingleCellExperiment对象,也就是R处理过的单细胞数据。
• .h5ad 很可能是AnnData对象,是Python处理过的单细胞数据。
有些时候,数据的名称也能提供一些信息。以GSE244269 为例,作者在GEO上提供的数据是h5ad 格式的AnnData对象(说明作者很可能是使用scanpy包在Python中分析的),而且仅包括基质 (stromal) 细胞,如下图。
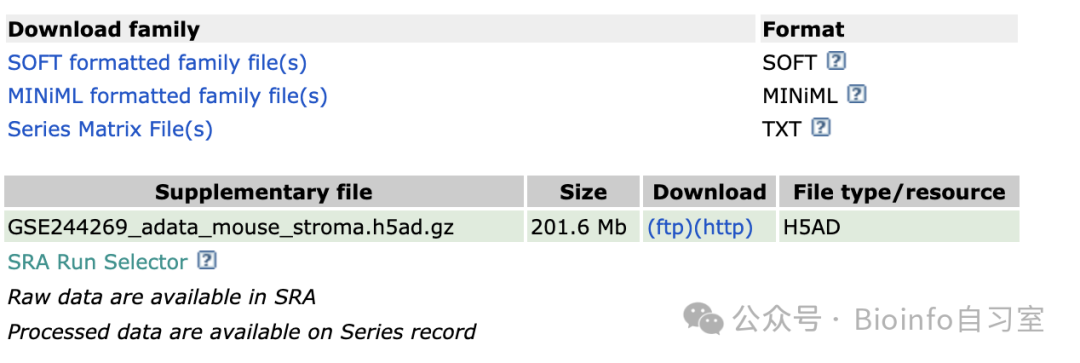
点击Download下的(ftp)或者(http)就可以下载了。
复杂情况:SRA下载原始测序文件(fastq)
当作者没有把表达量矩阵上传到GEO,或者遇到数据损坏、格式问题、不完整,以及其他需要原始数据的情况时也不用太失望,我们还可以通过SRA(Sequence Read Archive,即序列读取档案库) 下载原始的序列数据。
SRA顾名思义,它保存的是 DNA 或 RNA 的原始读取序列(即fastq文件),这些数据不能直接使用 ,需要下载并经过进一步的处理(如质控、比对等)才能用于具体的分析。打个比方,SRA 是原始数据的仓库,GEO 更像是已处理数据的展示平台。
需要注意的是,由于高通量测序一次能产生数以亿计的序列,单个fastq文件一般都以G为单位。不仅文件本身大小吓人、数量多,fastq处理起来也很耗费资源,因此不推荐下载到本地分析处理,最好是使用高性能的云端服务器。
下载安装SRA Toolbox
实际上,SRA中超过一定大小的文件就不能通过浏览器下载了,需要在命令行中通过SRA Toolkit 下载,具体需要用到其中的prefetch 和fastq-dump 命令。
以CentOS系统的服务器为例,下载安装SRA Toolkit的代码如下:
# 转到Home目录,或者其他自定义目录
cd $HOME
# 下载安装包
wget --output-document sratoolkit.tar.gz https://ftp-trace.ncbi.nlm.nih.gov/sra/sdk/current/sratoolkit.current-centos_linux64.tar.gz
# 解压
tar -xzvf sratoolkit.tar.gz
# 将文件加入路径
export PATH=$PATH:$HOME/sratoolkit.3.1.1-centos_linux64/bin
# 确认安装目录
pwd
Mac和Ubuntu系统的用户类似,都可以在终端里输入以上代码安装,只不过需要改一下第一步和第三步的文件名 (即sratoolkit.x.y.z-后面的部分)。M芯片的Mac为mac-arm64, Intel芯片的为mac64,Ubuntu为ubuntu64。Windows用户稍有不同,需要先手动下载安装包,解压,然后使用的打开命令行工具(cmd.exe),转到解压的目录下(比如桌面cd Desktop)。更具体的指引可以参照官方的Wiki。
测试安装
可以通过输入prefetch --version和fastq-dump --version测试是否已正确安装SRA Toolkit. 如果显示prefetch : 3.1.1(fastq-dump类似),则证明已经可以正常使用了。
需要注意的是,如果按照上面的步骤安装之后关掉了terminal或者重启机器了的话,会显示prefetch not found,此时需要再运行一次最后一条代码把软件加入路径:
export PATH=$PATH:$HOME/sratoolkit.3.1.1-centos_linux64/bin
如果想一劳永逸,可以把SRA Toolkit的binary永久加入PATH,具体操作是:
# 打开 .bashrc 或者 .bash_profile
nano ~/.bashrc # 此时会打开一个新页面
export PATH=$PATH:$HOME/sratoolkit.3.1.1-centos_linux64/bin # 复制或输入这条代码
# 完成编辑后,点击Ctrl+X,并点选Y保存
注意如果不是在HOME解压的,需要把$HOME替换成文件夹所在的目录。
获取SRA数据编码
在前面GEO的截图中,我们能看到在页面最底下显示Raw data are available on SRA ,并且提供了一个SRA Run Selector 的链接。点击这个链接就能自动跳转到这个数据集对应的SRA了,如下图:
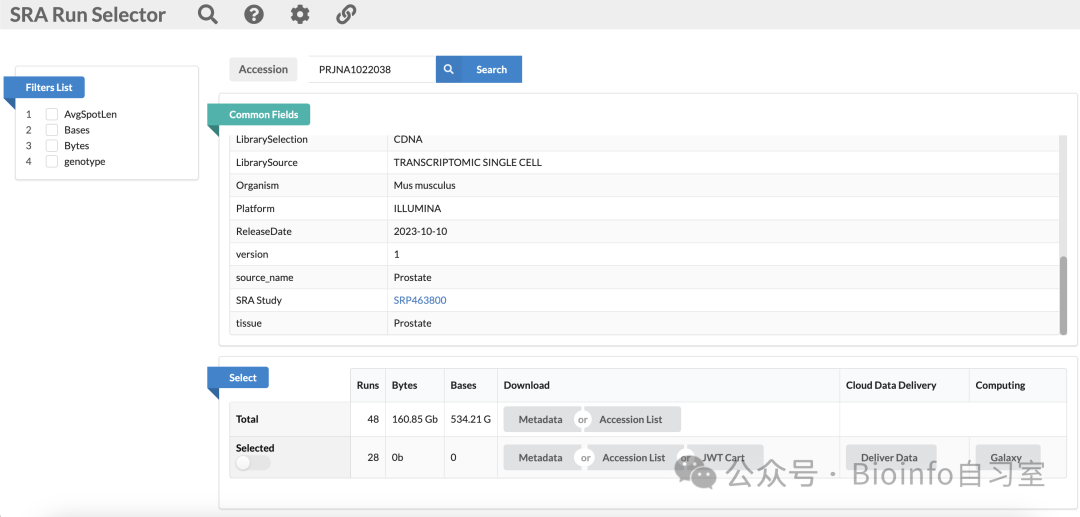
这个dataset有48个fastq文件,对应17个样本。其中只有11个是转基因模型 (Tg),其他6个样本是野生型(littermate或者background) 我们选择转基因模型对应的数据,一共28条数据。点击Selected那一栏的Accession List按钮 下载对应的数据编码,此时我们应该得到一个类似下面的文本文件。
SRR_Acc_List.txt
SRR26213683
SRR26213684
SRR26213685
....
下载fastq文件
从SRA下载文件实际上分成两步:首先用prefetch下载.sra文件,然后才用fastq-dump提取出fastq。话不多说,先上代码:
# 获取单个SRA文件,以SRR26213683为例
prefetch SRR26213683
# 提取对应的fastq文件(传统RNA-seq)

fasterq-dump SRR26213683.sra

# 提取对应的fastq文件(10x平台的单细胞RNA-seq)

fasterq-dump --split-files --include-technical SRR26213683.sra

# 一次性下载所有SRR数据
cat SRR_Acc_List.txt | xargs prefetch
# 用for循环下载对应的fastq(以单细胞为例)
for file in SRR*; do
  fasterq-dump --split-files --include-technical $file
done
下载成功后会有3-4个fastq文件,按1-4顺序分别代表I1(i7 index), I2(i5 index),R1(cell barcode & BMI)和R2(真实序列)。如果少了一个文件,一般是没有I2。注意在下载单细胞数据的时候一定要加上 --include-technical 这个选项,因为SRA默认会把10x的I1/I2和R1当成技术性文件。
那么这期的分享就到这里啦!下一期继续教大家如何跑cellranger流程。敬请期待!