我愿称新Azimuth为最强注释工具
我愿称新Azimuth为最强注释工具
在几个月前的Single Cell Genomics Day(回放见Rahul Satija总结2025单细胞八大发展)中,Satija Lab发布了他们最新的单细胞注释包Pan-Human Azimuth。本篇将聚焦这个新工具,手把手带大家实战~
01
R版安装及运行
⚠️M芯片的苹果电脑使用R包版本会报错,目前暂无解决办法,可以考虑使用Python版。
# github安装
devtools::install_github("satijalab/AzimuthAPI")
library(AzimuthAPI)
# 假设你的Seurat对象叫obj
obj <- CloudAzimuth(obj)

# 注释是在云端进行的,本地内存占用不多
# 注释完成后会返回obj,注释结果存在meta.data中
colnames([email protected])

...
[11] "full_hierarchical_labels"
[14] "final_level_labels"        "final_level_softmax_prob"  "full_consistent_hierarchy"
[17] "azimuth_broad"             "azimuth_medium"            "azimuth_fine"
[20] "azimuth_label"
来进行一个计时(数据集16222个细胞x20262基因,测试平台:Ubuntu 24.04 LTS,2x Intel Xeon E5-2690 v4 + 亮机卡K2200):
timing_result <- system.time({
    obj  <- CloudAzimuth(obj)
})

cat("用户CPU时间:", timing_result["user.self"], "秒\n")
cat("系统CPU时间:", timing_result["sys.self"], "秒\n")
cat("总耗时:", timing_result["elapsed"], "秒\n")

Running Pan-Human Azimuth on the cloud!
Uploading dataset
Uploading file and listening for updates...
File successfully uploaded
Running Pan-Human Azimuth:

Reference model and parameters:
Model name: M0.2
Evaluation batch size: 40960
Extract embeddings: True
Run umap: False
Refine labels in postprocessing: True
Integer counts detected by panhumanpy.ANNotate : False
Log-normalization performed by panhumanpy.ANNotate: False
Query object:
Total number of cells: 16222
Total number of features: 4528
Overlap w. feature reference: 4528 (~89%)

Splitting query data into 1 evaluation batches.

Running model:

  1/507 ━━━━━━━━━━━━━━━━━━━━ 5:09 611ms/step
...
507/507 ━━━━━━━━━━━━━━━━━━━━ 4s 6ms/step
Interpreting label predictions for consistent granularity at broad level.

Interpreting label predictions for consistent granularity at medium level.

Interpreting label predictions for consistent granularity at fine level.

Extracting azimuth embeddings:

  1/507 ━━━━━━━━━━━━━━━━━━━━ 22s 45ms/step
...
507/507 ━━━━━━━━━━━━━━━━━━━━ 2s 3ms/step

An object of class Seurat
4528 features across 16222 samples within 1 assay
Active assay: RNA (4528 features, 0 variable features)
1 layer present: data
1 dimensional reduction calculated: azimuth_embed
R script finished successfully
Output file ready for download
Downloading the output file...

用户CPU时间: 5.724 秒
系统CPU时间: 0.595 秒
总耗时: 100.491 秒
看看注释结果和手动对比,基本上还是准确的(这里只选了azimuth_broad这一档做示例,实际使用的时候一共有三档从粗到细的注释,可以根据需要使用)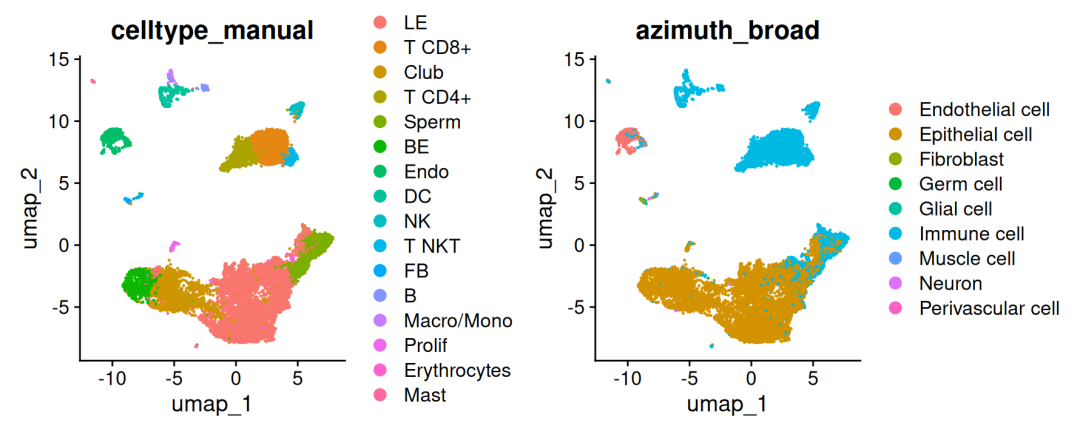 结果示例
还有一个小trick,因为azimuth的注释是单个细胞水平的,可以根据cluster内每个细胞类型数量从高到低排序来协助最终的注释(同样适用于其他细胞水平的注释工具),比如:
library(dplyr)
for(i in levels(obj$seurat_clusters)){
  print(paste("Cluster", i))
  [email protected] %>%
    filter(seurat_clusters == i)%>%
    # 也可以使用其他level的注释
    group_by(final_level_labels)%>%
    summarize(count = n())%>%
    arrange(desc(count))%>%
    head(n =5)%>%
    print()
}

[1] "Cluster 0"
# A tibble: 5 × 2
  final_level_labels                 count
  <chr>                              <int>
1 PIP mammary luminal cell            1035
2 Secretoglobin mammary luminal cell   317
3 Secretory cell                       219
4 CXCL2/3+ surface mucous cell         140
5 MMP7+ basal cell of bladder          137
[1] "Cluster 1"
# A tibble: 5 × 2
  final_level_labels    count
  <chr>                 <int>
1 GZMB CD8 T cell         531
2 Memory CD4 T cell       383
3 KLRB1 CD8 T cell        334
4 Memory CD8 T cell       294
5 GZMK+IL7R+ CD8 T cell   129
[1] "Cluster 2"
# A tibble: 5 × 2
  final_level_labels                 count
  <chr>                              <int>
1 Secretoglobin mammary luminal cell   454
2 PIP mammary luminal cell             314
3 Goblet cell                          176
4 Secretory cell                       129
5 CXCL2/3+ surface mucous cell          94
[1] "Cluster 3"
# A tibble: 5 × 2
  final_level_labels count
  <chr>              <int>
1 Cycling proB cell    140
2 Cycling preB cell    133
3 Secretory cell       127
4 Club cell             99
5 Memory CD8 T cell     99
[1] "Cluster 4"
# A tibble: 5 × 2
  final_level_labels                 count
  <chr>                              <int>
1 PIP mammary luminal cell             481
2 Secretory cell                       133
3 Tuft cell                            108
4 Secretoglobin mammary luminal cell    99
5 Goblet cell                           97
[1] "Cluster 5"
# A tibble: 5 × 2
  final_level_labels count
  <chr>              <int>
1 Memory CD4 T cell    301
2 Treg cell            219
3 CD4 T cell           121
4 Naive CD4 T cell      85
5 Memory CD8 T cell     81
个人感觉对于免疫细胞的注释还是很准确很权威的。需要注意的是他们的参考集是健康人,所以出现结果不符合预期的时候可能需要考虑是否是疾病影响。
02Python(命令行)版安装及运行
R包只支持云端注释,偶尔会不稳定或连接不畅。Python版本可以在命令行或者jupyter notebook中本地运行。注意gpu版本需要cuda,mac目前还不支持。
# (可选) 建议安装到 python 3.9+的单独conda环境中
# conda create -n azimuth python=3.12
# conda activate azimuth

# 基础安装 (CPU only)
pip install git+https://github.com/satijalab/panhumanpy.git

# GPU 支持 (需要cuda,M芯片mac无法安装)
pip install 'git+https://github.com/satijalab/panhumanpy.git#egg=panhumanpy[gpu]'
命令行运行
# 查看选项和帮助
annotate --help

# 进行注释,注意会生成一个新anndata文件obj_ANN.h5ad
annotate obj.h5ad
计个时看看:
time annotate obj.h5ad
使用同样的数据集(16222个细胞 x 20262基因)在两个平台下的测试结果如下(cpu-only)。gpu加速版本有资源的小伙伴可以试试。
# Ubuntu 24.04 LTS, Intel Xeon E5-2690 v4
real    1m20.639s
user    2m57.626s
sys    0m17.212s

# macOS Sequoia 15.5, M4
32.59s user
7.87s system
139% cpu
29.049 total
可以看到速度还是不错的,在老古董服务器上用了1分20秒,mac上只要不到半分钟。对于这种不太大的数据,在本地比在云端要快。
Python运行
也可以选择在python环境里运行。
import panhumanpy as ph
import anndata as ad

# 查看文档(高级版)
help(ph.AzimuthNN)

# 查看文档(基础版)
help(ph.AzimuthNN_base)

# 读取anndata对象(也可以输入路径)
obj = ad.read_h5ad("obj.h5ad")
在jupyter notebook里计个时,不需要计时的小伙伴忽略第一行就可以:
%%time
# 构建AzimuthNN对象
azimuth = ph.AzimuthNN(obj)
# 注释
azimuth.azimuth_refine()

# 提取注释结果
cell_metadata = azimuth.cells_meta
embeddings = azimuth.azimuth_embed()
umap = azimuth.azimuth_umap()

# 包装注释好的anndata
annotated_query = azimuth.pack_adata(save_path="obj_ANN.h5ad")
计时结果:
# Mac
CPU times: user 20.6 s, sys: 3.57 s, total: 24.2 s
Wall time: 16.1 s

# 服务器
CPU times: user 2min 9s, sys: 7.13 s, total: 2min 16s
Wall time: 54.4 s
注意,注释后anndata的结构与原始数据不同:
print("数据形状:", annotated_query.shape)
print("obsm keys:", list(annotated_query.obsm.keys()))
print("obs columns:", annotated_query.obs.columns.tolist()[:10])  # 显示前10个列名

数据形状: (16222, 20262)
obsm keys: ['azimuth_embed', 'azimuth_umap']
obs columns: ['full_hierarchical_labels', 'level_zero_labels', 'final_level_labels', 'final_level_confidence', 'full_consistent_hierarchy', 'orig.ident', 'nCount_RNA', 'nFeature_RNA', 'scDblFinder.score', 'scDblFinder.weighted']
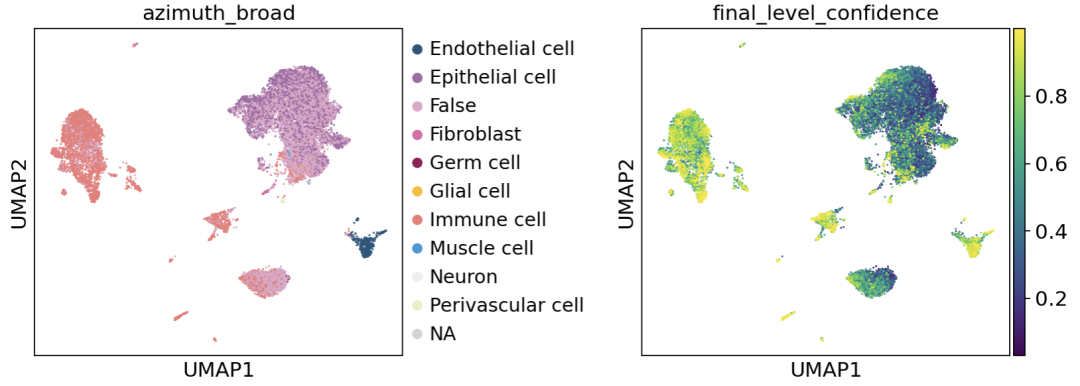
可视化一下:
import scanpy as sc
annotated_query.obsm['X_umap'] = annotated_query.obsm['azimuth_umap']
sc.pl.umap(annotated_query, color=['azimuth_broad','final_level_confidence'],
           ncols=2, wspace=0.5)
03
常见问题解答
最后搬运一下官方FAQ:
支持哪些数据类型?
Pan-human Azimuth基于来自23个人体组织的数据进行训练:脂肪组织、肾上腺、膀胱、血液、骨髓、大脑、乳腺、眼部、肠道、心脏、肾脏、肝脏、肺部、淋巴结、卵巢、胰腺、胎盘、骨骼肌、皮肤、脾脏、胃、睾丸、胸腺
- • 训练数据集包含了单细胞RNA测序(scRNA-seq)和单细胞核RNA测序(snRNA-seq)数据,涵盖了液滴技术、板式技术和组合索引技术等多种实验平台
- • 我们在训练过程中排除了癌症数据集
- • 一般来说,符合上述参数范围的查询数据集都能够通过Pan-Human Azimuth获得良好的注释结果
需要哪些预处理步骤?
- • R接口需要输入Seurat对象,Python接口需要输入AnnData对象
- • 用户应该在注释前进行质量控制(即根据UMI数量和线粒体基因阈值过滤细胞)
- • R用户需要在注释前使用NormalizeData函数进行标准log标准化,具体步骤请参考官方教程
- • Python用户可以在注释前进行标准标准化,或者提供未标准化的整数计数对象(软件包会自动进行标准化)
- • 无需进行可变基因选择(用户应该在注释前保留对象中的所有定量基因)
软件包的输出结果有哪些?
- • full_hierarchical_labels :分层细胞类型注释,包含细胞类型层次结构中多个层级的预测结果。示例:免疫细胞|淋巴细胞|T/NK细胞|T细胞|CD4 T细胞|初始CD4 T细胞
- • final_level_softmax_prob :与分层标签相关的预测概率
- • azimuth_embed :128维细胞嵌入向量,由神经网络编码层生成,用于解码获得注释结果
- • 为了便于解读,我们还对标签进行了后处理,使其更简洁易读,并标准化了不同细胞间的粒度级别。这些类别包括final_level_labels、azimuth_fine、azimuth_medium和azimuth_broad。详细说明请参考我们的官方教程
如何对注释结果进行质量控制?
- • final_level_softmax_prob是一个有用的质量控制指标。我们通常排除得分< 0.5的细胞
- • 没有任何QC指标是完美的,因此我们强烈建议用户为每个定义的细胞群体识别/可视化差异表达基因,作为注释准确性的手动确认。为了协助用户,我们在R API包中提供了make_azimuth_QC_heatmaps函数,并在教程中演示了如何使用
能否使用Pan-Human Azimuth注释疾病数据?
可以。我们经常使用Pan-Human Azimuth来注释疾病数据。在许多(如果不是大多数)情况下,恶性细胞仍然保留了其正常对应细胞分子谱的部分特征。参考映射工作流程(包括Pan-Human Azimuth)被广泛用于将健康和患病细胞注释到一组共同的细胞类型中,然后执行细胞类型内的差异表达分析来识别恶性转变。
然而,Pan-Human Azimuth参考数据集不包含疾病特异性细胞类型。恶性细胞将被映射到最相似的正常细胞类型。上述讨论的QC措施有助于确保恶性细胞的注释对于促进与健康样本的比较和识别疾病特异性特征是有用的。
Pan-Human Azimuth训练数据集不包含癌症样本。肿瘤细胞经常经历重大的分子转化,与正常细胞差异很大,因此可能与Pan-Human Azimuth的映射效果不佳。
对可映射数据集的大小有限制吗?
- • R和Python工作流程都具有高度可扩展性。R工作流程在云端运行,处理速度约为5-10万个细胞/分钟。Python工作流程在标准笔记本电脑上实现类似的可扩展性
- • Pan-Human Azimuth独立注释和嵌入每个细胞,因此可以将大规模数据集分解成块并进行串行映射。我们使用这种策略在不到一天的时间内映射了来自scBaseCamp存储库的超过8000万个细胞
未来版本计划
是的!我们很高兴即将推出新功能,包括:
- • 改进的质量控制 :与softmax概率相比,改进的QC指标将展现更好的校准效果,并捕获层次结构多个级别的不确定性
- • 低质量细胞识别 :在当前版本中,低质量细胞(例如UMI < 100的细胞)主要映射到RNA含量较低的其他细胞类型,包括浆细胞和αβT(入门)细胞。我们正在努力解决这个问题,并在未来明确将这些细胞标记为低质量
- • 更高分辨率的注释 :我们正在继续更新参考数据集,提供更高分辨率的注释,并包含更多最近发现的细胞类型
参考文献
- 1. https://satijalab.org/pan_human_azimuth/
- 2. R版教程:https://satijalab.org/panhuman_r_vignette
- 3. Python版教程:https://github.com/satijalab/panhumanpy/blob/main/tutorial_panhumanpy.ipynb
04
后记
小编之前还发过使用大模型帮助单细胞注释的文章:未来已来:LLM X 单细胞的时代开始了。大家觉得单细胞注释的未来是参考系还是大模型?最好用的注释工具是哪个?欢迎在评论区讨论!想要追更学习笔记,请给我们加一个✨: