别再只知道用rds存单细胞数据了,试试qs!
别再只知道用rds存单细胞数据了,试试qs!
今天聊一个看似无聊但实际上能救命的话题——如何高效存储你的单细胞数据。单细胞数据越来越大了,现在动辄十几万上百万细胞的数据量,就算自己电脑跑得动,但单是储存分析好的Seurat对象就得花不少时间。尤其需要存储多个中间文件的时候,不仅耗时,储存空间也要遭不住了。别怕,今天给大家分享几个小妙招,让你丝滑读写单细胞数据。
01
rds/RData
在R中,最常见的数据存储格式有rds和RData两种,它们都是R原生的序列化格式,其中rds储存单个对象,而RData可以储存多个对象。好处显而易见:没有兼容性问题、不限制对象、不需要额外安装、支持压缩。而且可以直接在RStudio中打开/导入,省去加载的代码。需要给其他人分享数据的时候(包括部分公共数据),一般都默认这种格式。
# 假设obj是你的Seurat对象
# RDS存储
saveRDS(obj,"/path/to/file/seurat_obj.rds")
# RDS读取
obj <- readRDS("/path/to/file/seurat_obj.rds")

# 假设a,b是当前环境中的2个任意对象
# RData存储
save(a, b,"ab.RData")
# RData读取
load("ab.RData")
# 或者直接把整个workspace保存
save.image("my_workspace.RData")
# 重新加载
load("my_workspace.RData")
02
qs/qs2
qs是Quick Serialization的缩写,它是一个R包,专为高效序列化和反序列化R对象而设计。简单来说,它干的事和saveRDS/readRDS一样,但速度快很多很多!.qs和.qs2都不限制对象格式,所以都适用于存储seurat。qs2是qs的升级版,进一步优化了性能并增加了新特性(也为了未来qs的退休做准备)。需要注意的是,qs2和qs是两种不同的格式,不相互兼容。使用起来也很简单,两个包目前都可以直接从CRAN安装:
# qs
install.packages("qs")
library(qs)

# 存储
qsave(obj,"seurat_obj.qs")
# 加载
obj <- qread("seurat_obj.qs")

# qs2也差不多
install.packages("qs2")
# 在mac/linux上,如果需要多线程加速,需要从源码编译
#remotes::install_cran("qs2", type = "source", configure.args = "--with-TBB --with-simd=AVX2")
# apple silicon mac
#remotes::install_cran("qs2", type = "source", configure.args = "--with-TBB")
library(qs2)

# 存储
qs_save(data,"myfile.qs2")
# 加载
data <- qs_read("myfile.qs2")
qs2还可以转换为rds:
# qs2 to rds
qs_to_rds(input_file ="file.qs2", output_file ="file.rds")
qs/qs2到底有多快呢?我们来做个简单的benchmark。这里使用的是一个33万免疫细胞的数据,测试平台是 M4 苹果电脑。
> obj
An object of class Seurat
17109 features across 333291 samples within 1 assay
Active assay: RNA (17109 features,2000 variable features)
3 layers present: counts, data, scale.data
3 dimensional reductions calculated: pca, harmony, umap
在环境中占用18.7GB内存。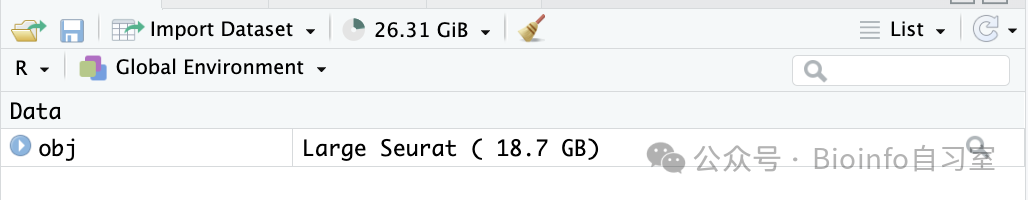 存储时间对比:
# rds,存了371秒,6分多钟
> system.time(saveRDS(obj,"obj.rds"))
   user  system elapsed
367.920  2.701  371.013
# RData表现差不多
> system.time(save(obj, file ="obj.RData"))
   user  system elapsed
369.480  2.405  372.527
# qs整整快了10倍
> system.time(qsave(obj, file ="obj.qs"))
   user  system elapsed
34.139   3.742  37.999
# qs2更快
> system.time(qs_save(obj, file ="obj.qs2"))
   user  system elapsed
24.707   1.686  26.480
加载速度对比:
# rds,读取还是很快的
> system.time(readRDS("obj.rds"))
   user  system elapsed
17.810   1.241  19.051
# RData
> system.time(load("obj.RData"))
   user  system elapsed
17.905   1.190  19.090
# qs
> system.time(qread("obj.qs"))
   user  system elapsed
16.036   1.867  17.900
# qs2
> system.time(qs_read("obj.qs2"))
   user  system elapsed
7.396   0.973   8.368
占用空间对比: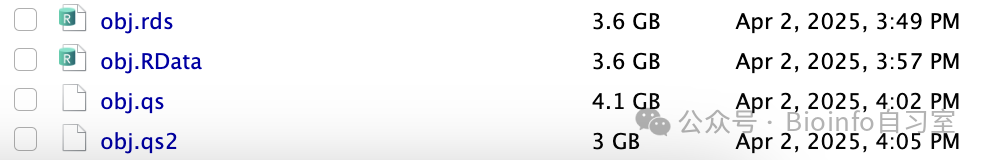
qs2属于是降维打击,在读写速度、占用磁盘空间方面比rds和RData优秀多了。
03
进阶用法
如果想进一步加快存储速度,可以使用多线程加速。如果需要目标文件更小,则需要提高压缩程度。然而压缩程度提高必然会导致读写速度变慢,所以各位小伙伴需要根据具体需求权衡啦!1. 调整压缩级别:
# 最快速度,但文件较大
qsave(obj,"fast_save.qs", preset ="fast")

# 最小文件大小,但速度较"慢" (默认)
qsave(obj,"small_file.qs", preset ="high")

# qs2利用zstd包,通过compress_level改变压缩程度,默认是3
qs_save(obj,"fast_save.qs2", compress_level=1)#更快、更少压缩
qs_save(obj,"small_file.qs2", compress_level=5)#更慢、文件更小
2. 使用多线程加速:
# 使用4线程进行压缩
qsave(obj,"parallel_save.qs", nthreads =4)
qs_save(obj,"parallel_save.qs2", nthreads=4)
3. 减少内存占用(部分读取)虽然qs/qs2能加快R对象的存储/加载速度,但并不支持类似python的部分读取。也就是说,当加载qs文件的时候,整个对象还是会被读取到内存中。如果需要减少内存占用,目前最主流的做法是使用BPCells包,把Seurat对象中占用最大的矩阵留在磁盘上,仅加载需要用于计算的部分到内存中。这部分的具体做法之后有空可以更新一期。(经我自己测试,BPCells和qs包是可以一起用的!)小伙伴们还有什么感兴趣的单细胞“黑科技”?欢迎在评论区交流分享!
- End -