统计自救指南3: 你可能一直没搞懂的p值和t检验
统计自救指南3: 你可能一直没搞懂的p值和t检验
作为做实验的科研人,我们经常要判断一个结果是不是"靠谱"。统计软件会给我们一个神秘的P值 ,但这个数字到底意味着什么?今天,让我们通过最基础的单样本t检验 ,把统计检验的逻辑彻底搞明白。
差异是真实的吗?
你在做Western Blot,检测某个蛋白的表达量。根据以往的经验和文献,这个蛋白的正常表达水平应该是10。但今天你测到的值是12。
问题来了:这个差异是真实存在的,还是实验误差闹的?
这就是统计检验要回答的问题。
建立一个"假想世界"——零假设
要回答这个问题,统计学家们想出了一个巧妙的方法:反证法 。
我们先假设"什么都没发生"——你测到的12,其实就是正常值10上下波动的结果。这个假设叫零假设 (H₀)。
想象一下:如果这个蛋白的真实表达量确实是10,你重复测量1000次会得到什么?由于移液枪的误差、抗体批次差异、曝光时间波动等因素,你会得到一堆围绕10分布的数值——可能是9.8、10.2、9.5、10.7...这些数值形成的分布,就是零假设分布 。
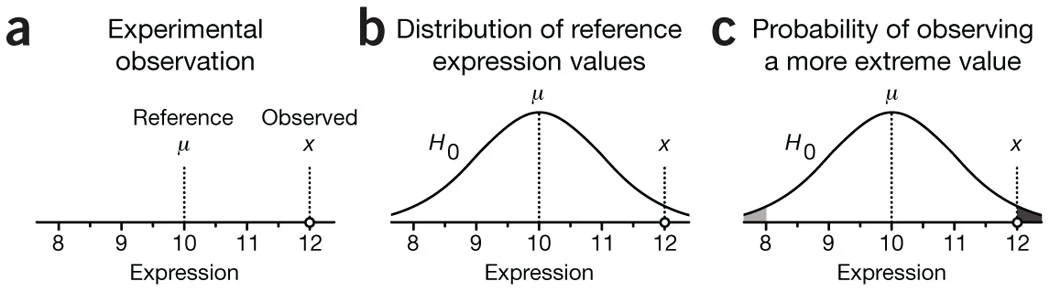 图1 | 统计检验的基本逻辑。(a) 我们的观测值x=12,而已知的参考值是μ=10。(b) 我们假设存在一个“零假设分布”(),这个分布代表了当蛋白真实表达量为10时,所有可能的测量结果。它的中心就是μ。(c) P值的计算方式,就是在这个假设的分布中,找到那些比我们的观测值“更极端”(即距离中心更远)的区域的面积总和。
P值:一个经常被误解的概率
现在关键问题来了:如果蛋白表达真的是10,我们测到12(或更极端的值)的可能性有多大?
这个可能性就是P值。
打个比方:假设一个人声称他投硬币技术很厉害,能控制结果。他投了10次,有9次是正面。如果硬币是公平的(零假设),出现这种极端结果的概率很小(P值很小)。所以我们倾向于相信他可能真的有特殊技巧(拒绝零假设)。
P值最容易踩的坑
坑1:P=0.05意味着零假设只有5%可能是对的?
大错特错! P值是在"假设零假设100%正确"的前提下算出来的。它告诉你的是:如果没有差异,看到这个数据有多意外。而不是"有差异"的概率。
坑2:P值越小,效果越强?
未必! 样本量足够大时,哪怕微小到没有实际意义的差异也能得到极小的P值。比如两种降压药效果只差0.1毫米汞柱,如果测了10000个人,P值可能小于0.001,但这0.1的差异临床上可能毫无意义。
坑3:P >0.05证明没有差异?
不对! "没有证据表明有差异"≠"证明没有差异"。可能只是你的样本量太小,或者实验噪音太大。
坑4:P=0.05是条不可逾越的红线?
太绝对了! P=0.049和P=0.051在证据强度上几乎没区别。把0.05当成真理与谬误的分界线是不科学的。
重复实验:让结论更可靠
单次测量容易"踩雷"。所以我们要重复实验,比如测5次,得到一组数据。
这时候我们用:
- 样本均值 (x̄=10.85)来估计真实表达水平
- 样本标准差 (sx=0.96)来估计数据的"散度"
- 标准误 (sx/√n)来衡量均值的可靠程度
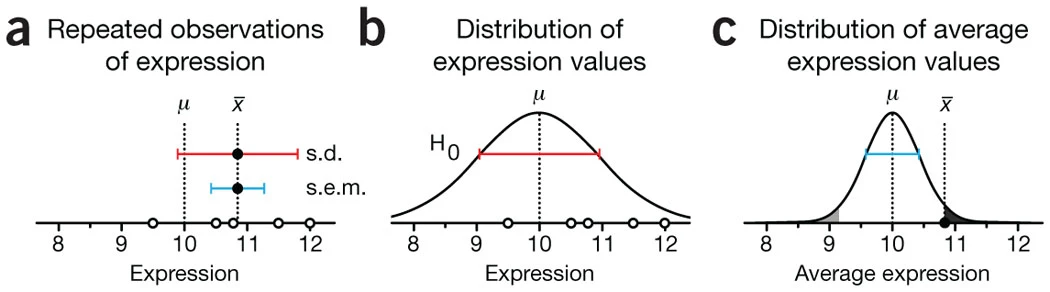 图2 | 使用样本进行统计检验。(a) 我们进行了n=5次独立重复实验,计算出样本均值()和标准差()。(b) 我们假设零假设分布是一个正态分布,其标准差可以用我们样本的来估计。(c) 我们真正用来计算P值的是“样本均值的抽样分布”,它的标准差是标准误(s.e.m.)。P值就是观测到的样本均值()在这个抽样分布上的极端区域面积。
t值:差异的"标准化得分"
为了统一比较,我们算一个标准化的指标——t值 :
t = (样本均值 - 参考值) / 标准误
  = (x̄ - μ) / (sx/√n)
通俗解释: t值告诉你,观察到的差异是"正常波动幅度"的几倍。t=2意味着差异达到了2个标准误那么大。
为什么要用t分布而不是正态分布?
这里有个有趣的故事。20世纪初,一位在爱尔兰健力士啤酒厂工作的化学家戈塞特发现了一个问题:当样本很小时,用正态分布会"过于乐观"。
原因很简单: 小样本的标准差往往低估 真实的变异程度。就像你只采访了5个人就想推测全国人的平均身高,很可能碰巧这5个人身高都比较接近,从而低估了人群身高的真实差异。
为了补偿这种低估,戈塞特(笔名"Student")提出了t分布 ——它长得像正态分布,但"尾巴更肥"。
"肥尾巴"的含义
t分布认为极端值出现的可能性比正态分布更大。这是一种保守的做法——宁可错过一些真实的差异,也不要误报不存在的差异。
实际影响举例:
- 用t分布:t=1.98,P=0.119(不显著)
- 错用正态分布:t=1.98,P=0.048(显著)
看到区别了吗?不用t分布可能让你得出错误的"显著"结论!
样本量的影响
t分布的形状由自由度 (degrees of freedom, d.f. = n-1)决定:
- 样本量小(如n=5)→ t分布"尾巴很肥" → 需要更强的证据才能达到显著
- 样本量大(如n>30)→ t分布接近正态分布 → 因为大样本的标准差估计更准确
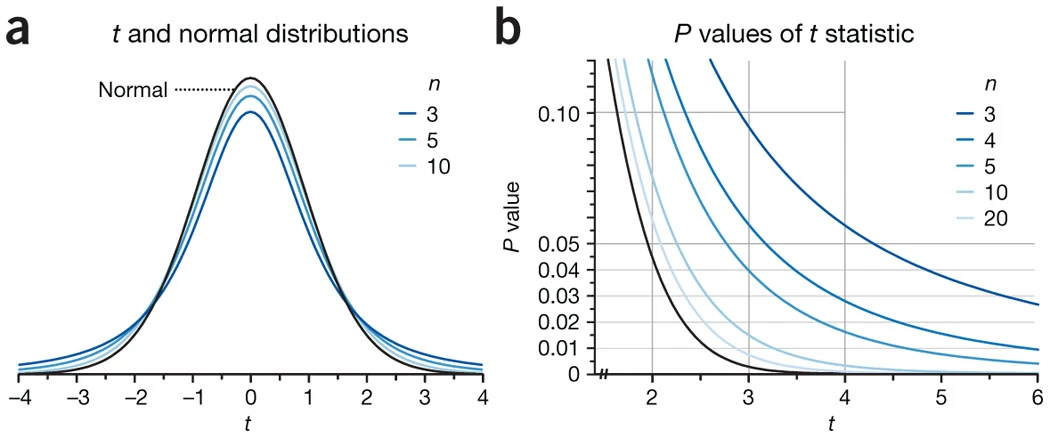 图3 | t分布与正态分布。(a) t分布的尾部比标准正态分布更高更厚,这说明它认为极端值出现的可能性更大。t分布的形态由样本量n(确切地说是自由度n-1)决定,n越大,t分布越接近正态分布。(b) t值与P值的关系。对于同一个t值,在样本量n较小时,其对应的P值会比n较大时或正态分布给出的P值更大(即更不显著)。
置信区间:换个角度看问题
除了P值,我们还可以问:什么范围内的参考值与我们的数据"相容"?
这就是95%置信区间。比如算出[9.66, 12.04],意思是:
- 如果真实值在9.66到12.04之间,我们的样本就不会显示"显著差异"
- 这个区间告诉你效应可能的大小范围,比单纯的"显著/不显著"信息量更大
实际应用小贴士
什么时候用单样本t检验?
- 比较样本均值与已知标准值
- 检验产品质量是否达标
- 验证实验方法的准确性
- 评估基因表达是否偏离正常水平
使用前提条件
- 数据应近似正态分布 (小样本时尤其重要)
- 观测值相互独立 (不是重复测量同一个样品)
- 有明确的参考值 (来自文献、标准或对照组)
报告结果的规范写法
❌ 错误:"P<0.05,结果显著,证明了我们的假设"
✅ 正确:"与参考值(μ=10)相比,我们观察到显著的表达差异(mean=10.85, SD=0.96, n=5, t=1.98, P=0.119),但该差异未达到统计显著水平(α=0.05)"
写在最后
单样本t检验是统计推断的入门功课,但它包含的思想贯穿整个统计学:
- 用反证法思考 (零假设)
- 量化不确定性 (P值)
- 考虑样本量的影响 (t分布)
- 区分统计显著和实际意义
记住:P值是工具,不是目标 。真正重要的是理解你的数据在告诉你什么生物学故事。
统计显著 ≠ 生物学重要
大样本 ≠ 好研究
P < 0.05 ≠ 真理
保持批判性思维,让统计为科学服务,而不是被统计绑架。
参考文献:
Krzywinski, M. & Altman, N. (2013). Points of significance: Significance, P values and t-tests. Nature Methods , 10(11), 1041-1042.