统计自救指南1: 拥抱不确定性
统计自救指南1: 拥抱不确定性
前段时间更新qPCR小工具(详见qPCR工具更新!),发现我之前犯了个错误(也就是在非正态分布的fold change上做ANOVA)。在更正的同时,我也重新开始重视科研中常常容易被忽略、混淆的一些统计学概念——统计自救指南 这个系列就这么诞生了。作为第一个主题,我们来聊聊不确定性(uncertainty) 。
做过实验的你,一定有过这样的灵魂拷问:
- 为什么我严格重复了三次 qRT-PCR,每次的 Ct 值都不完全一样?
- 为什么我的两个生物学重复样本,测序回来一看,基因表达量差异那么大?
- 我根据测序结果说这个基因“上调”,这个结论到底有多可靠?
这一切的背后,都指向一个幽灵——随机性 。而统计学,就是我们驯服这个幽灵的唯一工具。它不告诉我们“对”或“错”,而是告诉我们**“犯错的可能性有多大”** 。
这篇推文改编自 Nature Methods 的经典科普系列 Points of Significance ,希望能用最通俗的语言,帮你建立起在生物信息分析中至关重要的统计学思维。
你的科研直觉,真的靠谱吗?
在深入统计学之前,我们先玩个游戏,体验一下我们的大脑在概率面前有多么“不堪一击”。
三门问题 (The Monty Hall Problem)
- 舞台上有三扇门,一扇门后是跑车,另两扇门后是山羊。
- 你选择了 1号门 (此时你中奖的概率是 1/3)。
- 主持人知道车在哪。他打开了 3号门 ,后面是山羊,以此帮你排除一个错误答案。
- 现在,主持人给你一次机会:你是坚持选择1号门,还是换到剩下的 2号门 ?
你的第一反应是什么?是不是觉得剩下两扇门,选哪个都一样,概率都是 50%?
然而正确答案是:果断换!换到2号门,你中奖的概率会从 1/3 飙升到 2/3!
是不是有点反直觉?当年这个答案发表时,甚至引来了数千名读者(包括许多博士)的激烈反对。这个小小的例子血淋淋地告诉我们:面对不确定性,直觉往往会欺骗我们 。在处理复杂的生物学数据时,我们就更需要统计学这个“外挂”来指导决策。
统计学的两大世界:描述与推断
简单来说,统计学可以分为两个领域:
描述性统计 (Descriptive Statistics)
- 任务 :专注“总结”。用几个关键指标,比如均值(Mean) 和标准差(Standard Deviation) ,来描绘一份数据的全貌。
- 例子 :计算你10个样本中,某个基因的平均表达量和表达量的波动范围。
推断性统计 (Inferential Statistics)
- 任务 :专注“推测”。从你手头有限的数据(样本)出发,去推断更大范围(总体)的情况。
- 例子 :根据你10个肝癌病人的测序数据,推断某个基因在所有 肝癌病人中的表达规律。这正是我们科学研究的核心目标。
而连接这两个世界的桥梁,就是抽样(Sampling) 。
从“总体”到“样本”:管中窥豹的艺术
要理解推断,必须先搞懂两个核心概念:总体 和样本 。
- 总体 (Population):我们研究的** 所有**对象的集合。例如,全世界所有正常人的肝脏细胞、某个物种的所有可能的基因转录本。总体有其“真实”的参数,但往往无法直接测量,比如:
- **总体均值 ** :描述总体的平均水平。
- **总体标准差 ** :描述总体中个体间的差异大小。
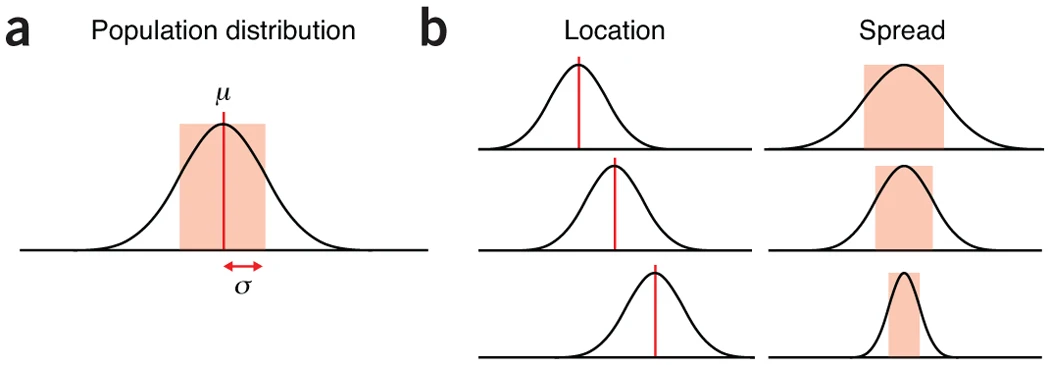 Figure 1
图1解说 :(a) 假设这就是某个基因在所有 细胞中的表达量分布,红线是它的真实平均值 。(b) 决定了分布的“位置”,而 决定了分布的“胖瘦”程度。
- 样本 (Sample) :我们从总体中实际观测到的一小部分数据。例如,你测序的3个重复样本、你在显微镜下观察的100个细胞。样本也有对应的统计量:
- **样本均值 ** (读作 X-bar)
- **样本标准差 **
我们所有分析的起点,就是用样本的 和 去估计 总体的 和 。
❗️关键点 :要想让这个“估计”靠谱,你的样本必须对总体有代表性 。最常用的方法就是随机抽样 ,确保总体里每个成员都有平等的机会被你抽中。一个有偏的选择(比如只挑长得好的细胞)会让你的所有结论都偏离真相。
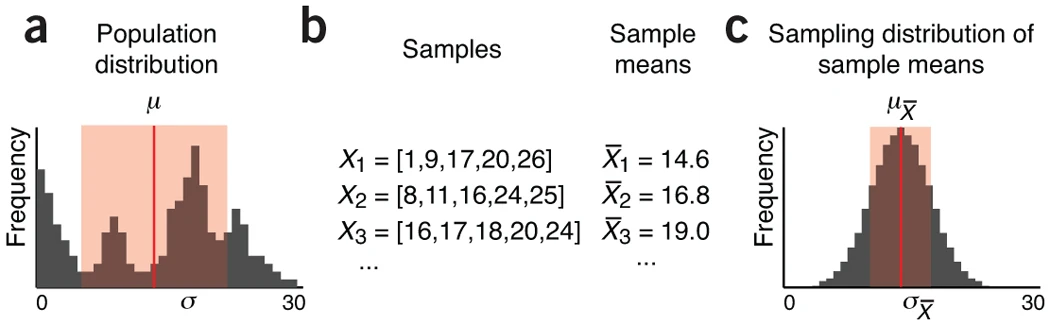 Figure 2
图2解说 :(a) 这是一个我们无法完全观测的总体分布。(b) 我们从里面随机抽取了三个不同的样本(),每个样本都计算出一个自己的样本均值。(c) 如果我们能把所有可能 的样本均值都收集起来,它们的分布就构成了“样本均值的抽样分布”。
统计学的“神之定理”:中心极限定理
你可能会想,我的样本千奇百怪,用它来推断总体,心里很没底啊! 别怕,统计学里最重要、最神奇的定理之一——中心极限定理 (Central Limit Theorem, CLT) 来给你“撑腰”了。
CLT的核心思想 :
不管你的“总体”长什么样(无论是正态、均匀还是奇形怪状),只要你抽的样本量 足够大,那么无数个“样本均值”汇集起来的分布,一定会趋近于一个正态分布 (就是那个经典的钟形曲线)。
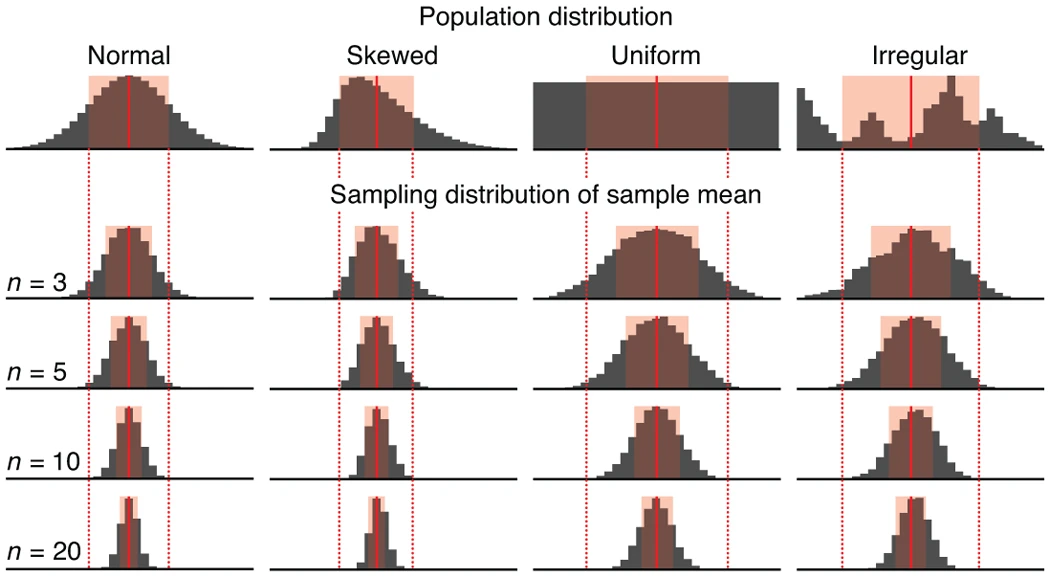 Figure 3
图3解说 :即使原始的总体分布是偏态、均匀甚至不规则的,只要样本量 逐渐增大(从3到20),样本均值的分布(下面几行)都越来越像一个标准的“正态分布”。
CLT还告诉我们这个“样本均值分布”的两个关键参数:
- 它的均值 就等于总体均值 。
- 它的标准差 。
这个 有个更响亮的名字,叫标准误差 (Standard Error of the Mean, SEM) 。
标准差 (SD) vs. 标准误差 (SEM):你真的分得清吗?
这是无数科研人混淆的重灾区,我们必须把它掰扯清楚:
标准差 (Standard Deviation, SD, 符号 )
- 描述的是 :你数据本身的离散程度。
- 回答的问题是 :“我的生物学重复样本之间,数值波动有多大?”
- 用途 :主要用于描述性统计,告诉你数据的分布胖瘦。
标准误差 (Standard Error of the Mean, SEM, 符号 )
- 描述的是 :你计算出的样本均值 ,距离真实的总体均值 可能有多远。换句话说,它衡量的是你估计的精度 。
- 回答的问题是 :“我这次实验算出来的平均值,有多大把握接近真实世界的平均值?”
- 用途 :主要用于推断性统计,常用于图表中的误差棒 (Error Bar),展示均值的置信度。
简单总结:SD描述数据,SEM描述均值的精度。
精度的代价:为什么说“大力不一定出奇迹”
从标准误差的公式 中,我们能发现一个残酷的真相:
样本量 的增加,对提升精度的效果是开根号的,也就是边际效益递减。
举个例子 :你花了很大力气,把生物学重复从3个增加到了6个,样本量翻了一倍。但你的估计精度(以SEM衡量)只提升到原来的 。
要想让你的精度翻一倍(SEM减半),你需要把样本量增加到原来的四倍! (例如,从3个重复增加到12个!)
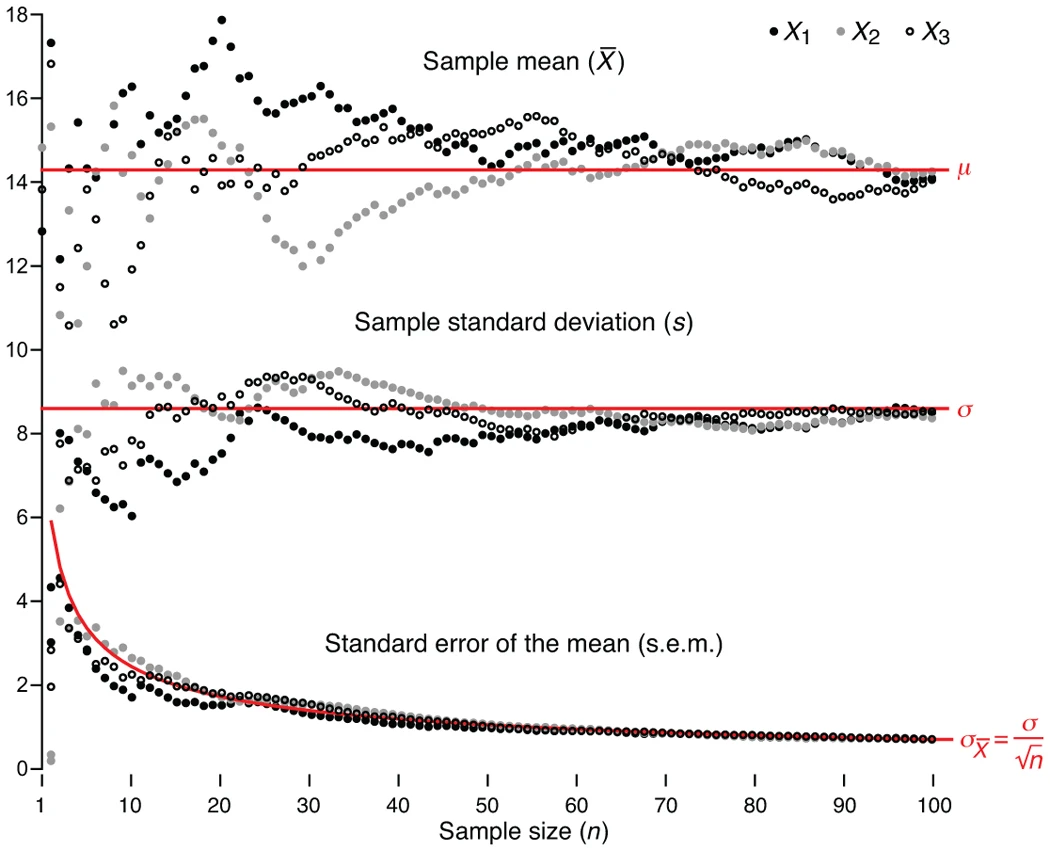 Figure 4
图4解说 :随着样本量 的增加,样本均值(,上方曲线)和样本标准差(,中间曲线)会逐渐收敛并稳定在总体真实值(红线)附近。而标准误差(s.e.m.,下方曲线)则会随着 的规律持续下降,但下降速度越来越慢。
这个 规则,是我们在设计实验、考虑要测多少样本时,必须牢记的“性价比”法则。
课代表总结
统计学不是一堆复杂的公式,而是一种思维方式。在处理高通量数据时,请记住:
拥抱不确定性 :永远不要把你的测量值(比如某个基因的TPM=150)看作一个绝对真理。它只是一个估计值 。承认并量化不确定性,是科学精神的体现。
警惕小样本 :当生物学重复很少时(比如只有n=2或3),你的样本均值可能离真实情况很远。在解释结论时,一定要保持谨慎。
理解精度的成本 :在追求更高统计功效时,要权衡增加样本量带来的成本和实际的精度提升。 决定了“大力”不一定能出“奇迹”。
区分SD与SEM :在阅读文献或绘制图表时,明确图中的误差棒代表的是SD还是SEM。前者展示数据波动,后者展示均值精度,含义天差地别。
我们的目标,不是消灭不确定性,而是科学地量化和管理它 。理解了今天的内容,你就已经迈出了从“数据分析员”到“数据科学家”的关键一步。
下期预告 :我们将继续深入,探讨如何用置信区间 (Confidence Intervals) 来更直观地界定不确定性,以及误差棒 (Error Bars) 的正确画法与解读。敬请期待!
参考文献 : Krzywinski, M. & Altman, N. Importance of being uncertain. Nature Methods 10, 809-810 (2013).