统计自救指南2: “耍流氓”的误差线
统计自救指南2: “耍流氓”的误差线
hello,各位奋斗在科研一线的伙伴们!
每次看文献,是不是总被各种图表上那些上下舞动的“小胡须”搞得有点晕?它们时而重叠,时而分离,仿佛在诉说着数据的秘密。这些“小胡须”就是我们今天的主角——误差线(Error Bars) 。
你可能会觉得:“这不就是表示个误差范围嘛,很简单。” 先别急着下结论,来看一个扎心的事实。
一个让22%科研人“社死”的提问
Nature Methods 曾向一群科研人员提问:
“两组数据的误差线要分开多远,才能说明它们的差异具有统计学意义(例如 P = 0.05)?”
结果令人大跌眼镜:只有22%的受访者给出的答案在正确范围的2倍以内 。
这个结果说明,我们中绝大多数人,每天都在看、甚至在画的误差线,可能一直都理解错了 。这种误解不仅令人沮丧,甚至可能导向错误的科学结论。
三张图,看起来一模一样,P值却天差地别?
请看下面这三组比较,它们的误差线长度相同,并且刚好首尾相接。你会不会觉得它们的统计显著性也差不多?
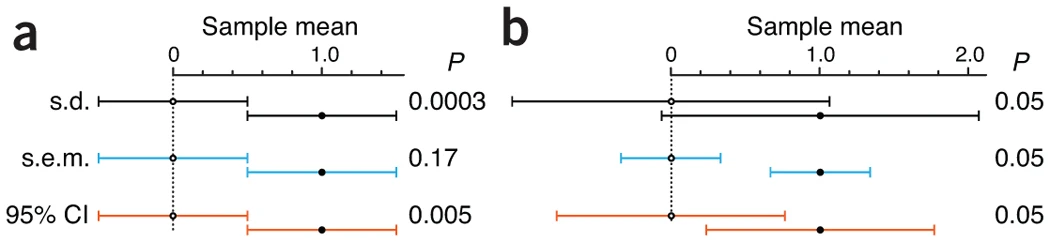
图1 :当s.d., s.e.m., 95% CI三种误差线被画成同样长度且刚好接触时,其背后的统计学意义截然不同。
然而真相是:
- 如果这是 s.d. (标准差) 误差线,P值 ≈ 0.0003 (差异显著)
- 如果这是 s.e.m. (标准误) 误差线,P值 ≈ 0.17 (差异不显著)
- 如果这是 95% CI (置信区间) 误差线,P值 ≈ 0.005 (差异显著)
是不是有点颠覆三观?这就是问题的关键:不说明类型的误差线,都是在“耍流氓”!
那么,这三种误差线到底有何不同?
误差线的“三副面孔”
让我们来逐一揭开它们的面纱。
1. 标准差 (Standard Deviation, s.d.)
- 用途概括 :数据分布的“胖瘦指标” 。
- 回答的问题 :“我的数据有多离散?如果我再取一个新样本,它有可能会落在哪个范围内?”
- 核心特点 :s.d.反映的是数据本身的离散程度。只要你的样本来源于同一个总体,无论你增加多少样本量(n),s.d. 都会趋于一个稳定值 。
- 使用场景 :当你想展示数据的原始变异程度,或者强调两组数据的分布差异时(比如一组数据很集中,另一组很分散)。
2. 标准误 (Standard Error of the Mean, s.e.m.)
- 用途概括 :样本均值的“精准度标尺” 。
- 回答的问题 :“我对‘平均值’这个估计有多大把握?如果我重新做N次实验,新得到的平均值们会离现在这个平均值有多远?”
- 核心特点 :s.e.m. 体现的是样本均值的不确定性,它会随着样本量n的增加而减小 。公式是: 。样本量越大,均值越准,s.e.m.越小 。
- 使用场景 :这是生物学论文中最常见的误差线之一,用于比较不同组之间均值的差异。
3. 95% 置信区间 (Confidence Interval, CI)
- 用途概括 :总体真值的“捕捞网” 。
- 回答的问题 :“我用这次样本数据张开了一张网,我有95%的信心,总体的真实平均值(那个我们永远无法直接测量的真理)被我这张网捕获了。”
- 核心特点 :95% CI 提供了一个“靠谱”的区间估计。在多次重复实验中,95%的实验所计算出的CI区间会包含总体的真实均值。它比s.e.m.更直观,在医学研究中非常流行。
- 使用场景 :当你需要提供一个关于总体参数(如平均值)的、具有特定置信水平的区间估计时。
随着样本量n的增加,s.e.m. 和 95% CI 都会变窄,代表我们的估计越来越精确。而s.d.则保持稳定。
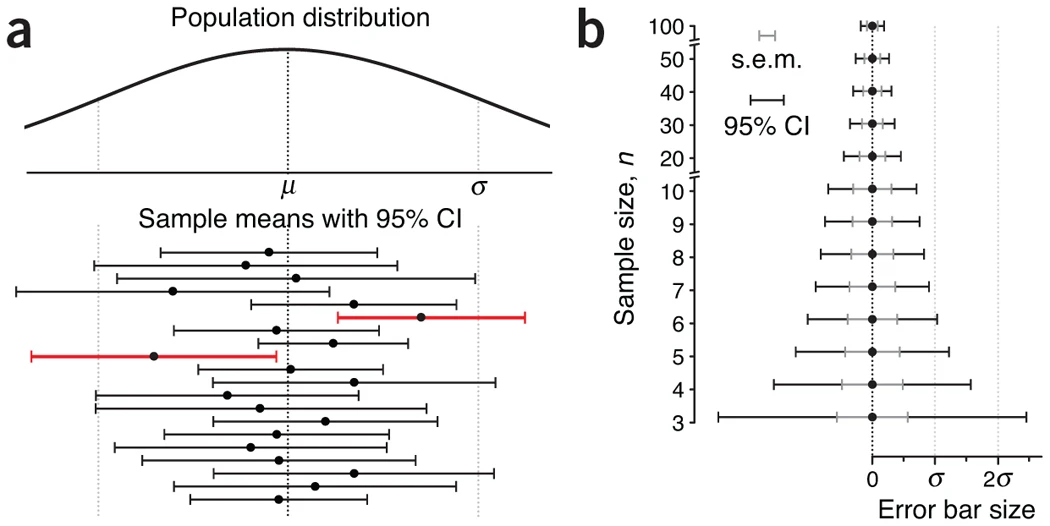
图2 :样本量越大,s.e.m.和95% CI误差线越窄。
破除核心误解:重叠 ≠ 不显著!
这是关于误差线最普遍、也是最致命的误区。请把下面的结论刻在DNA里:
错误观念 :“误差线不重叠 = 差异显著”
错误观念 :“误差线重叠 = 差异不显著”
重叠和显著性的关系,完全取决于误差线的类型!
让我们用一些事实来强化记忆:
- 当两组数据的 s.e.m. 误差线刚好接触 时,P值 ≈ 0.17 ,远未达到0.05的显著标准!
- 要使P值 ≈ 0.05 ,两组数据的 s.e.m. 误差线之间,需要有大约一个s.e.m.臂长一半的空隙 。
再来看看更“反常识”的95% CI:
- 当两个 95% CI 误差线刚好接触 时,P值 ≈ 0.005 ,说明差异是高度显著 的!
- 两个 95% CI 误差线甚至可以重叠其臂长的25%(即总长度的50%),P值依然在** 0.05**左右,差异仍然显著!
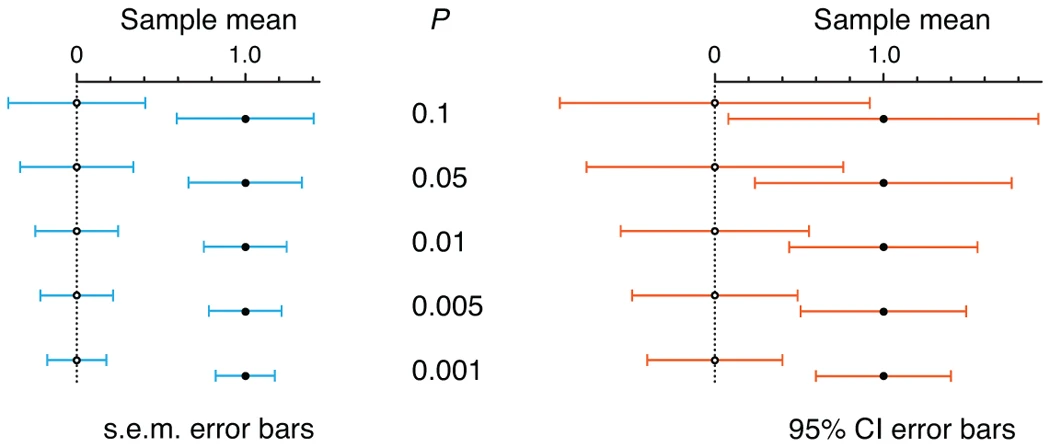
图3 :在不同的P值下,s.e.m.和95% CI误差线的相对位置。注意看P=0.05那一行,s.e.m.需要分开,而95% CI是重叠的。
实际应用中,我该如何选择和解读?
1. 作图三问:我该用哪种误差线?
问题一:我想展示数据的离散程度吗?
- 是的,我想告诉读者原始数据有多“散”。--> 选择 s.d.
问题二:我想比较两组的均值,并体现均值的精度吗?
- 是的,这是我的核心目的。--> 选择 s.e.m. (生物学常规) 或 95% CI (更直观,推荐)。
问题三:我想给出一个总体均值的“靠谱范围”吗?
- 是的,我希望读者对真值可能在哪里有个清晰的认识。--> 选择 95% CI 。
2. 快速换算:记住两个近似法则
在很多情况下,你可以根据s.e.m.快速估算95% CI的宽度:
- 对于小样本 (n=3) : 95% CI: approx 4 times s.e.m.
- 对于大样本 (n > 15): 95% CI approx 2 times s.e.m.
3. 避开陷阱:小样本量要当心!
当样本量极小(例如 n=3)时,计算出的误差线非常不稳定。此时,任何误差线都可能产生误导。
这种时候,最好直接展示所有的数据点(例如使用散点图) ,而不是用一个均值和误差线来粗暴地概括它们。
让数据“说实话”
误差线,绝不仅仅是图表上可有可无的装饰。它承载着关键的统计信息,是我们判断数据可靠性的重要窗口。
下次你再看到或绘制误差线时,请务必记住三件事:
- 先看图例 :它到底是s.d., s.e.m., 还是CI?这会完全改变你对图的解读。
- 明确标注 :在你自己的图中,必须清楚地说明误差线的类型和样本量n。
- 谨慎判断 :别再用“是否重叠”来草率地判断显著性了。
好的科学可视化,不是让图看起来“漂亮”,而是让数据“诚实”。
给审稿人回信的小技巧: 如果审稿人质疑:“你的95% CI误差线都重叠了,为什么还说差异显著?”
现在,你可以自信地引用这篇 Nature Methods 的文章,并优雅地向他解释其中的统计学原理了。
参考文献: Krzywinski, M., & Altman, N. (2013). Error bars. Nature Methods , 10(10), 921-922.
Bioinfo自习室交流群欢迎大家加入。如遇二维码失效等情况,可以添加小编(微信号:mianapop)拉您入群。