跟着Theis Lab学单细胞: 高维数据的"降维打击
跟着Theis Lab学单细胞: 高维数据的"降维打击"
单细胞最佳实践
降维分析
本章导读 SECTION PREVIEW
1. 理解"维度诅咒"及其对单细胞分析的影响
2. 掌握PCA、t-SNE、UMAP三种降维方法的原理和特点
3. 实战:使用scanpy进行降维分析和可视化
4. 学会通过降维图检查数据质量
本节对应原书 9 Dimension Reduction
单细胞RNA测序数据的一个显著特点是维度极高:每个细胞可能有2-3万个基因的表达信息。虽然我们在上一章通过特征选择筛掉了大部分"平庸"的基因,但剩下的几千个基因依然让数据处在高维空间中。今天我们来学习如何通过降维技术,将这些高维数据压缩到2-3个维度,既保留关键信息,又便于可视化分析。
01
高维数据的“诅咒”
"维度诅咒"的困扰
早在1957年,数学家贝尔曼就提出了"维度诅咒"(Curse of Dimensionality)这个概念。这个听起来很玄学的术语,其实描述了一个很现实的问题:
理论上,高维数据包含更多信息,但实际上并非如此 。高维数据往往包含更多噪音和冗余信息,增加维度反而不利于下游分析。
在单细胞数据中,这个问题尤为突出:
- • 并非所有基因都对细胞类型分类有用
- • 基因间存在共表达关系,信息有冗余
- • 高维空间中的距离计算变得不可靠
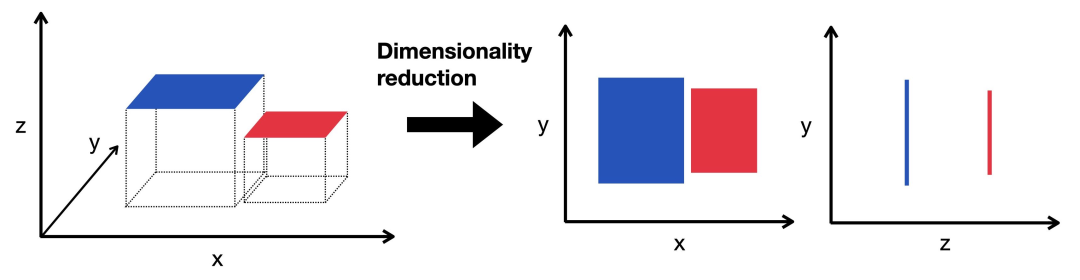 降维分析的图示
降维的目标
降维的本质是将高维数据嵌入到低维空间中,同时:
- • 保留数据的内在结构 :细胞间的相似性关系不变
- • 去除冗余信息 :压缩数据,提高计算效率
- • 便于可视化 :人类最容易理解2D和3D图形
就像将一个立体的雕塑拍成照片,我们希望从不同角度找到最能展现雕塑特征的那个视角。
02
主流的降维方法
最近一篇比较研究(Xing et al., 2021)发现,t-SNE在综合性能上表现最佳,UMAP在稳定性上最优,而PCA虽然简单但仍有其独特价值。接下来让我们逐一了解这三种方法。
PCA:线性降维的经典
原理简述
主成分分析(PCA)通过正交变换,将原始基因表达数据转换为一组线性无关的主成分(Principal Components, PCs)。这些主成分按方差大小排序,前几个主成分包含了数据的主要变异信息。
优势
- • 计算效率高,结果可解释性强
- • 主成分有明确的生物学含义
- • 通常用于后续分析的输入(选择前10-50个PC)
局限性
由于单细胞数据稀疏且具有高度非线性特征(想想dropout现象),PCA这种线性方法在可视化方面效果有限。但它仍是后续非线性降维的重要预处理步骤。
t-SNE:非线性降维的明星
原理简述
t-SNE是基于图的非线性降维技术,能将高维数据投影到2D或3D空间。它的核心思想是:
- 1. 在高维空间中,用高斯分布描述数据点间的相似性
- 2. 在低维空间中,用t分布重建这种相似性关系
- 3. 通过梯度下降优化,使两个空间的相似性分布尽可能接近
特点
- • 擅长保留局部结构,能很好地分离不同的细胞群
- • 可视化效果出色,是发表论文的热门选择
UMAP:新兴的强力竞争者
原理简述
UMAP同样是基于图的非线性降维技术,与t-SNE原理相似。它先构建高维数据的图表示,然后优化低维图,使其在结构上尽可能与原始图相似。
特点
- • 在保留全局结构 方面比t-SNE更优秀
- • 计算速度通常比t-SNE更快
- • 稳定性更好,重复运行结果更一致
研究表明,如果参数选择合适,t-SNE和UMAP的效果非常接近,都是单细胞分析的优秀选择。(但是由于umap在计算速度和内存占用上的优势,目前用的更广泛)
🔬 小编注:新兴的降维方法
PHATE :基于扩散模型的降维方法,通过模拟数据在流形上的扩散过程来学习细胞间的转换关系。相比t-SNE和UMAP,PHATE在保留全局结构和连续性方面表现更佳,特别适合拟时序分析和发育轨迹推断。
基于NMF的方法 :将基因表达矩阵分解为基因程序和细胞权重的乘积,每个因子都有明确的生物学解释,在识别基因模块和细胞状态方面具有天然优势。
大模型embedding方法 :利用预训练的深度学习模型(如scGPT、Geneformer等)将细胞表达谱映射到高质量的embedding空间,这些方法融合了大量先验生物学知识,在跨数据集泛化和生物学可解释性方面显示出巨大潜力。
03
实战:scanpy降维分析
环境准备
import scanpy as sc

sc.settings.verbosity = 0
sc.settings.set_figure_params(
    dpi=80,
    facecolor="white",
    frameon=False,
)
加载数据
本期实战的数据来自上一篇:跟着Theis Lab学单细胞: 特征并非“生而平等”。当然,读者朋友也可以见文末获取示例数据。
# 加载特征选择后的数据
adata = sc.read(
    filename="s4d8_feature_selection.h5ad",
    backup_url="https://figshare.com/ndownloader/files/40016014",
)

# 使用log标准化后的数据进行降维
adata.X = adata.layers["log1p_norm"]

# 设置高变异基因标记(用于PCA)
adata.var["highly_variable"] = adata.var["highly_deviant"]
注意:降维和可视化使用标准化后的数据(log1p变换)。
PCA
# 计算PCA,只使用高偏差基因
sc.pp.pca(adata, svd_solver="arpack", use_highly_variable=True)

# 可视化PCA结果
sc.pl.pca_scatter(adata, color="total_counts")
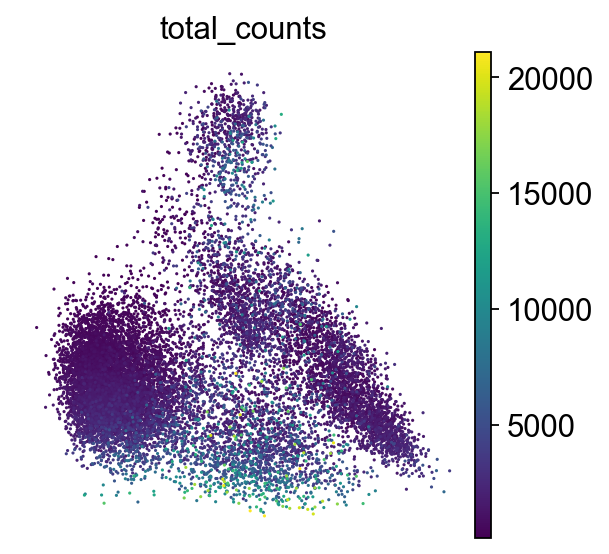 PCA直接可视化一般不太好看
PCA通常选择前10-50个主成分用于后续分析,不直接用于可视化。
t-SNE
# 基于PCA结果计算t-SNE
sc.tl.tsne(adata, use_rep="X_pca")

# 可视化t-SNE结果
sc.pl.tsne(adata, color="total_counts")
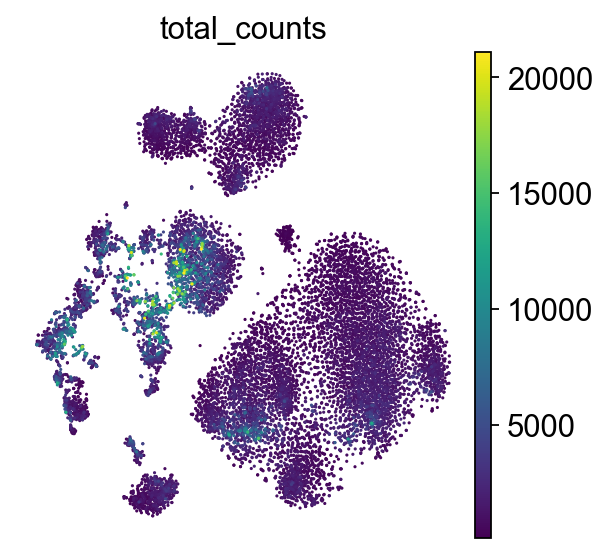 t-SNE图就可以看到明显的分群了
⚠️细节:t-SNE以PCA结果作为输入,而不是直接使用原始数据。这样做有两个好处:
- 1. 降低计算复杂度
- 2. 去除部分噪音,提高结果稳定性
UMAP
# 构建邻居图(UMAP的前置步骤)
sc.pp.neighbors(adata)

# 计算UMAP
sc.tl.umap(adata)

# 可视化UMAP结果
sc.pl.umap(adata, color="total_counts")
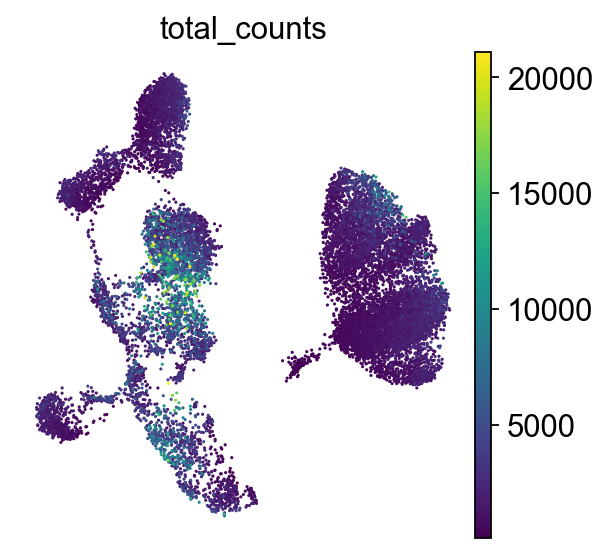 对比t-SNE,UMAP群和群之间的距离更远,群显得更紧密
注意UMAP需要先构建k近邻图,这个图也会在后续的聚类分析中使用。(简单来说,就是根据转录组的差异计算细胞间的“距离”,然后k个细胞为一组记录邻近关系)
04
评估质控指标
降维后也是再次评估数据质量的好时候。我们可以将之前计算的质控指标映射到降维图上:
# 在UMAP图上检查多个质控指标
sc.pl.umap(
    adata,
    color=["total_counts", "pct_counts_mt", "scDblFinder_score", "scDblFinder_class"],
)
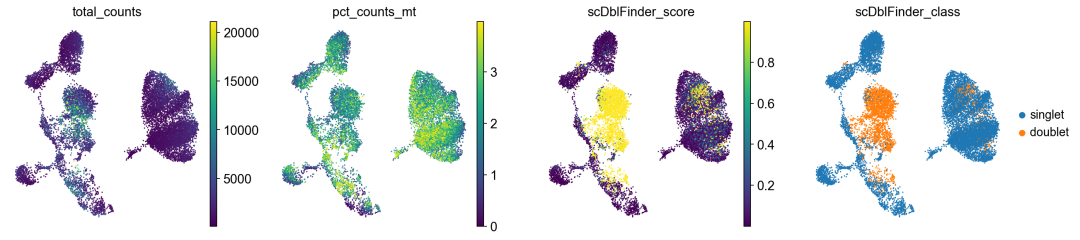 这里可以看到双细胞单独成群了
由上图,我们可以观察到:
- • total_counts:细胞的总读数分布
- • pct_counts_mt:线粒体基因比例
- • scDblFinder_score:双细胞得分
- • scDblFinder_class:双细胞分类结果
如果发现高双细胞得分的细胞聚集在同一区域,说明降维很好地捕捉到了数据的质量特征。这些细胞可以考虑在后续分析中移除。
🔍 小编注:降维图中的质量问题"信号"
降维图不仅能展示细胞类型结构,还是发现数据质量问题的"放大镜"。经验丰富的分析师能从降维图的异常模式中识别出各种技术问题:
1. 细胞群"拉丝"现象 :如果看到细胞群之间出现细长的连接带,可能提示存在环境DNA污染。这些污染物含有破碎的细胞碎片,基因表达介于不同细胞类型之间,在降维图上就表现为连接不同cluster的"桥梁"。
2. 高线粒体表达聚集 :如果发现线粒体基因比例高的细胞聚集成团,通常表明这些是濒死或已死亡的细胞。活力下降的细胞会优先丢失细胞质mRNA,而线粒体mRNA相对稳定,导致线粒体基因比例异常升高。
3. 低基因数细胞的离群分布 :检测到基因数异常少的细胞如果形成独立的小cluster,可能是空液滴(empty droplets)或细胞碎片,需要进一步过滤。
4. 批次效应的"分层“ :如果来自不同批次的相同细胞类型在降维图上出现明显分离,提示存在需要校正的批次效应。
5. 细胞周期的"弧形"分布 :有时能在降维图上观察到细胞沿着弧形分布,这通常反映了细胞周期的连续变化过程。
参数调优建议
- • PCA :主成分数量根据累积方差贡献率决定(通常90%以上)
- • t-SNE :困惑度(perplexity)参数影响局部-全局平衡
- • UMAP :邻居数(n_neighbors)和最小距离(min_dist)是关键参数
保存结果
# 保存降维后的数据
adata.write("s4d8_dimensionality_reduction.h5ad")
05
后记
降维是单细胞分析流程中承上启下的关键步骤。它将特征选择后的高维数据转换为便于后续聚类和可视化的低维表示。虽然每种方法都有其优势和局限,但在实际应用中,PCA+UMAP的组合一般是主流选择。需要注意的是,降维图中的距离不等同于原始空间的生物学距离。好的降维结果应该将不同细胞类型清楚分开。批次效应也是影响降维结果的一大因素。如果不同批次的细胞分离明显,除非是癌症这种样品间特异性很大的情况,就需要进行批次矫正。
需要注意的是,降维图中的距离不等同于原始空间的生物学距离 ,因此不应该过度解读。好的降维结果应该将不同细胞类型清楚分开 (当然,分得多开也取决于生物学问题中关心的细胞颗粒度。比如,在粗降维中,T细胞可能只成一群,但子群分析中需要分开)。批次效应也是影响降维结果的一大因素。如果不同批次的细胞分离明显,除非是癌症这种样品间特异性很大的情况,就需要进行批次矫正。
在下一章中,我们将基于这些降维结果进行细胞聚类分析,真正开始探索数据中隐藏的细胞类型和状态。大家在使用不同降维方法时有什么心得体会吗?欢迎在评论区交流讨论。本章英文原文及完整代码,可以在后台回复scbp09获取。
----------
单细胞领域大牛编写的最强硬核单细胞教程来啦!想要追更学习笔记,请给我们加个✨,不错过最新推送: