跟着Theis Lab学单细胞: 注释的方法你知道几种?
跟着Theis Lab学单细胞: 注释的方法你知道几种?
单细胞最佳实践
细胞注释
本章导读 SECTION PREVIEW
1. 细胞注释的核心概念和生物学意义
2. 基于标志基因(Marker)的手动注释策略
3. 自动化注释工具的原理和应用
4. 基于参考映射的高级注释技术
5. 实战:综合运用多种方法完成细胞注释
本节对应原书 11 Annotation
在单细胞测序分析中,我们面对的是成千上万个细胞的基因表达数据。但光有数据还不够——我们需要知道每个细胞的"身份",也就是它属于什么细胞类型。这个给细胞贴标签的过程,就是我们今天要讲的 " 细胞注释"(cell annotation)。
生物学家用 " 细胞类型(cell type)" 来描述具有特定功能、表达特定标志物的细胞群体。比如,浆细胞(Plasma B cell)是一种分泌抗体对抗病原体的白细胞,可以通过特定的标志基因来识别。
但就像任何分类系统一样,细胞类型的边界有时是模糊的。一方面,随着技术的发展,研究者常常能看到更细的分型(subtype) 或状态(state) , 比如 T 细胞可分为激活型和静息型。另一方面,有些类型之间其实是连续谱系,比如造血过程里,细胞逐步从干细胞分化到各类免疫细胞,很难划清绝对边界。
因此,“细胞类型”、“亚型”、“细胞状态” 之间往往带有主观性。近些年有人直接用更宽泛的 cell identity(细胞身份) 来避免这种硬区分。
实战准备
首先准备一下环境。
import warnings
warnings.filterwarnings("ignore", category=DeprecationWarning)

import scanpy as sc
import pandas as pd
import numpy as np
import os
from scipy.sparse import csr_matrix
import seaborn as sns
import matplotlib.pyplot as plt
import celltypist
from celltypist import models
import scarches as sca
import urllib.request

# 设置图形参数
sc.set_figure_params(figsize=(5, 5))
然后是数据,来自上一节用过的骨髓数据:
adata = sc.read(
    filename="s4d8_clustered.h5ad",
    backup_url="https://figshare.com/ndownloader/files/41436666",
)
策略一:手动注释
在单细胞分析发展的早期,注释细胞最常见的方法就是依赖标记基因(marker genes) 。
研究者会列出一组已知和某类细胞相关的基因,根据它们在聚类结果里的表达情况来判断簇对应的细胞类型。
这种方法的优点:
- 简单直观,尤其在早期 FACS 数据中(通常只有几十个基因),效率很高;
- 透明性好,容易解释。
但缺点也明显:
- 很多细胞类型并没有唯一的“标记基因”;
- 同一个标记在不同数据集里可能表现不一致;
- 有时需要多个基因组合或设定阈值,带有一定的主观性。
因此,一般会先对数据做聚类,然后再给每个簇(cluster)分配标签,而不是逐细胞去注释。这样不仅更robust,也能缓解单细胞转录组的dropout问题。
总体上,手动注释有两种常见角度:
- 从标记基因出发 :列出一份你预期的细胞类型的 marker 列表,再看它们在数据里的分布。
- 从差异基因出发 :先算每个簇的差异表达基因,再去查它们是否对应某类已知细胞。
我们先从第一种方式(marker → cluster)开始。
定义已知marker
这里我们先定义一份文献中整理的骨髓细胞 marker 表:
marker_genes = {
    "CD14+ Mono": ["FCN1", "CD14"],
    "CD16+ Mono": ["TCF7L2", "FCGR3A", "LYN"],
    "ID2-hi myeloid prog": ["CD14", "ID2", "VCAN", "S100A9", "CLEC12A", "KLF4", "PLAUR"],
    "cDC1": ["CLEC9A", "CADM1"],
    "cDC2": ["CST3", "COTL1", "LYZ", "DMXL2", "CLEC10A", "FCER1A"],  # DMXL2 为负标记
    "Normoblast": ["SLC4A1", "SLC25A37", "HBB", "HBA2", "HBA1", "TFRC"],
    "Erythroblast": ["MKI67", "HBA1", "HBB"],
    "Proerythroblast": ["CDK6", "SYNGR1", "HBM", "GYPA"],  # HBM, GYPA 为负标记
    "NK": ["GNLY", "NKG7", "CD247", "GRIK4", "FCER1G", "TYROBP", "KLRG1", "FCGR3A"],
    "ILC": ["ID2", "PLCG2", "GNLY", "SYNE1"],
    "Lymph prog": ["VPREB1", "MME", "EBF1", "SSBP2", "BACH2", "CD79B", "IGHM", "PAX5", "PRKCE", "DNTT", "IGLL1"],
    "Naive CD20+ B": ["MS4A1", "IL4R", "IGHD", "FCRL1", "IGHM"],
    "B1 B": ["MS4A1","SSPN","ITGB1","EPHA4","COL4A4","PRDM1","IRF4","CD38","XBP1","PAX5","BCL11A","BLK","IGHD","IGHM","ZNF215"],  # IGHD, IGHM 为负标记
    "Transitional B": ["MME", "CD38", "CD24", "ACSM3", "MSI2"],
    "Plasma cells": ["MZB1", "HSP90B1", "FNDC3B", "PRDM1", "IGKC", "JCHAIN"],
    "Plasmablast": ["XBP1", "RF4", "PRDM1", "PAX5"],  # PAX5 为负标记
    "CD4+ T activated": ["CD4", "IL7R", "TRBC2", "ITGB1"],
    "CD4+ T naive": ["CD4", "IL7R", "TRBC2", "CCR7"],
    "CD8+ T": ["CD8A", "CD8B", "GZMK", "GZMA", "CCL5", "GZMB", "GZMH", "GZMA"],
    "T activation": ["CD69", "CD38"],  # CD69 更好用
    "T naive": ["LEF1", "CCR7", "TCF7"],
    "pDC": ["GZMB", "IL3RA", "COBLL1", "TCF4"],
    "G/M prog": ["MPO", "BCL2", "KCNQ5", "CSF3R"],
    "HSC": ["NRIP1", "MECOM", "PROM1", "NKAIN2", "CD34"],
    "MK/E prog": ["ZNF385D","ITGA2B","RYR3","PLCB1"],  # PLCB1 为负标记
}
检查一下这些标记基因在我们的数据里是否存在:
marker_genes_in_data = {}
for ct, markers in marker_genes.items():
    markers_found = []
    for marker in markers:
        if marker in adata.var.index:
            markers_found.append(marker)
    marker_genes_in_data[ct] = markers_found
降维及可视化
# 保存原始counts
adata.layers["counts"] = adata.X
# 使用归一化后的数据
adata.X = adata.layers["scran_normalization"]
adata.var["highly_variable"] = adata.var["highly_deviant"]

# PCA降维
sc.tl.pca(adata, n_comps=50, use_highly_variable=True)
# 计算邻域图
sc.pp.neighbors(adata)
# 生成UMAP
sc.tl.umap(adata)
B / 浆细胞亚群:
B_plasma_cts = [
    "Naive CD20+ B",
    "B1 B",
    "Transitional B",
    "Plasma cells",
    "Plasmablast",
]

for ct in B_plasma_cts:
    print(f"{ct.upper()}:")
    sc.pl.umap(
        adata,
        color=marker_genes_in_data[ct],
        vmin=0,
        vmax="p99",
        sort_order=False,
        frameon=False,
        cmap="Reds",
    )
以下是其中一个亚群的示例图。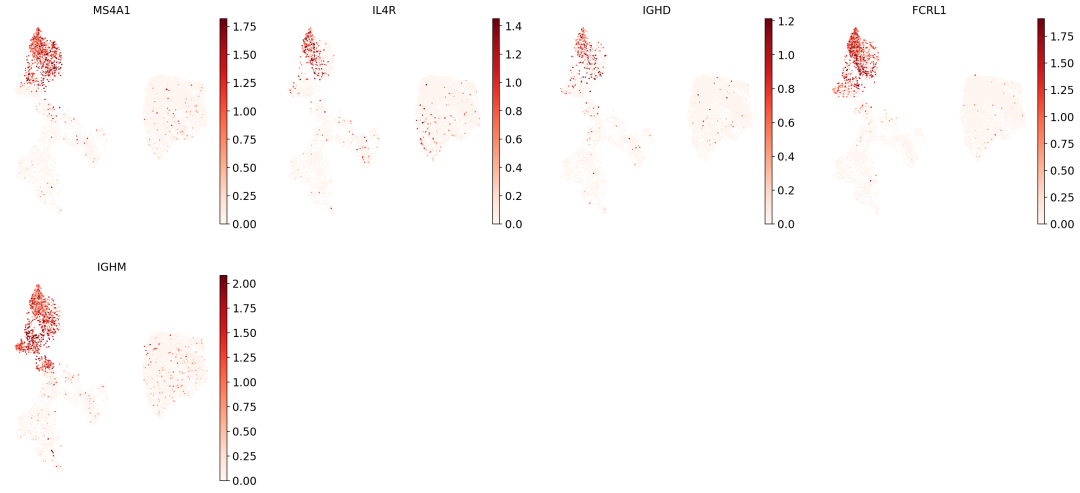
我们会发现,单个 marker 往往在多个簇里都有表达;真正区分细胞类型,往往要看多个 marker 的交集。再者,由于dropout现象,标志基因也只在一部分细胞里被检测到。因此,我们通过聚类将相似的细胞分为一组来注释,以应对这些可能未被检测到的转录本。
聚类及可视化
我们先用 Leiden 算法来做聚类:
#sc.tl.leiden(adata, resolution=1, key_added="leiden_1")
#sc.pl.umap(adata, color="leiden_1")
# 采用粒度2获得更精细的分群
sc.tl.leiden(adata, resolution=2, key_added="leiden_2")
sc.pl.umap(adata, color="leiden_2")
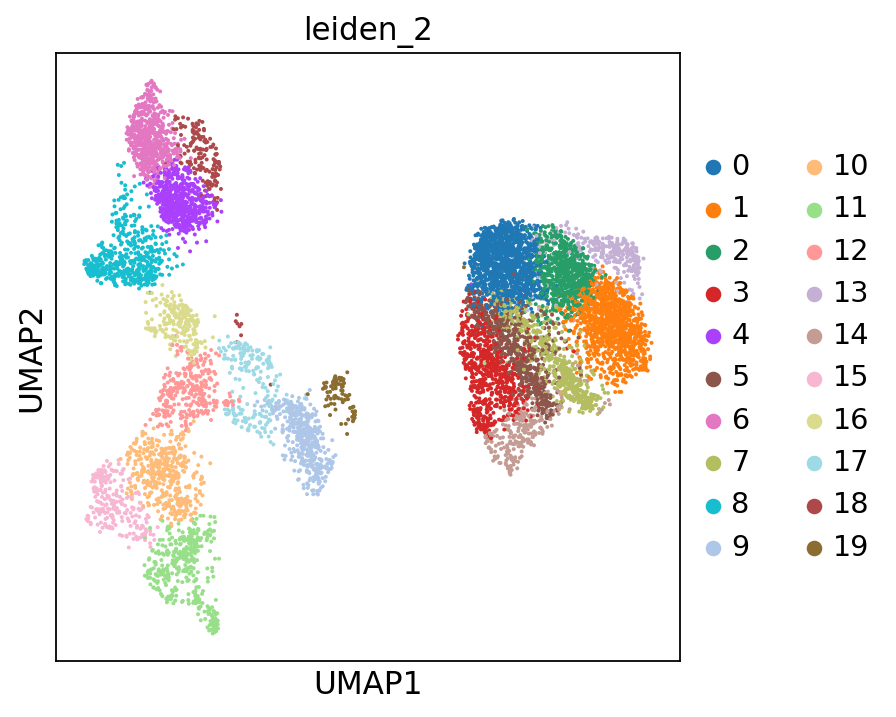 粒度2的聚类结果
使用点图(dotplot)查看各cluster的标志基因表达:
B_plasma_markers = {
    ct: [m for m in ct_markers if m in adata.var.index]
    for ct, ct_markers in marker_genes.items()
    if ct in B_plasma_cts
}
sc.pl.dotplot(
    adata,
    groupby="leiden_2",
    var_names=B_plasma_markers,
    standard_scale="var",
)
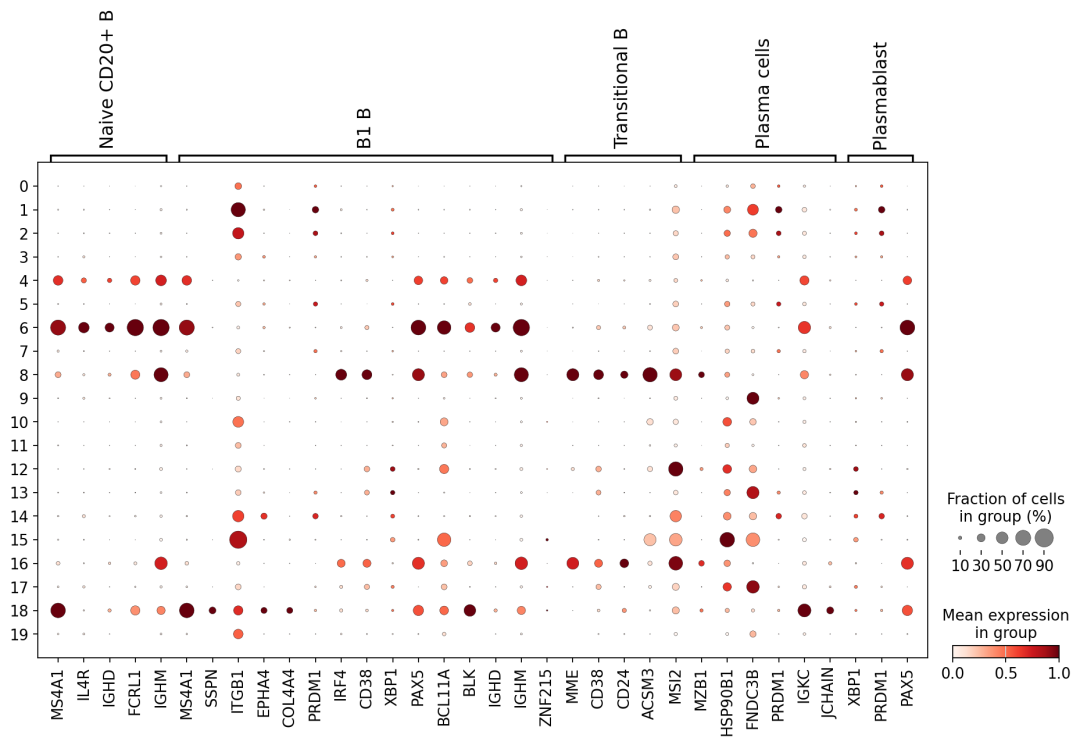 浆细胞marker
由此我们可以注释一部分簇:
cl_annotation = {
    "4": "Naive CD20+ B",
    "6": "Naive CD20+ B",
    "8": "Transitional B",
    "18": "B1 B",  # 注意 B1 B 的负标记 IGHD, IGHM 在这里更低表达
}

adata.obs["manual_celltype_annotation"] = adata.obs.leiden_2.map(cl_annotation)

sc.pl.umap(adata, color=["manual_celltype_annotation"])
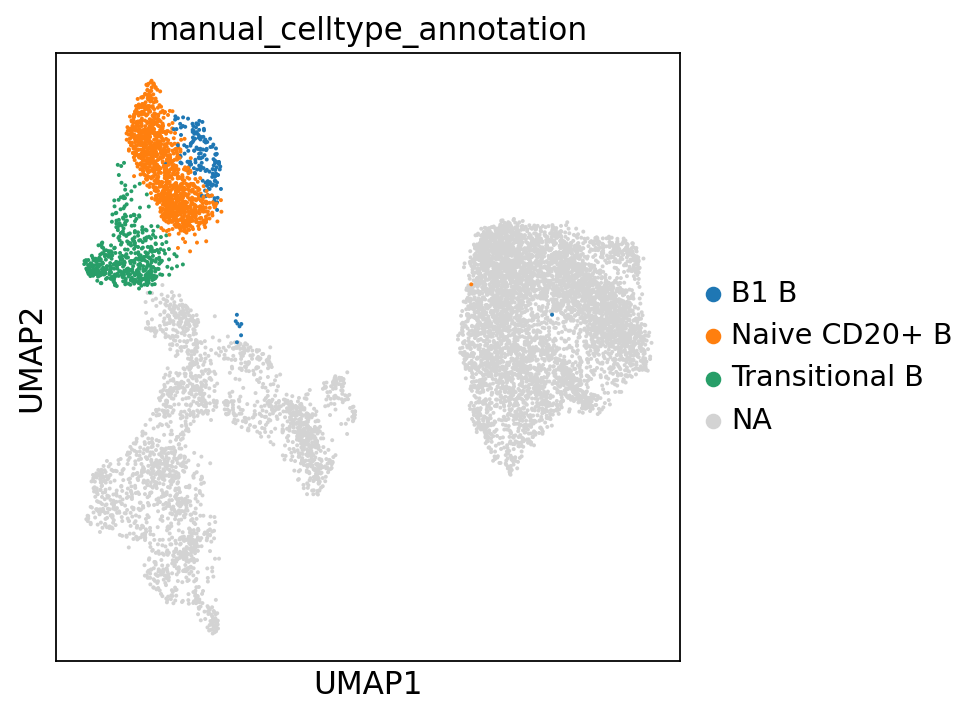 可视化注释结果
我们发现B1 B细胞的标记分布比较模糊,没有某个簇能完整覆盖,说明marker在不同数据集里表现差异很大。这就是手动注释常见的难点。
差异基因
另一种思路是:反过来先计算每个簇的差异表达基因(DEG),再去查这些基因和已知细胞类型/状态的对应关系。
# 计算差异表达基因
sc.tl.rank_genes_groups(
    adata, groupby="leiden_2", method="wilcoxon", key_added="dea_leiden_2"
)

# 过滤得到更特异的基因
sc.tl.filter_rank_genes_groups(
    adata,
    min_in_group_fraction=0.2,
    max_out_group_fraction=0.2,
    key="dea_leiden_2",
    key_added="dea_leiden_2_filtered",
)

# 可视化
sc.pl.rank_genes_groups_dotplot(
    adata,
    groupby="leiden_2",
    standard_scale="var",
    n_genes=5,
    key="dea_leiden_2_filtered",
)
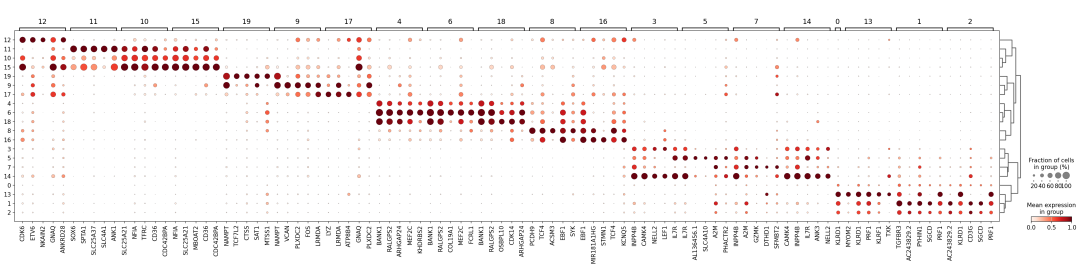 差异基因点图可视化
我们注意到cluster 12有一些相对独特的基因:CDK6、ETV6、NKAIN2、GNAQ。查文献得知NKAIN2和ETV6是造血干细胞的标记。同时,MK/E prog的一些已知marker在cluster 12里也有表达:
sc.pl.umap(
    adata,
    color=["CDK6", "ETV6", "NKAIN2", "GNAQ", "leiden_2"],
    vmax="p99",
    legend_loc="on data",
    frameon=False,
    cmap="Reds",
)
sc.pl.umap(
    adata,
    color=["ZNF385D", "ITGA2B", "RYR3", "PLCB1"],
    vmax="p99",
    legend_loc="on data",
    frameon=False,
    cmap="Reds",
)
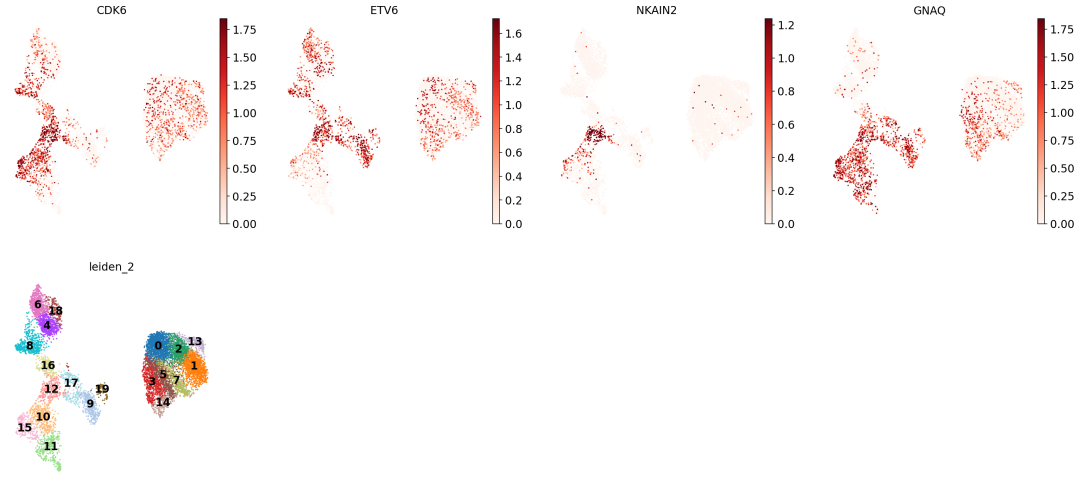
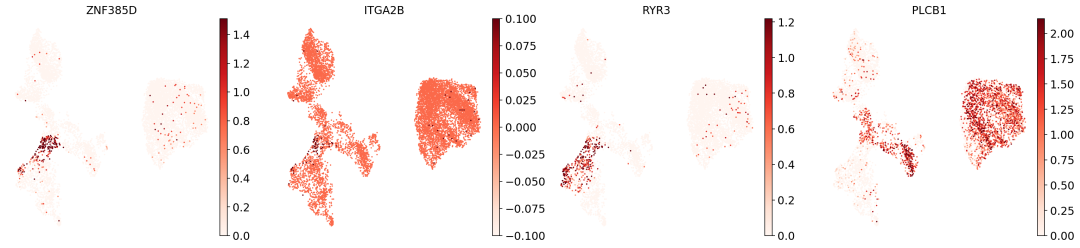
这说明cluster 12并不是纯粹的 HSC,而是混合了 HSC 和 MK/E progenitors的群。 我们可以在注释里加上这样的不确定性:
cl_annotation["12"] = "HSCs + MK/E prog (?)"
adata.obs["manual_celltype_annotation"] = adata.obs.leiden_2.map(cl_annotation)
可以看到,手动注释虽然比较灵活、直观,但实际操作起来也有不少挑战:1)容易受 marker 选择、簇分辨率、样本差异的影响;2)很多细胞类型没有独特的标志基因,很难判断是混合簇还是新亚群;3)需要大量的先验知识和经验。这也是为什么越来越多的研究会在手动基础上,借助自动化工具 来加速注释和校验。
策略二:自动注释
虽然在本教程中被归为一大类,但自动注释工具在现今仍然是一个非常活跃的领域。基于不同算法(如机器学习、神经网络、大模型等)等的细分方法层出不穷。不过要记住:自动化结果通常只是一个起点 ,最后还是要人工验证。
自动化注释质量取决于三方面:
- 分类器类型: 研究发现,不同算法(SVM、逻辑回归、神经网络等)性能差异不大,深度学习并不一定总是最优。
- 训练数据质量 :如果训练集注释粗糙或错误,模型输出也会差(垃圾进,垃圾出嘛)。
- 数据相似度 :如果训练集是 drop-seq,而你的数据是 10X snRNA-seq,注释结果的可靠性就会降低。跨组织/跨物种也是同样道理。
优点也明显:
- 快速、方便,很多时候不需要下载和处理大参考集;
- 不依赖于聚类,可以在单个细胞水平进行;
- 可以借力已有的高质量注释;
- 有助于统一领域里的命名和标签。
某些自动化注释工具(尤其是机器学习类)透明度较低,需要结合置信度/不确定性指标判断。
CellTypist
CellTypist是一个基于机器学习的自动注释工具。它使用预训练的模型来预测细胞类型:
# 准备数据:归一化到每细胞10000个counts,然后log转换
adata_celltypist = adata.copy()
adata_celltypist.X = adata.layers["counts"]
sc.pp.normalize_per_cell(adata_celltypist, counts_per_cell_after=10**4)
sc.pp.log1p(adata_celltypist)
adata_celltypist.X = adata_celltypist.X.toarray()

# 下载免疫细胞模型
models.download_models(
    force_update=True, model=["Immune_All_Low.pkl", "Immune_All_High.pkl"]
)

# 加载模型(细粒度)
model_low = models.Model.load(model="Immune_All_Low.pkl")
#model_high = models.Model.load(model="Immune_All_High.pkl")

# 进行预测
predictions_low = celltypist.annotate(
    adata_celltypist, model=model_low, majority_voting=True
)

# 将结果存入原始adata
predictions_low_adata = predictions_low.to_adata()
adata.obs["celltypist_cell_label_fine"] = predictions_low_adata.obs.loc[
    adata.obs.index, "majority_voting"
]
adata.obs["celltypist_conf_score_fine"] = predictions_low_adata.obs.loc[
    adata.obs.index, "conf_score"
]
可视化一下,评估注释质量:
sc.pl.umap(
    adata,
    color=["celltypist_cell_label_fine", "celltypist_conf_score_fine"],
    frameon=False,
)
sc.pl.dendrogram(adata, groupby="celltypist_cell_label_fine")
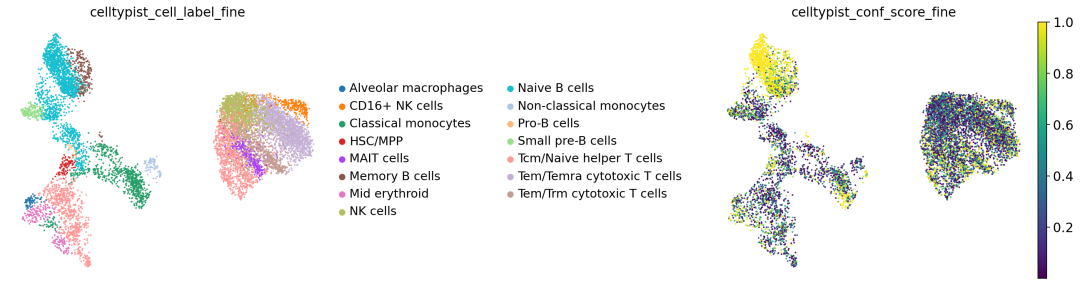 细粒度注释结果及置信度
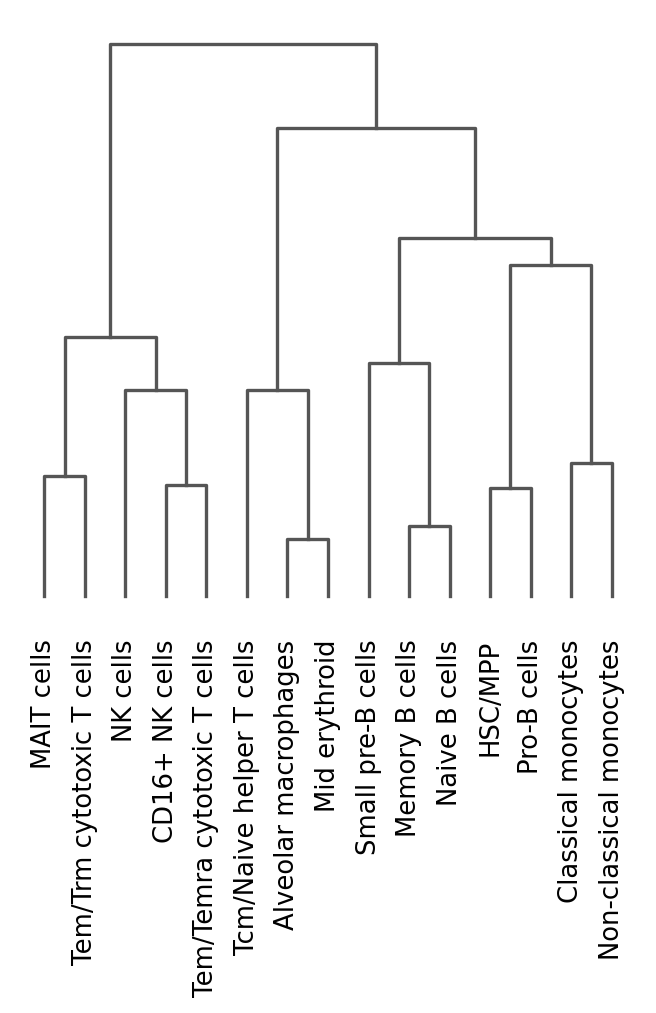 细胞类型的相似性树状图
利用粗粒度模型进行注释的过程类似。篇幅所限,这里不再赘述。
通过树状图和与手动注释的对比,我们发现某些注释不太合理:比如Tcm/Naive helper T细胞与erythroid cells和macrophages更近,并没有与其他T细胞亚群分为一组,这提示我们注释可能有问题。
我们还可以检查一下上文提到的cluster 12 (按照celltypist注释结果由多到少排序):
pd.crosstab(adata.obs.leiden_2, adata.obs.celltypist_cell_label_fine).loc[
    "12", :
].sort_values(ascending=False)

celltypist_cell_label_fine
Naive B cells                  98
HSC/MPP                        97
Classical monocytes            56
Pro-B cells                    28
Tcm/Naive helper T cells       13
Tem/Temra cytotoxic T cells     1
...
Name: 12, dtype: int64
可以看到簇内确实有混杂的情况。所以,自动注释的结果也不能一概全盘接受,还需要再次仔细检查。
scArches
这种方法采用了类似“把测序数据比对到参考基因组”的思路,将新数据映射 到已注释的参考数据集,然后进行标签转移(label transfer) 。
★
注:scArches利用GPU加速。如果你的电脑没有独立GPU,可能会无法运行或运行很慢。
# 准备映射数据
adata_to_map = adata.copy()
adata_to_map.X = adata_to_map.layers["counts"]

# 加载参考模型的特征
reference_model_features = pd.read_csv(
    "https://figshare.com/ndownloader/files/41436645", index_col=0
)

# 确保基因顺序一致
adata_to_map.var["gene_names"] = adata_to_map.var.index
adata_to_map.var.set_index("gene_ids", inplace=True)

# 补充缺失基因(设为0)
missing_genes = [
    gene_id for gene_id in reference_model_features.index
    if gene_id notin adata_to_map.var.index
]

missing_gene_adata = sc.AnnData(
    X=csr_matrix(np.zeros(shape=(adata.n_obs, len(missing_genes))), dtype="float32"),
    obs=adata.obs.iloc[:, :1],
    var=reference_model_features.loc[missing_genes, :],
)

# 合并数据
adata_to_map_augmented = sc.concat(
    [adata_to_map, missing_gene_adata], axis=1
)
接下来,我们训练映射模型:
# 加载参考模型
scarches_model = sca.models.SCVI.load_query_data(
    adata=adata_to_map_augmented,
    reference_model="./reference_model",
    freeze_dropout=True,
)

# 训练映射
scarches_model.train(max_epochs=500, plan_kwargs=dict(weight_decay=0.0))

# 获取嵌入表示
adata.obsm["X_scVI"] = scarches_model.get_latent_representation()
我们简单可视化一下新的降维数据,确保同一细胞类型仍然聚类在一起:
sc.pp.neighbors(adata, use_rep="X_scVI")
sc.tl.umap(adata)
sc.pl.umap(
    adata,
    color=["IGHD", "IGHM", "PRDM1"],
    vmin=0,
    vmax="p99",
    sort_order=False,
    frameon=False,
    cmap="Reds"
)
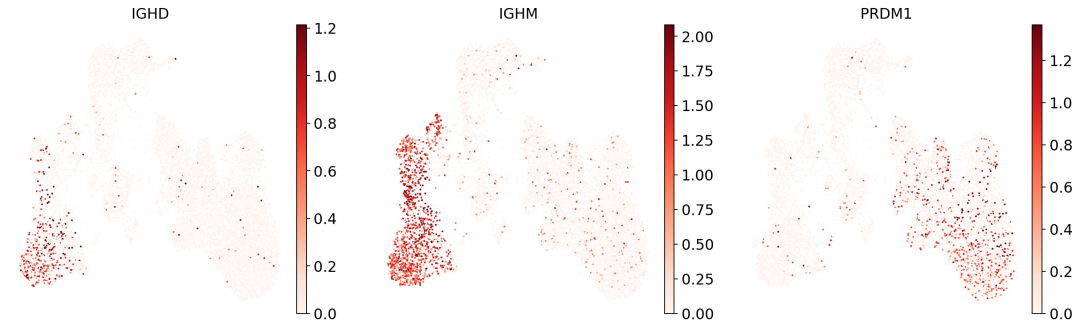
下一步是计算KNN,并进行标签转移:
# 加载参考数据的嵌入
ref_emb = sc.read(
    filename="reference_embedding.h5ad",
    backup_url="https://figshare.com/ndownloader/files/41376264",
)

# 创建查询数据的嵌入对象
adata_emb = sc.AnnData(X=adata.obsm["X_scVI"], obs=adata.obs)

# 合并参考和查询数据
emb_ref_query = sc.concat([ref_emb, adata_emb], axis=0)

# KNN标签转移
knn_transformer = sca.utils.knn.weighted_knn_trainer(
    train_adata=ref_emb,
    train_adata_emb="X",
    n_neighbors=15,
)

labels, uncert = sca.utils.knn.weighted_knn_transfer(
    query_adata=adata_emb,
    query_adata_emb="X",
    label_keys="cell_type",
    knn_model=knn_transformer,
    ref_adata_obs=ref_emb.obs,
)
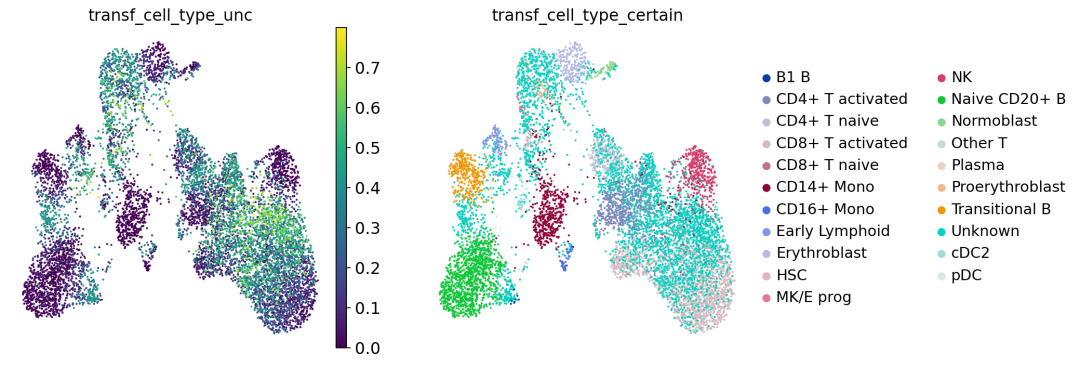
查看一下注释结果:
# 将高不确定性的细胞标记为"Unknown"
adata.obs["transf_cell_type_certain"] = adata.obs.transf_cell_type.tolist()
adata.obs.loc[
    adata.obs.transf_cell_type_unc > 0.2, "transf_cell_type_certain"
] = "Unknown"

sc.pl.umap(adata, color="transf_cell_type_certain", frameon=False)
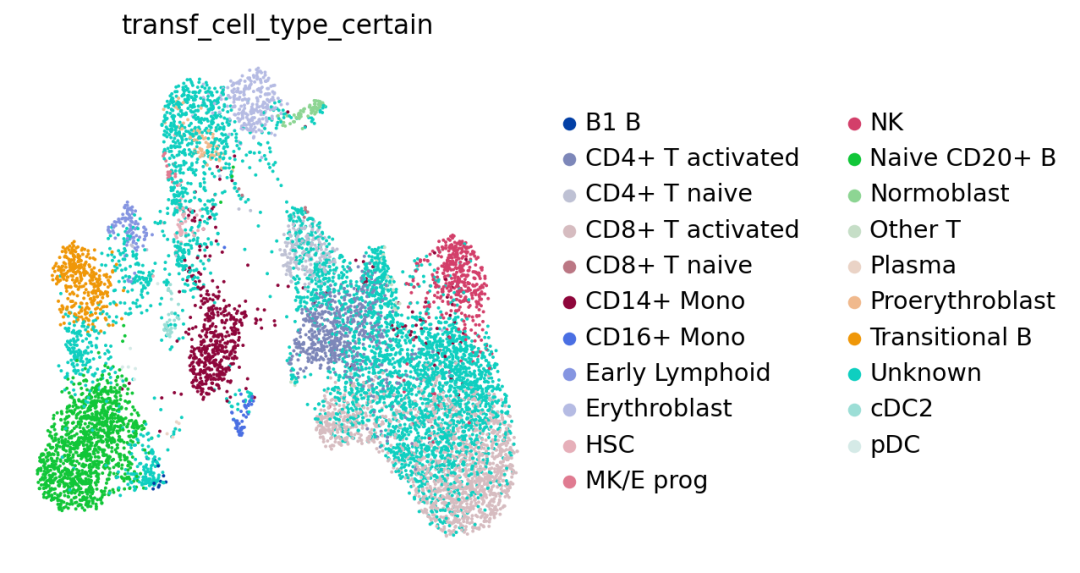
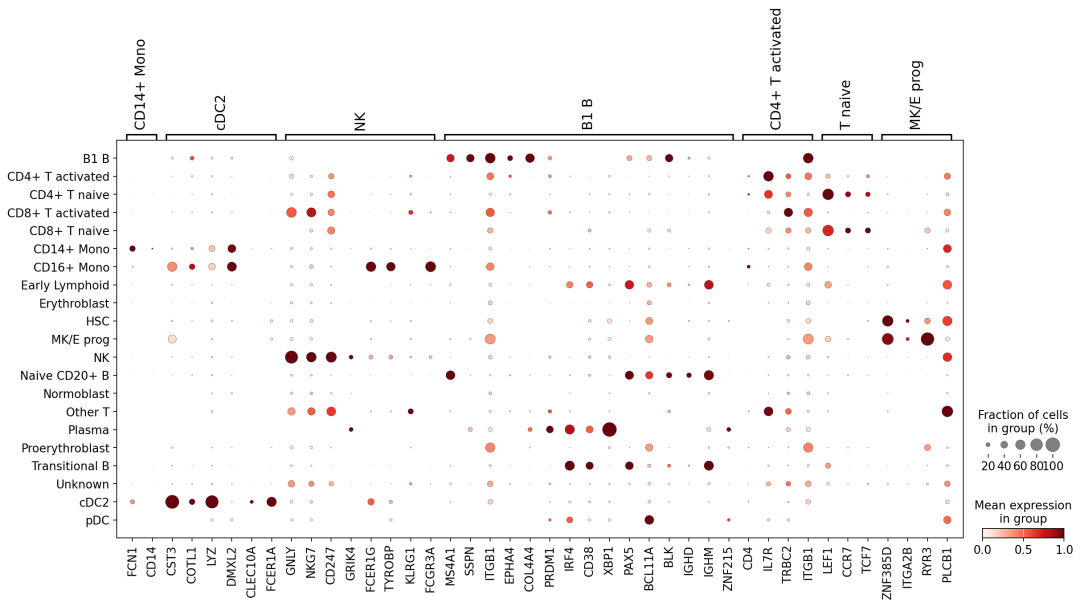
可以看到仍有不少细胞被标记为“unknown”,这些细胞需要进一步的人工处理。
让我们检查一下标志基因的表达:
# 检查各细胞类型的标志基因表达
cell_types_to_check = [
    "CD14+ Mono", "cDC2", "NK", "B1 B",
    "CD4+ T activated", "T naive", "MK/E prog",
]

sc.pl.dotplot(
    adata,
    var_names={ct: marker_genes_in_data[ct] for ct in cell_types_to_check},
    groupby="transf_cell_type_certain",
    standard_scale="var",
)
最后,让我们把注释的不确定性也画出来,这能帮我们发现需要进一步处理的区域:
sc.pl.umap(
    adata, color=["transf_cell_type_unc", "transf_cell_type_certain"], frameon=False
)
保存中间数据:
# adata.write("./annotation_adata_out.h5ad")
后记
细胞注释是单细胞分析中最关键也最具挑战性的步骤之一。准确的细胞类型鉴定直接影响后续所有分析的可靠性——从发现疾病相关的细胞亚群,到追踪发育轨迹,再到细胞间通讯分析。
当前挑战
- 标准化问题:不同研究使用不同的细胞类型命名体系,缺乏统一标准
- 分辨率困境:应该分到多细的程度?CD4+ T细胞还是Th1/Th2/Th17?
- 连续性vs离散性:很多细胞处于连续的状态谱系中,强行分类可能丢失重要信息
- 批次效应:不同实验条件、测序平台产生的差异可能掩盖真实的生物学信号
最新进展
- 大规模参考图谱:Human Cell Atlas、CZI CELLxGENE等项目正在构建覆盖所有人体细胞类型的参考图谱
- 基础模型:类似scGPT、Geneformer的大模型开始用于细胞注释,能够处理更复杂的情况
- 多模态整合:结合转录组、蛋白质组、表观组等多层面信息进行更准确的注释
- 不确定性量化:越来越多的方法提供置信度评分,帮助识别需要人工审核的区域
- 层级注释:从粗到细的多层级注释体系,适应不同研究需求
实用建议
对于实际研究中的细胞注释,建议采用"多管齐下"的策略:
- 先用自动化方法快速获得初步注释
- 结合多个工具的结果,关注一致性高的注释
- 重点验证关键细胞类型的标志基因表达
- 保留不确定性信息,对低置信度区域进行人工审核
- 与领域专家合作,确保生物学解释的合理性
我们公众号之前也发过几篇关于注释的文章哦~请看:我愿称新Azimuth为最强注释工具,还有利用大模型帮助检索标记基因的方法GPTcelltype未来已来:LLM X 单细胞的时代开始了
大家觉得什么注释工具最靠谱?欢迎在评论区分享你的经验!本章英文原文及完整代码,可以在后台回复scbp11 获取。
----------
单细胞领域大牛编写的最强硬核单细胞教程来啦!想要追更学习笔记,请给我们加个✨,不错过最新推送: