跟着Theis Lab学单细胞: 从质控到矩阵
跟着Theis Lab学单细胞: 从质控到矩阵
单细胞最佳实践计数矩阵的生成和质控
本章导读 SECTION PREVIEW
1. 如何评估单细胞数据的整体质量?
2. 如何筛选出高质量的细胞并排除技术噪音?
3. 哪些工具和方法可以帮助我们更好地完成质控?
4. 不同工具生成的计数矩阵有何差异?如何选择适合的方法?
本节对应原书 3.5 Count matrix quality control,3.6 Count data representation,3.7 Brief Discussion
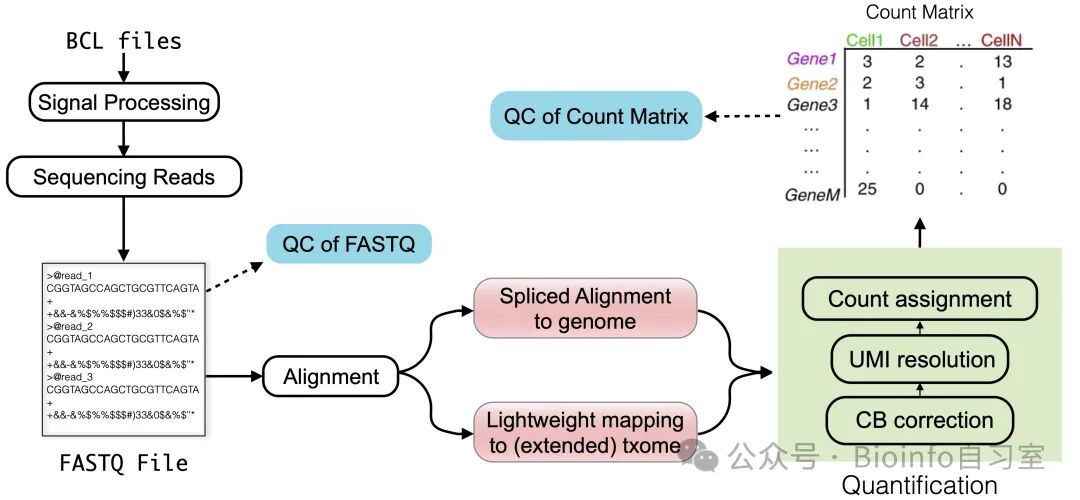 图1. 本章知识概览。终于来到了上游的最后一部分——计数矩阵。
01
评估数据质量
在单细胞测序实验中,生成计数矩阵(count matrix)是数据分析的第一步,也是预处理的最后一步。然而,这并不意味着我们可以直接进入下游分析——对计数矩阵进行质量控制(QC, Quality Control) 是至关重要的一步。只有通过严格的质控,我们才能确保后续分析的结果可靠且有意义。质控的核心目标是评估测序数据的整体质量,并筛选出“高质量”的细胞,同时排除那些可能受到污染或技术问题影响的数据。全局指标可以帮助我们快速了解测序数据的整体表现,例如:
总体比对率(mapped reads的比例)
每个细胞的UMI分布
UMI去重率(deduplication rate)
每个细胞检测到的基因数量
这些指标通常由量化工具(如alevin、Cell Ranger 等)自动生成,因为它们在读取比对、细胞条形码校正和UMI解析的过程中自然产生。为了更直观地展示这些指标,许多工具提供了可视化的功能,例如10X Genomics提供的Loupe Browser 、alevinQC ,以及kb_python 的报告功能等。下面我们以alevinQC为例,介绍一份典型的质控报告包含哪些内容。

 **1. 元数据和统计摘要 **质控报告的第一部分通常是元数据和统计摘要表,例如工具运行时间、版本信息;输入文件路径(FASTQ 文件、参考基因组索引等);测序读段总数、过滤后的细胞条形码数量、去重后的UMI总数等。这些信息为后续分析提供了基础背景。
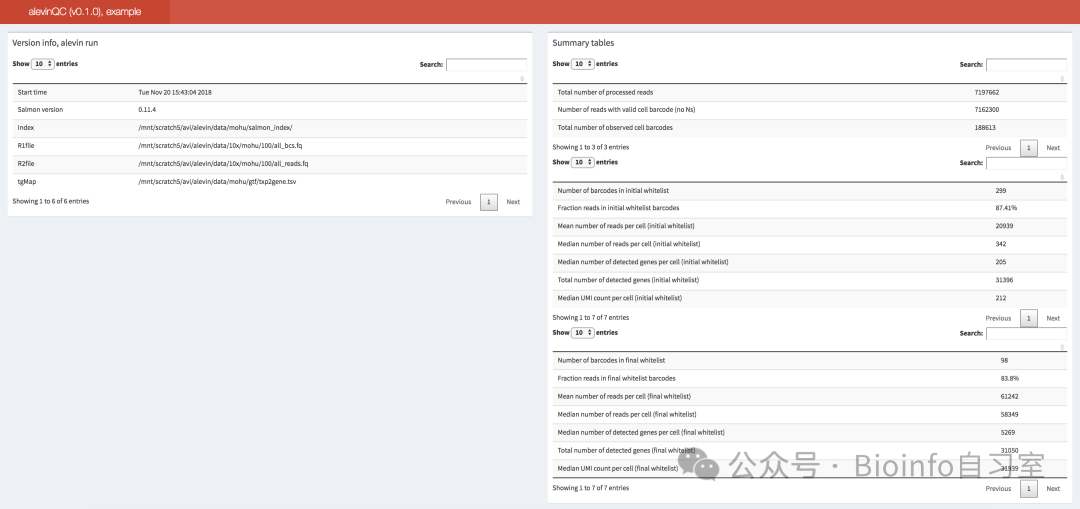 图1 报告中的统计摘要
2. “膝盖图”(Knee Plot)和初步筛选 “膝盖图”是一种常见的质控图表(见图2.1),用于区分高质量细胞和空液滴(empty droplets)。横轴为细胞条形码按频率降序排列,而纵轴是每个条形码对应的读段数量。在图中,我们会看到一个明显的“膝盖点”(即拐点),这个点通常被认为是高质量细胞和低质量细胞的分界线。高质量细胞会用红色标记出来,而低质量细胞则可能是空液滴或受损细胞。
3. 条形码校正(图2.2) 在初步筛选后,工具会对细胞条形码进行序列校正。校正前后的读段数量对比图可以帮助我们评估校正的效果。理想情况下,校正不会显著改变条形码的分布。
4. 基因数量分布(图2.3) 另一个重要的指标是每个细胞检测到的基因数量。通常来说,平均每个细胞检测到约2000个基因是一个合理的标准。如果所有细胞的基因数量都很低,则需要重新检查数据质量。
**5. 量化总结(图2下半) **最后,质控报告会通过散点图展示细胞条形码频率、去重后的UMI总数、非零基因数量之间的关系。这些指标之间应呈现正相关关系。如果某些细胞明显偏离整体趋势,则可能需要进一步排查。
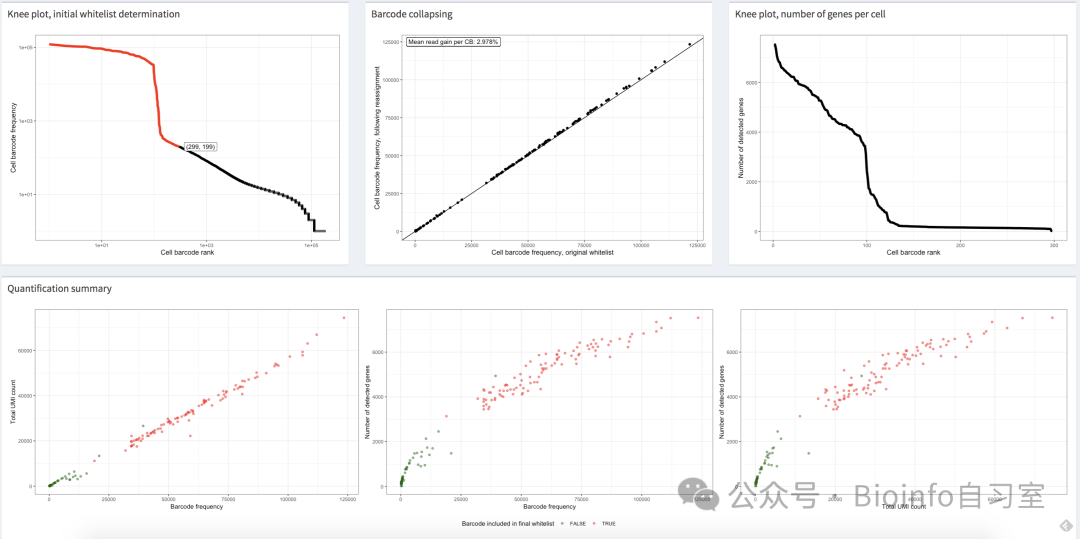
图2 报告中的系列质控图


上下滑动查看更多
02
检测空液滴和多细胞
在基于液滴的单细胞测序实验中,有些条形码可能并未捕获到真正的细胞,而是来源于环境RNA(ambient RNA)。这些“空液滴”仍然会产生测序读段,但其特征与高质量细胞显著不同。常用的检测空液滴的方法首先是上述的“膝盖图”法,通过绘制条形码频率的累积分布图,找到“拐点”作为高质量细胞和空液滴的分界线。这种方法简单直观,但在某些情况下可能难以自动检测到明显的拐点。更高级的方法是使用专门设计的工具(如DropletUtils中的emptyDrops函数),结合多种指标(如UMI数量、基因数量、线粒体RNA比例等)来判断条形码是否对应于空液滴。
⚠️注:根据是否有上游运行后的完整输出,可以选择不同的方法去除污染RNA。如果有未过滤液滴的原始矩阵(raw_bc_matrix),CellBender一般是金标准。如果只有过滤后的原始矩阵(即已经去掉了部分空液滴),还可以用诸如DeconX类的工具估计背景噪声并去除。
除了判断哪些细胞条形码对应于空液滴或受损细胞外,有时我们还需要识别那些可能对应于双细胞 (或多细胞,即 multiplets )的条形码。当一个液滴捕获了两个(双细胞)或更多(多细胞)细胞时,其对应的条形码在读取数、UMI 数以及基因表达谱等方面往往会出现异常分布。为此,研究者们已经开发出许多工具来预测细胞条形码是否存在双细胞问题(比如DoubletDetection,DoubletFinder,scDblFinder,Scrublet等等 )。一旦检测到可能的双细胞或多细胞条形码,这些细胞在后续分析中便可以被剔除或进行相应调整。
03
总结与讨论
在完成原始数据处理和质量控制后,进入后续分析阶段时,我们必须认识到:细胞与基因构成的计数矩阵最多只能近似反映原始样本中测序到的分子情况。在数据处理流程的多个阶段,都采用了启发式方法和简化假设来生成这一计数矩阵。例如,读取比对并非完美无缺,细胞条形码校正也存在误差;而 UMI 的精确解析更是一项挑战,多重比对读取中 UMI 的问题也常被忽略;此外,多个引物位点(尤其是在未剪接分子中)可能会违反“一分子对应一个 UMI”这一常见假设。
本章总结了关于常见预处理工具的一些基准测试和综述研究中提出的观察与建议。需要指出的是,针对单细胞和单核 RNA 测序原始数据处理方法与工具的开发,以及对这些方法的持续评估,始终是一个社区共同努力的过程。因此,在进行自身分析时,尝试使用多种不同工具通常是既有用又合理的。
从宏观角度看,目前主流工具在数据处理上已能做到稳健且准确。有研究指出,在聚类等常见下游分析中,预处理工具的选择对结果的影响通常不如其他分析步骤显著。不过,也有研究观察到,采用仅针对剪接转录组的轻量级比对方法(如alevin-fry),可能会增加错误比对及虚假基因表达的风险。
总之,具体使用哪种工具,很大程度上取决于实际任务及可用计算资源的限制。对于标准的单细胞分析,基于轻量级比对的方法是个不错的选择——它们通常运行速度更快(往往快得多)且更节省内存;而在单核 RNA 测序分析中,尤其推荐使用 alevin-fry,因为即使扩展转录组参考(包括未剪接序列),它依然能保持低内存占用且索引较小。相反,当需要恢复比对到(扩展)转录组之外的读取,或在下游分析中需要精确的基因组比对位点时,基于比对的方法则更为合适。这在诸如使用 sierra 等工具进行差异转录本使用分析时尤为重要。在基于比对的流程中,也有诸如 STARsolo 等工具能与商业级的 Cell Ranger比肩甚至更好,因为前者运行速度更快、内存占用更低,同时能产生几乎一致的结果。
04
后记
原书第三章的文字部分到这里就结束了。了解了上游每个步骤的原理之后,我们就能更加自信地选择适合自己的方法。本书作者们推荐的轻量化方法,比如alevin-fry,也很适合缺少计算资源的研究者,在个人电脑上也可以流畅运行。下一篇我们将进入实战演练,用一个具体的例子带大家了解这个轻量级工具的运行流程。敬请期待!
本章英文原文、扩展阅读,以及即将更新的代码/实例数据,可以在后台回复scbp03获取。
觉得本系列对你有用的话,欢迎加🌟,不错过最新推送!