跟着Theis Lab学单细胞: 序列比对有讲究
跟着Theis Lab学单细胞: 序列比对有讲究
Cracking single-cell analysis with Theis Lab
No.04 | 发布日期:2025-01-22 | 预计阅读:17分钟
单细胞最佳实践
序列比对和映射
本节导读 1. 常用比对工具介绍2. 全局映射vs局部映射3. 参考基因组的选择
序列映射/比对(Mapping/Alignment) 是单细胞原始数据处理的基础步骤。它的核心目标是确定每个测序片段(sequenced fragment)在基因组或转录组中的可能来源位置(即找到与测序读段序列最相似的参考序列区域)。
根据测序方案的不同,原始测序文件可能会包含以下信息:
**细胞条形码(Cell Barcodes, CB) :**用于标记单个细胞
**分子唯一标签(UMI) :**用于区分不同RNA分子
cDNA读段序列(reads) :来自RNA分子的测序结果
作为单细胞数据处理的第一步 (图3.1),精确的比对至关重要。如果读段被错误地比对到基因或转录本上,下游分析(如生成基因表达矩阵)也会产生不正确或有误导性的结果。
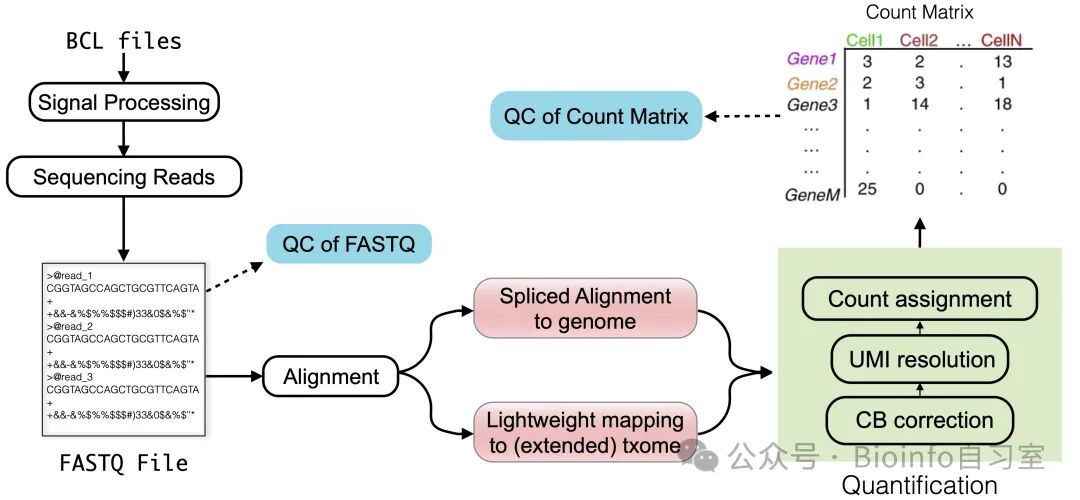 图1. 测序“上游分析”的全过程,也是本章的知识概览。在上一篇中大家也见过,还记得吗?
技术难题和专用工具
尽管序列比对技术早在单细胞RNA测序(scRNA-seq)出现前就已存在,但单细胞数据的规模(通常包含数亿到数十亿条读段)使得这一步骤需要极高的计算资源。此外,如果直接使用传统RNA-seq比对工具,由于这些工具不针对单细胞协议设计,会面临以下问题:
需要额外工具处理单细胞特有的信息(如细胞条形码和UMI的位置)
需单独完成样本解复用(demultiplexing)和UMI解析(UMI resolution)
生成大量中间文件,显著增加存储需求和读取/写入的操作时间
为此,研究者开发了专门针对scRNA-seq的比对工具 。这些工具能自动处理单细胞数据的特殊需求,例如10x Genomics的商业软件 Cell Ranger ,还有开源工具:zUMIs 、alevin 、RainDrop 、kallisto|bustools 、STARsolo 、**alevin-fry **等等。它们都提供了用户友好的操作界面,而且整合了技术序列解析(CB/UMI处理)、解复用和UMI解析功能,有些工具还采用了简化或避免中间文件的策略来应对庞大的数据量和计算负担。
尽管不同比对工具在算法、数据结构和计算资源权衡上差异显著,但可以从两个维度进行分类:比对算法的类型以及参考序列的类型。
3.2.1 比对算法的类型
在单细胞/单核RNA测序(sc/snRNA-seq)中,常用的比对算法可分为三类:剪接比对(spliced alignment) 、连续比对(contiguous alignment) 和轻量级映射(lightweight mapping)的变体。如图 3.14 所示,我们先将方法大体分为“基于比对(alignment-based)”与“基于轻量级映射(lightweight mapping)”两种。基于比对的方法会先通过一系列启发式算法(heuristics)来确定读长可能来源的参考基因组/转录组位置,然后再对每个候选位置做更细致的核苷酸级别的比对,并进行评分。这个过程通常依赖动态规划(dynamic programming)算法。与此相对,轻量级映射方法避免了核苷酸逐位的比对过程,而是基于 k-mer 等模式匹配或其衍生规则来快速判断读长可能映射到哪些位置,从而在很大程度上提升了速度与吞吐量。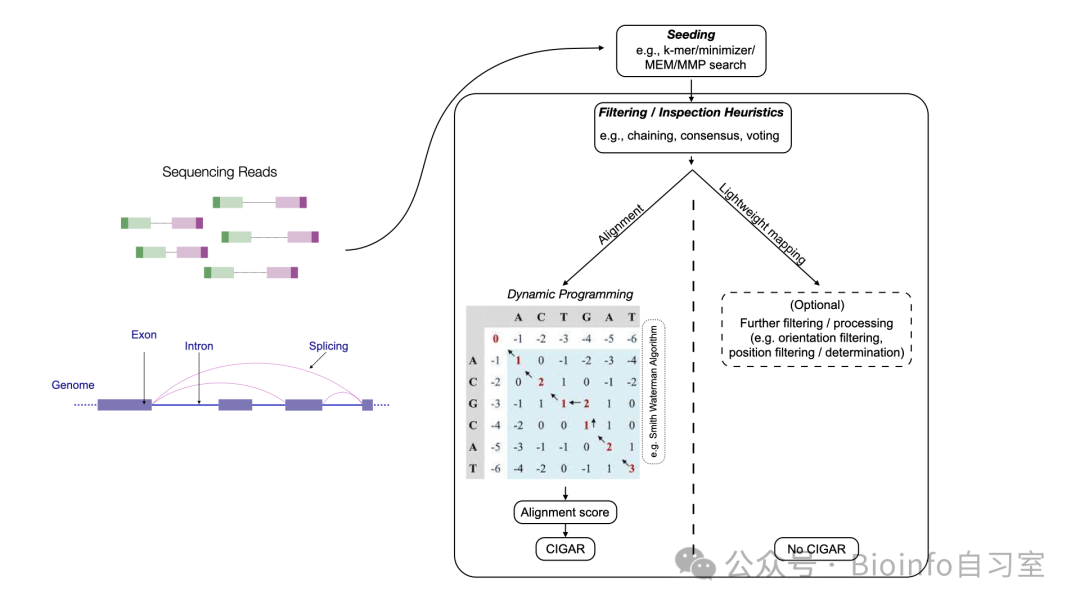 图2. 比对型方法和映射型方法的概览。两者的一大差别是,前者会生成一个“比对得分”而后者没有。
动态规划算法
动态规划(dynamic programming)算法被广泛用于解决比对问题,历史悠久且体系庞大。根据需求不同,比对可分为以下类型:
• 全局比对(global alignment):比对时要求读长和参考序列的所有碱基都需对
• 局部比对(local alignment):仅对序列的某个子片段进行最佳匹配。
• 半全局比对(semi-global alignment)(又称 “fitting” alignment):通常在短读长测序时使用。它假设读长的大部分能与参考序列的某个子串对齐,但允许读长两端或参考序列部分不对齐。
• “扩展”比对(extension alignment):允许在读长首尾对插入、缺失或错配施加更低的惩罚(即“软剪切”/soft-clipping),从而忽略或减轻读长边缘质量不佳带来的影响。
这些方法在本质上都依赖动态规划表(DP table),其时间复杂度(计算机概念,简单来说就是执行步骤的多少)与传统动态规划相当,但可通过各种技巧加以优化。
比对问题与动态规划
动态规划算法简单来说就是将原本复杂的大问题拆解成许多彼此相似、但规模更小的子题,分别求解后再把这些子问题的答案组合起来,最终得到原问题的解。其核心思路是:
1.拆解 :把问题按一定规则拆成相互关联的子问题;
2.储存 :把每个子问题的解(即“子答案”)都记录或缓存下来;
3.组合 :当更大子问题或整个问题需要用到之前子问题的解时,就直接调用已经算好的结果,而不必重新计算。
这样一来,整个过程可以节省大量重复计算,从而提升效率。
序列比对本质上可以看作一个 “最短路径”或“最少代价”的求解过程,具体可以理解为:
1.给定两个序列(例如基因组序列与测序read),我们想要找出它们之间的最佳匹配方式 。
2.匹配过程会有一些“花费”或“分值”规则——比如相同碱基对齐要加多少分;错配(mismatch)要扣分;插入或缺失(indel)要扣分;等等。
3.为了找到整体上分值最高(或代价最小)的对齐,需要尝试不同的对齐方式。如果我们从头到尾穷举所有可能性,计算量会非常庞大。
动态规划能很好地解决这一问题:
它把比对过程拆分为依次比较每个碱基 (或一部分子序列)与参考序列相应位置的更小问题;
在“比对矩阵”里,每个单元格代表一个子问题的“最佳匹配分数”,而这个子问题的解往往又依赖于更前面(或更上面)的子问题已求出的分数;
整个比对矩阵填满后,我们就可以从右下角 (或矩阵的某个末端)读出整段序列的最佳比对分数和对齐路径。
这样的设计恰恰符合动态规划的思路:重复的子问题 (每步都要比对“当前碱基和参考对应碱基”),逐步累积并复用结果 (比对矩阵上一格或左一格、斜上一格的结果,都是当前格需要用到的“子答案”)。
在基因组测序的比对场景中,许多算法采用了高级的改进和启发式策略 来提升效率和实际适用性,例如:
带限(banded)比对 :如果用户不关注低于某个阈值的比对得分,可跳过对大量 DP 单元格的计算。
X-drop和 Z-drop:能在早期“剪枝”,放弃潜在得分极低的比对路径。
波前比对(wavefront alignment):当存在高得分(低差异)比对时,可在理论和实际运算中显著减少时间和内存的花费。
对数据布局与并行计算的优化,以及将动态规划重构为更适合 SIMD 向量化(SIMD vectorization,即同时使用同一条指令对多份不同的数据进行并行处理)的形式 。
如今大多数常用的比对工具,都整合了这些高度优化和并行计算的方法,显著缩短了运行时间。
比对得分和比对路径
在得到比对得分的同时,我们还可以回溯该得分的实际的比对路径。这类信息通常以 CIGAR 字符串(Concise Idiosyncratic Gapped Alignment Report,简明特异性间隙比对报告)的形式存储在输出的 SAM/BAM 文件里。
CIGAR 字符串解读
一般的CIGAR包含这几种字符:
M: Match(匹配)或 Mismatch(错配)。
I: Insertion(插入)。
D: Deletion(删除)。
N: Skipped(跳过,通常用于表示内含子)。
S: Soft Clipping(软剪切,读取的一部分未比对,但仍保留在数据中)。
H: Hard Clipping(硬剪切,读取的一部分未比对,且从数据中移除)。
P: Padding(填充,用于表示在参考序列中插入的对齐间隙)。
例如:3M2D4M 表示前 3 个碱基为匹配/错配(M),随后在读长中有 2 个碱基对应的缺失(D,指参考上有但读长上没有),再接着 4 个碱基匹配/错配。Extended CIGAR可以区分匹配和错配:
=: 匹配。
X: 错配。
例如:3=2D2=2X表示前三个碱基为匹配(=),后两个匹配再加上两个错配(X)。
基于比对的方法在获得比对得分的同时,也能评估每个读长是否与参考序列“高质量”匹配,帮助过滤出因低复杂度或“偶然匹配”产生的错误映射。
全量比对(full-alignment) 工具:如 STAR 和 STARsolo 等,会进行完整的动态规划路径计算并输出结果。
选择性比对(selective alignment):如 salmon 和 alevin,会对比对得分进行评估,但省略对最优比对路径的详细回溯,减少了计算开销。
剪接比对和连续比对
在前文中提到,基于比对的方法还可细分为剪接比对与连续比对两类(基于轻量级映射的方法还无法实现比对)。
剪接比对(spliced alignment):可将序列读长按若干片段与参考基因组/转录组对齐,从而允许在读长中两个相邻片段对应到参考序列中相隔较远的位置(如跨越内含子或其他较大插入片段)。这在 RNA-seq 比对到基因组时极为重要,因为转录本可能跨越一个或多个剪接位点——读长在转录本中是连续的,但在基因组上可能分布在不同外显子和内含子之间。剪接比对面临的挑战在于,当只有很小一段读长跨越剪接位点时,需要充分利用极少量的信息来定位该片段。
连续比对(contiguous alignment):假定读长可在参考序列上找到一个连续的片段进行对齐。这类方法允许少量插入或缺失,但不会出现类似剪接比对的“数千碱基大跨度缺口”。
轻量级映射方法
最后,我们再回到与基于比对方法相对的轻量级映射,代表性算法包括pseudoalignment、quasi-mapping和带结构约束的 pseudoalignment。
如前文所述,此类方法不需要进行逐个碱基的运算,而是根据一组匹配的 k-mer(或其他准确匹配模式)的分布、方向、相对位置等规则,快速推断读长可能的映射位置。这样可以在速度和吞吐量上大幅超越传统比对方法,但由于缺少核苷酸级别的比对信息,难以获得基于比对得分的质量评估,也就不易判别读长与参考之间的匹配质量是否足以支持高置信度的比对。
总的来说,基于比对的方法能够提供更深入的质量评分和对齐细节,常用于需要精细分析的场景。轻量级映射方法则强调速度和通量,适合大规模或对核苷酸级别对齐不太敏感的工作流程。在 RNA-seq、特别是涉及可变剪接的场景下,可剪接比对至关重要;而对参考序列连续区域的比对需求用连续比对工具即可满足。
3.2.2 参考序列的类型
在映射算法(mapping algorithm)的选择上,不同的决策不仅存在于算法本身,还涉及到选择用于映射的参考序列。我们将参考序列分为三大类:
1. 完整的参考基因组(reference genome)
2. 已注释的转录组(annotated transcriptome)
3. 扩展的转录组(augmented transcriptome)
值得注意的是,目前并非所有的映射算法与参考序列的组合都是可行的。例如,目前尚不存在能够对参考基因组进行剪接映射的轻量级映射方法。
映射到基因组
第一类参考序列是目标生物体的整个基因组,通常在映射过程中会考虑已注释的转录本。采用这种方法的工具有 zUMIs、Cell Ranger 和 STARsolo。
由于许多读段来自剪接后的转录本(spliced transcript),这种方法允许对同一个读段进行跨一个或多个剪接位点(splicing junctions)的分段比对(split alignment)。
优点:
全覆盖:可以处理来自基因组任何位置的读段,不局限于已注释的转录本
索引(index)构建的边际成本低:基因组范围的索引构建完成后,处理额外的内含子区域读段几乎不增加计算成本。因此,基因组映射可适用于单细胞和单核测序数据
可扩展性:可以发现未注释区域的表达,有助于后期分析(如 Pool et al. 2022 发现的UTR区域延伸)
局限性:
内存需求大:以人类基因组为例,构建和存储索引需要32GB以上内存。虽然使用稀疏后缀数组压缩索引(sparse suffix array)可以节省存储空间,但这会降低比对的速度,前期构建索引需要的内存也并不会减少。
计算成本高:因为需要处理剪接位点以及计算比对得分,这类工具使用的算法通常较为复杂,计算负担较大。
样本限制:必须有可用的参考基因组,这对非模式生物可能构成挑战
映射到剪接转录组
为了减少对全基因组进行剪接比对所需的计算开销,广泛采用的替代方法是仅使用已注释转录本的序列作为参考。由于大多数单细胞实验来自转录组注释良好的模式生物(例如小鼠或人类),基于转录组的定量方法在读取覆盖度(read coverage)方面通常与基因组方法相似。
这种方法的优势 包括:
较小的参考序列 :相比基因组,转录组序列更小,减少了运行映射流程所需的计算资源。
简化比对过程 :相关的剪接模式已体现在转录本序列中,无需解决复杂的剪接比对问题,只需执行连续比对或映射。
适用多种方法 :由于只需发现连续比对,这既适用于传统比对算法,也适用于轻量级映射技术。许多流行工具选择剪接转录组作为映射目标,正是出于这一便利性。
然而,这种方法也存在以下局限性:
1. 无法捕捉来自剪接转录组之外的读段 :这个缺陷导致这类方法在处理单核数据时不适用。即使在单细胞实验中,来源于剪接转录组之外的读段也可能占据相当比例,并且越来越多的证据表明,这些读段可能含有重要的生物学信息,应纳入后续分析。
2. 可能导致错误比对 :当与轻量级映射方法结合使用时,剪接转录组与真正来源序列之间的一些短匹配可能造成假阳性,从而导致某些基因表达的错误甚至生物学上不合理的估计。
映射到扩展转录组
为了解决测序读段可能来自剪接转录本以外区域的问题,研究人员开发了扩展转录组的方法。这种方法是通过在剪接转录本序列中添加其他可能产生读段的参考序列(如完整未剪接的转录本或被切除的内含子序列)来实现的。
主要特点和优势:
相比完整基因组,索引大小较小
仍然只需要搜索连续的读段比对
比对速度更快,内存需求更低
可以处理来自剪接转录组之外的读段
使用轻量级比对方法时,能显著减少假阳性映射
广泛应用于单核测序数据分析和RNA速率分析
可用于大多数不需要与完整基因组进行剪接比对的分析方法
这种方法即使在处理常规的单细胞 RNA-seq 数据时也颇具价值。研究者们常构建一种名为 splici(意为 spliced + intronic)的扩展转录组用于映射与定量。splici 由剪接转录组序列以及注释基因内含子的合并区间序列共同组成,每条参考序列都会根据其注释的剪接状态 (splicing status) 进行标记。
这种策略的主要优势在于:一方面可以使用轻量级映射方法,同时显著减少错误比对;另一方面能够同时检测来自剪接与未剪接来源的读段,从而提高后续分析的灵敏度 。此外,由于在定量过程中会追踪并分别报告剪接状态,该方法将单细胞、单核以及 RNA 动力学的预处理流程统一起来,达到了速度和精度上的平衡,特别适合需要同时考虑多种RNA形式的研究项目。
后记
本篇仍然来自原书超硬核的第三章,带大家详细了解了测序数据中比对和映射的算法。剩余部分大约还能分成3-4部分,比如细胞条形码和UMI的处理、计数矩阵的生成和质控、alevin-fry实战代码等等。等整理完成给大家一次性更新暗号和资料哦!
下篇预告:Cell Barcode和UMI的处理。敬请期待!
---