SCIPAC助力发现临床相关细胞群
SCIPAC助力发现临床相关细胞群
今天给大家介绍一个非常宝藏的R包——SCIPAC 。这个包在2024年发表在老牌顶刊 Genome Biology 上,用于定量评估单细胞数据中每个细胞与临床表型的关联强度,简单来说就是帮你找到那些与疾病最相关的"明星细胞群" 。
🔍 为什么需要SCIPAC?
传统方法的困境
你手里有一份乳腺癌的单细胞数据,发现了好几种T细胞亚群。你想知道,哪些T细胞真正与肿瘤恶性程度相关?哪些是中立?
传统的单细胞分析只能告诉你细胞类型,但无法量化它们与临床表型的关系。一般的科研工作者面对这个问题,可能会考虑导出每种亚群的标志基因集,然后去公共数据库做相关性分析。但是这种方法存在许多缺陷:
- 基因≠细胞比例 :某个基因在TCGA中高表达,并不意味着表达这个基因的细胞在肿瘤中比例高。一个细胞可能表达量很低,但数量很多;另一个细胞表达量很高,但数量很少。
- 批次效应严重 :单细胞数据和bulk数据来自不同的实验平台、处理方法,直接比较容易产生假阳性结果。
- 缺乏统计框架 :这种"拍脑袋"的分析方法缺乏严格的统计学基础,无法给出p值或置信区间。
- 工作量巨大 :需要逐个分析每种细胞类型,手动整理基因集,效率极低且容易出错。
更早发布、更知名一些的Scissor方法(Sun et al. , Nat Biotech 2021),虽然开创性地提出了单细胞-bulk数据联合分析的思路,但也只能简单地把细胞分为"正相关"、"负相关"和"无关"三类,缺乏定量信息:
- 🔴 Scissor+细胞 :与表型正相关,但关联有多强?
- 🔵 Scissor-细胞 :与表型负相关,但影响有多大?
- ⚪ 背景细胞 :真的无关吗?还是关联强度太弱?
并且,Scissor的结果高度依赖参数调节,不同的α值会给出截然不同的结果,而且没有提供选择最优参数的客观标准。研究者往往需要"试错"多个参数,然后选择"看起来合理"的结果——这显然不够科学。
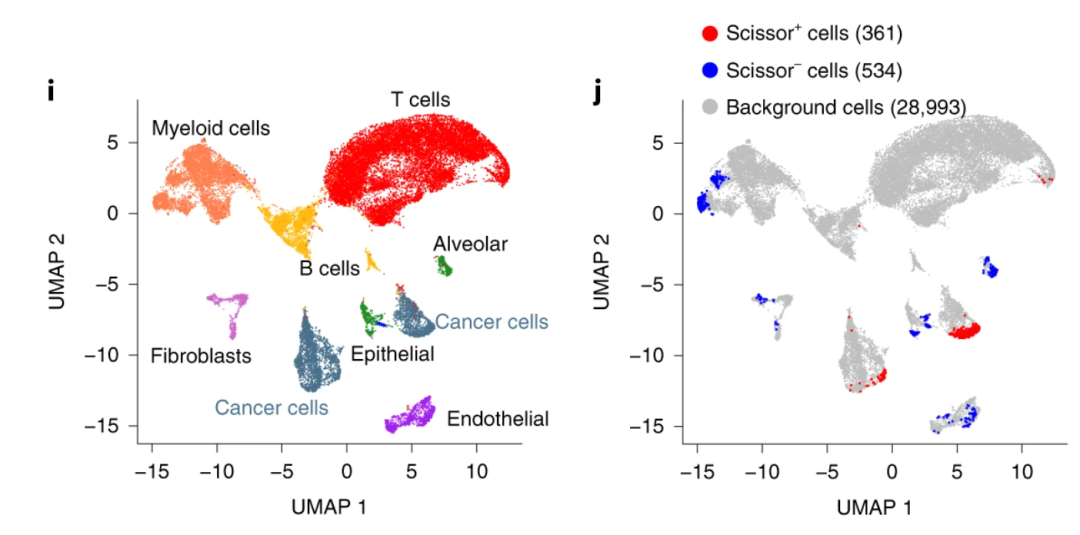 Scissor示例。Sun et al., Nat Biotech 2021
这正是SCIPAC要解决的核心问题:不仅要告诉你哪些细胞与疾病相关,更要精确量化这种关联的强度,并给出统计学显著性检验。
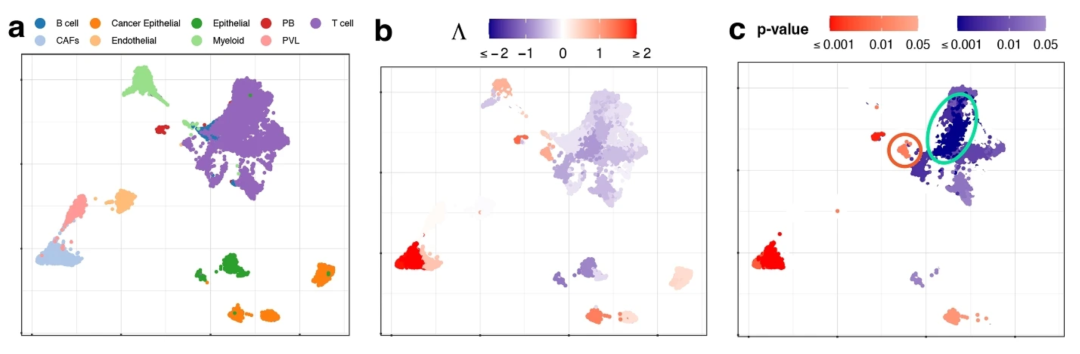 SCIPAC示例。Gan et al., Genome Biol 2024
SCIPAC的创新之处
SCIPAC的核心思想很简单:如果某种细胞在组织中的比例增加会提高疾病发生的概率,那这种细胞就与疾病正相关。
它的优势包括:
- 定量评估 :给出具体的关联强度数值(λ值)
- 统计显著性 :为每个关联提供p值
- 多种表型支持 :二分类、连续变量、生存数据、有序分类
- 计算高效 :比Scissor快几十倍
- 参数友好 :几乎不需要调参
- Seurat集成 :与标准单细胞分析流程完美融合
实战:GSE176078乳腺癌数据
接下来,我们使用一个真实数据集带大家上手SCIPAC。
 Wu et al., Nat Genet 2021
这是一个乳腺癌的单细胞数据集,一共有26个样本,涵盖HER2、ER、TNBC三个分型,可在GSE176078下载。
准备工作:
- 注释好的Seurat object
obj(或原始计数矩阵+注释信息)格式要求是行为基因名,列为细胞条码。 - 带有临床信息的bulk RNA-seq表达矩阵,有标准化的格式(TPM/RPKM/FPKM/RSEM)最好,没有也可以手动标准化。格式要求是行为基因名,列为样本名。
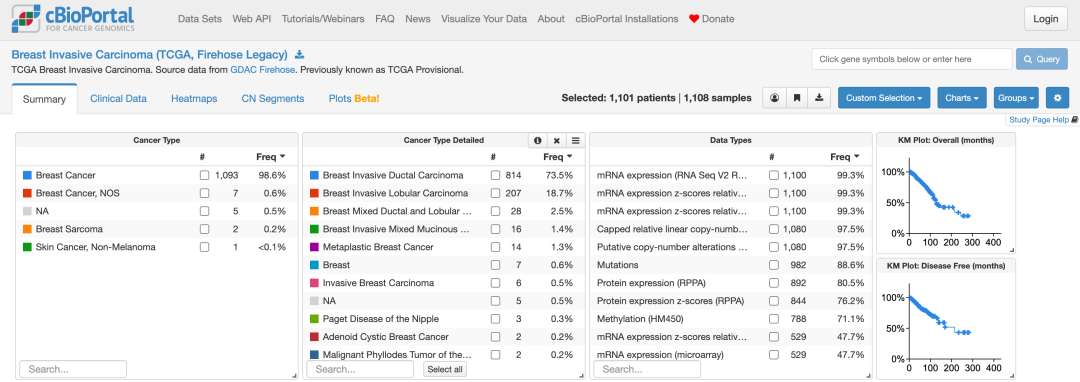 TCGA_BRCA (firehose legacy)
安装和加载必要R包
devtools::install_github('RavenGan/SCIPAC')
library(Seurat)
library(SCIPAC)
library(tidyverse)
处理一下刚下载的bulk数据(RSEM是已经标准化的格式,所以不用二次处理):
# 表达矩阵,记得替换成实际路径
tcga_expr <- read.delim("brca_tcga/data_mrna_seq_v2_rsem.txt", comment.char="#")
# 样本信息
tcga_sample <- read.delim("brca_tcga/data_clinical_sample.txt", comment.char="#")
# 病人信息
tcga_patient <- read.delim("brca_tcga/data_clinical_patient.txt", comment.char="#")
# 合并一下临床信息
tcga_meta <- left_join(tcga_sample, tcga_patient, by="PATIENT_ID")

# 数据清洗,请根据实际情况来
# 提取基因名作为行名
tcga_expr <- tcga_expr %>% aggregate(. ~ Hugo_Symbol, FUN=sum) %>%
  select(-Entrez_Gene_Id) %>%
  column_to_rownames("Hugo_Symbol")

# 统一一下列名和sample id的格式
tcga_meta$SAMPLE_ID <- gsub("-", "\\.", tcga_meta$SAMPLE_ID)

# 保证临床信息和rna-seq样本一一对应
tcga_meta <- tcga_meta %>%
  filter(SAMPLE_ID %in% colnames(tcga_expr)) %>%
  arrange(match(SAMPLE_ID, colnames(tcga_expr)))
# 检查,应该返回TRUE
all(tcga_meta$SAMPLE_ID == colnames(tcga_expr))

# 处理一下NA数据
tcga_meta[tcga_meta == "[Not Available]"] <- NA
tcga_meta[tcga_meta == "[Not Applicable]"] <- NA
# 看看哪些临床数据有NA
colSums(is.na(tcga_meta))

dim(tcga_expr) # 20513  1100
dim(tcga_meta) # 1100  137
接下来是单细胞数据,这里只需要用到原始计数矩阵(也可以通过obj[["RNA"]]$counts提取)。刚好原文章还提供了原始注释数据。
data.path <- "~/Downloads/GSE176078_RAW/"
# 读取原始矩阵
dat <- ReadMtx(mtx=paste0(data.path, "count_matrix_sparse.mtx"),
               cells = paste0(data.path, "count_matrix_barcodes.tsv"),
               features=paste0(data.path, "count_matrix_genes.tsv"), feature.column = 1)
meta <- read.csv(paste0(data.path, "metadata.csv"))
obj <- CreateSeuratObject(dat, meta.data = meta)

# 标准预处理过程简化,仅为教程展示!
obj <- NormalizeData(obj) %>%
  FindVariableFeatures() %>%
  ScaleData() %>%
  RunPCA() %>%
  RunUMAP(dims = 1:30) %>%
  FindNeighbors(dims = 1:30) %>%
  FindClusters(resolution = 0.5)

obj
An object of class Seurat
29733 features across 100064 samples within 1 assay
Active assay: RNA (29733 features, 2000 variable features)
 3 layers present: counts, data, scale.data
 2 dimensional reductions calculated: pca, umap
SCIPAC:预处理
有了单细胞和bulk的数据,我们下一步就可以准备运行SCIPAC了。先进行一个共高变基因的筛选(默认1000个):
# 直接使用上文的dat作为SCIPAC的输入
# 如果已有seurat对象,也可以这么提取:
dat <- obj[["RNA"]]$counts

# 预处理
sc.bulk.prec <- preprocess.sc.bulk.dat(dat, tcga_expr, hvg = 1000)
# 返回一个list,包含处理过的单细胞和bulk数据
# 处理完后两组数据都有同样的1000个基因
sc.dat.prep <- sc.bulk.prec$sc.dat.preprocessed
bulk.dat.prep <- sc.bulk.prec$bulk.dat.preprocessed
dim(sc.dat.prep) # 1000 99664
dim(bulk.dat.prep) # 1000 1100
all(rownames(sc.dat.prep)==rownames(bulk.dat.prep)) # TRUE
preprocess.sc.bulk.dat这个函数本质上就是:
- 筛选单细胞/bulk数据中重叠的基因
- 重新计算单细胞数据中的1000个高变基因
- 最后对单细胞/bulk数据取子集
因为之后的步骤都只会使用子集,大大加快了运算速度,所以用来处理十几万-几十万个细胞的数据集也没问题。实际使用的时候,如果想提高精度,可以增加高变基因的数量。
SCIPAC: PCA 降维
下一步是进行共PCA降维。
# 默认60个pc,可根据实际修改
pca.res <- sc.bulk.pca(sc.dat.prep, bulk.dat.prep, do.pca.sc = FALSE, n.pc = 60)

# 提取降维矩阵
sc.dat.dim.redu <- pca.res$sc.dat.rot
bulk.dat.dim.redu <- pca.res$bulk.dat.rot

# 查看降维结果
dim(sc.dat.dim.redu) # 99664  60
dim(bulk.dat.dim.redu) # 1100  60
sc.bulk.pca函数做了两件事:
- 对bulk数据进行降维
- 将得到的PCA旋转矩阵(rotation matrix)应用到单细胞上
这里的逻辑是使用bulk数据的主成分方向来转换单细胞数据。如果do.pca.sc = TRUE,则反过来先对单细胞数据进行降维,再应用到bulk数据上。两种方式都可以,目的是使两组数据投影到同一个潜在空间(latent space) 上。因此,降维方式也不一定要局限于PCA,有兴趣的读者朋友也可以尝试其他的降维方法,如MDS、NMF等。
⚠️小编注: 共降维实际上非常重要。由于单细胞数据和bulk数据分布和特征空间有本质上的不同,只有在同一个空间中,才能直接比较两种数据,且进行下游的整合分析。
SCIPAC:聚类
ct.res <- seurat.ct(sc.dat.dim.redu, res = 1.5)
summary(ct.res) # 返回list
#              Length Class      Mode
#k                1   -none-     numeric
#ct.assignment    1   data.frame list
#centers       3420   -none-     numeric
这一步调用了Seurat的FindNeighbors和FindClusters进行聚类(也可以自行使用其他方法聚类),并返回聚类数k,每个细胞所在群ct.assignment和群的中心点centers。之后判断与表型有关的细胞时,会以这里的聚类结果为单位。因此,想要获得更细的表型预测结果,可以提高res。
⚠️小编注: 有的读者朋友可能会好奇为什么这里不直接使用Seurat对象里的聚类结果。这是因为SCIPAC使用了与Seurat不一样的预处理步骤(如基因与bulk取交集、高变基因的数量、使用bulk的PCA矩阵等)。理论上,如果从一开始就使用基因完全一致的两组数据,保持各项参数一致(高变基因、PCs、聚类res等),并选择把单细胞的PCA维度映射到bulk上,也可以直接使用Seurat对象中的现成结果。
SCIPAC:预测表型相关细胞
完成了以上步骤,我们就可以选择一个感兴趣的表型,并预测单细胞数据中与表型相关的细胞了。
在SCIPAC主函数中,我们会用到以下数据:
- PCA降维后的bulk数据(矩阵),
bulk.dat.dim.redu - 表型向量/矩阵,
y - 单细胞聚类结果,
ct.res
注意,表型向量y的长度应与bulk.dat.dim.redu的行数一致(即与bulk样本一一对应)。如果有NA值,应将y和bulk.dat.dim.redu都做对应处理。
接下来我们使用三种不同类型表型进行演示,分别是肿瘤复发状态(二元数据)、肿瘤分期(有序数据)、生存状态/时长。
1. 肿瘤复发状态(二元)
TCGA-BRCA的临床数据中有病人的复发状态TUMOR_STATUS。
table(tcga_meta$TUMOR_STATUS, useNA = "always")

#TUMOR FREE WITH TUMOR       <NA>
#       879         96        125

# 删除NA值,并对PCA降维也做相应处理
tcga_meta.sub <- tcga_meta[-is.na(tcga_meta$TUMOR_STATUS), ]
bulk.dat.dim.redu.sub <- bulk.dat.dim.redu[rownames(bulk.dat.dim.redu)%in%tcga_meta.sub$SAMPLE_ID, ]

# 将y定义成二元向量
y <- ifelse(tcga_meta.sub$TUMOR_STATUS=="WITH TUMOR", 1, 0)

# 检查
all(rownames(bulk.dat.dim.redu.sub) == rownames(y)) # TRUE
接下来运行SCIPAC,此时family要选binomial,其他使用默认即可。
SCIPAC.res <- SCIPAC(bulk.dat = bulk.dat.dim.redu.sub, y = y,
                     family = "binomial", ct.res = ct.res,
                     ela.net.alpha = 0.4, bt.size = 50,
                     numCores = 7, CI.alpha = 0.05, nfold = 10)
该函数输出一个六列的表,具体内容如下:
| 列名 | 含义 | 说明 |
|---|---|---|
| cluster_assignment | 聚类分配 | 每个细胞所属的聚类编号 |
| Lambda.est | 关联强度估计值 | 细胞与表型的关联程度 |
| 正值=正相关,负值=负相关 | ||
| Lambda.upper/lower | 置信区间 | Lambda.est的统计置信区间边界 |
| sig | 显著性标记 | • Not.sig:不显著 |
| • Sig.pos:显著正相关 | ||
| • Sig.neg:显著负相关 | ||
| log.pval | 对数p值 | 有方向性的p值,log.pval的正负号对应于Lambda.est的正值或负值 |
Lambda是"细胞类型-表型关联强度"的定量指标,反映了当某种细胞类型比例增加时,对表型出现概率的影响程度 。
简单可视化一下:
# 将SCIPAC结果添加到Seurat对象
obj <- AddMetaData(obj, metadata = SCIPAC.res)

library(RColorBrewer)
p1 <- DimPlot(obj, group.by = "celltype_major", label=T)
p2 <- FeaturePlot(obj, "Lambda.est", order=T) +
  scale_color_gradientn(colours = rev(brewer.pal(11, "RdBu")))+
  ggtitle("Lambda (Tumor Status)")
p3 <- DimPlot(obj, group.by="sig") + ggtitle("sig")
p1+p2+p3
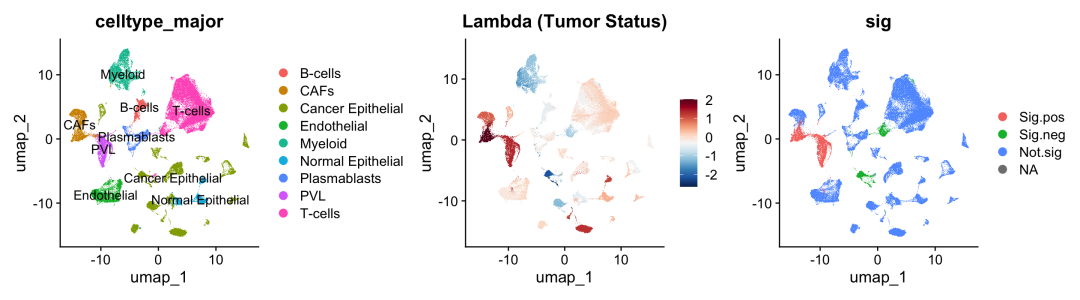 预测肿瘤状态相关细胞
SCIPAC预测CAF与PVL与肿瘤复发显著正相关。
2. 肿瘤分级(有序)
这里我们使用AJCC_PATHOLOGIC_TUMOR_STAGE作为分级标准。
# tumor stage
table(tcga_meta$AJCC_PATHOLOGIC_TUMOR_STAGE, useNA = "always")
#[Discrepancy]       Stage I      Stage IA      Stage IB      Stage II     Stage IIA     Stage IIB     Stage III    Stage IIIA
#            6            90            85             6             6           359           259             2           155
#   Stage IIIB    Stage IIIC      Stage IV       Stage X          <NA>
#           27            67            20            13             5
# 删除discrepancy和na数据
na.ids <- which(is.na(tcga_meta$AJCC_PATHOLOGIC_TUMOR_STAGE))
dis.ids <- which(tcga_meta$AJCC_PATHOLOGIC_TUMOR_STAGE=="[Discrepancy]")
tcga_meta.sub <- tcga_meta[-c(na.ids,dis.ids), ]
bulk.dat.dim.redu.sub <- bulk.dat.dim.redu[rownames(bulk.dat.dim.redu)%in%tcga_meta.sub$SAMPLE_ID, ]

# 定义y为因子
y <- factor(tcga_meta.sub$AJCC_PATHOLOGIC_TUMOR_STAGE)
# 确认顺序没问题(从小到大)
levels(y)
#[1] "Stage I"    "Stage IA"   "Stage IB"   "Stage II"   "Stage IIA"  "Stage IIB"  "Stage III"  "Stage IIIA" "Stage IIIB"
#[10] "Stage IIIC" "Stage IV"   "Stage X"
# 确认行名一致
all(rownames(bulk.dat.dim.redu.sub) == rownames(y)) #TRUE
运行SCIPAC,注意这里的family要选cumulative:
SCIPAC.res <- SCIPAC(bulk.dat = bulk.dat.dim.redu.sub, y = y,
                     family = "cumulative", ct.res = ct.res,
                     ela.net.alpha = 0.4, bt.size = 50,
                     numCores = 7, CI.alpha = 0.05, nfold = 10)
结果中的Lambda,正值表示跟更高的分级相关,负值表示更更低的分级相关(或与高分级负相关)。
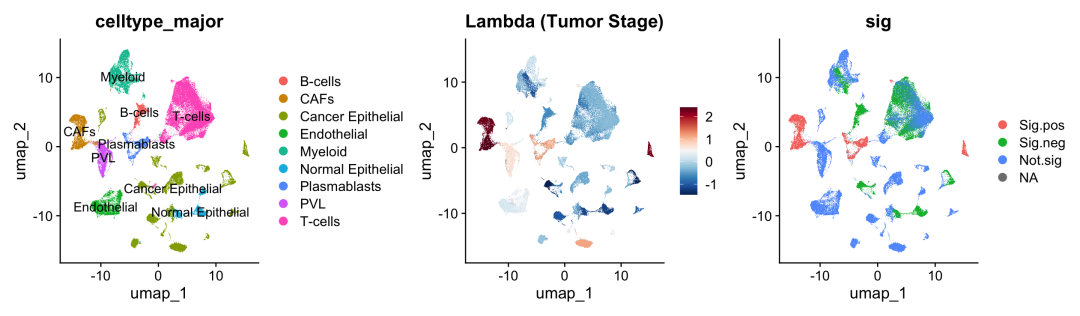 预测肿瘤分级相关细胞
这里,CAF细胞显著与高分级肿瘤相关。
3. 生存信息
这里我们使用OS_STATUS和OS_MONTHS的生存状态和生存时间。
table(tcga_meta$OS_STATUS, useNA = "always")
# 去除无效生存信息
na.ids <- c(which(is.na(tcga_meta$OS_STATUS)),which(is.na(tcga_meta$OS_MONTHS)))
neg.ids <- which(tcga_meta$OS_MONTHS <= 0)

tcga_meta.sub <- tcga_meta[-c(na.ids, neg.ids), ]
bulk.dat.dim.redu.sub <- bulk.dat.dim.redu[rownames(bulk.dat.dim.redu)%in%tcga_meta.sub$SAMPLE_ID, ]

# 定义y为cox模型适用的两列数据框
y <- tcga_meta.sub[, c("OS_MONTHS", "OS_STATUS")]
# 生存状态为二元
y$OS_STATUS <- ifelse(y$OS_STATUS == "0:LIVING", 0, 1)
# 固定列名
colnames(y) <- c("time", "status")

# 转换成数字
y$time <- as.numeric(y$time)
y$status <- as.numeric(y$status)
# 添加行名
rownames(y) <- tcga_meta.sub$SAMPLE_ID
# 确认行名一致
all(rownames(bulk.dat.dim.redu.sub) == rownames(y))
运行SCIPAC,注意这里的family要选cox:
SCIPAC.res <- SCIPAC(bulk.dat = bulk.dat.dim.redu, y = y,
                     family = "cumulative", ct.res = ct.res,
                     ela.net.alpha = 0.4, bt.size = 50,
                     numCores = 7, CI.alpha = 0.05, nfold = 10)
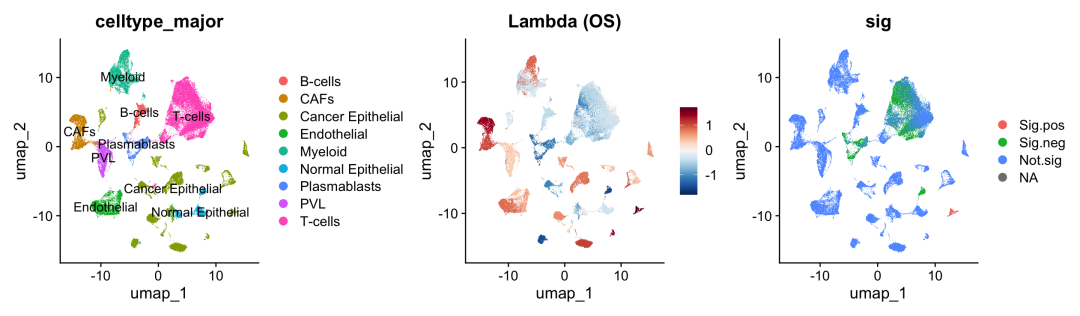 预测生存信息相关细胞
生存信息的Lambda解读如下:
- 正Lambda (λ > 0): 预后更差 (生存时间更短,风险更高)
- 负Lambda (λ < 0): 预后更好 (生存时间更长,风险更低)
⚠️小编注: 在Cox回归中,模型估计对数风险比。由于SCIPAC内部使用Cox回归,所以应该这么解读:
- 正系数 → 风险增加 → 死亡风险增加 → 生存期缩短
- 负系数 → 风险降低 → 死亡风险降低 → 生存期延长
这里我们发现,T细胞与B细胞大体与更好的预后相关(副系数)。
其他应用场景
除了以上三种数据,SCIPAC还支持一般的连续数据(比如血液指标、肿瘤大小等),此时在主函数使用family='gaussian'即可。可以说只要你有相关临床数据,没有什么是SCIPAC不能推测的。
小结
通过这个完整的实战案例,我们看到了SCIPAC的强大威力:
核心优势回顾
- 定量精准 - 不再是简单的"相关/不相关",而是给出具体的λ值
- 统计严谨 - 每个结果都有p值支撑,告别"拍脑袋"分析
- 多表型支持 - 二分类、有序、生存、连续数据全覆盖
- 操作简单 - 核心分析不到20行代码,上手门槛极低
- 结果可信 - 基于严格的数学模型,结果可重现
实战收获
在GSE176078乳腺癌数据集上,我们成功发现:
- 肿瘤状态 :CAF和PVL细胞与肿瘤复发显著正相关
- 肿瘤分级 :CAF与高级别肿瘤强烈关联
- 生存预后 :T细胞和B细胞是患者生存的保护性因素
这些发现不仅与现有文献高度一致,更重要的是我们获得了定量的关联强度 ,为后续的机制研究和临床转化提供了精确的数值基础。
与Scissor的对比
| 特性 | SCIPAC | Scissor |
|---|---|---|
| 结果类型 | 定量λ值 + p值 | 定性分类 |
| 参数调节 | 几乎免调参 | 需要反复尝试α值 |
| 计算速度 | 快几十倍 | 相对较慢 |
| 表型支持 | 全类型支持 | 主要支持二分类 |
| 统计框架 | 严格的Bootstrap | 缺乏统计检验 |
写在最后
SCIPAC代表了单细胞数据分析的一个重要进步方向——从描述性分析走向预测性分析 。它不仅能告诉我们"是什么",更能回答"有多强"的问题。
在精准医学时代,这种定量化的细胞-表型关联分析将成为连接基础研究与临床应用的重要桥梁。相信随着更多研究者的使用和反馈,SCIPAC会变得更加完善,为推动疾病机制研究和临床转化贡献更大力量。
参考文献
- GitHub仓库 : https://github.com/RavenGan/SCIPAC
- 原论文 : Gan et al. SCIPAC: quantitative estimation of cell-phenotype associations. Genome Biology 2024
- 数据下载 : GSE176078 (单细胞), cBioPortal (TCGA-BRCA)
本文所有分析代码及示例数据,可以在后台回复SCIPAC获取。本教程完全原创,转载请注明来源~如果有任何问题,欢迎留言或评论区讨论哦!