玩转大模型:API初探
玩转大模型:API初探


玩转大模型
API初探
开启妙用
“玩转大模型” 是2025年Bioinfo自习室新开的系列,目标是帮助每一位对AI感兴趣的读者,从零开始掌握大模型的应用技巧,并将其无缝嵌入到日常科研和工作流程中。我们预计将涵盖LLM的基础应用、文献解读、LLM在生物医学领域的前沿研究,以及分享好用的智能工具等内容。

从网页版到API


什么是API?
API,全称为应用程序编程接口(Application Programming Interface), 可以看作是不同软件系统之间沟通的桥梁。对于大模型来说,API 就是让你能够在自己的程序或科研项目中调用这些预训练模型的接口。简单来说,通过 API,你可以把大模型的能力嵌入到自己的应用中,比如自动文本生成、语义分析、数据摘要等,而不必手动操作网页版的聊天窗口或操作界面。在高度个性化的同时,它还不占用本地的计算资源,也不受网页版的诸多限制(例如上下文长度)。
API有什么优势?
自动化与批处理:
网页版适合单次操作,但如果你需要对大量数据进行处理,比如批量生成实验报告、分析上千篇文献摘要,API 可以轻松实现自动化操作。
选择多样,成本灵活:
像水电费一样,API 只为实际使用的 AI 算力付费,适合经费有限的项目。同时,用户还可以根据任务和预算灵活选择不同的模型,或是借助 API 平台(如 OpenRouter),同时调用多个大模型,比较它们在相同任务上的表现。
定制与集成:
API 调用让你可以灵活地设置请求参数、控制生成内容风格和长度,从而更好地满足科研需求。更重要的是,你可以将大模型的功能无缝集成到自己的工具链或平台中,实现定制化服务。许多高级功能(如多轮对话、上下文管理、自定义指令)也只有通过 API 才能实现。

你的第一个API

开发者平台
主流的商业大模型比如GPT (platform.openai.com)、Claude (console.anthropic.com) 都有自己的开发者平台。对于开源的大模型,Hugging Face也提供有限的API,用于原型测试。获取API key一般分三步走: 1.注册开发者平台账号;2. 充值(坏消息:要钱;好消息:一般不太贵或者有免费额度);3. 生成API密钥。
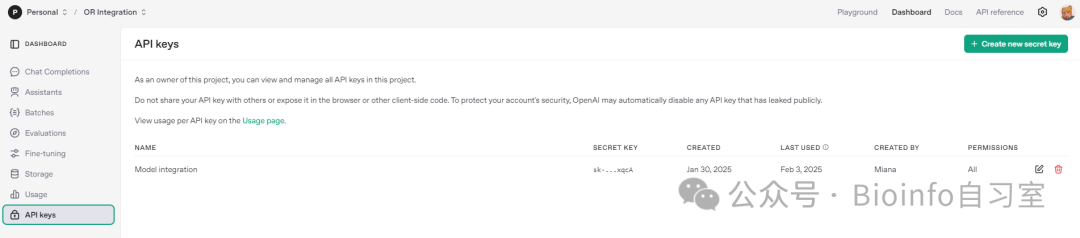
OpenAI的开发者界面,sk-开头的那一长串就是API密钥。生成的时候如果没有保存,在这个界面是没办法点开重新看的。
⚠️注意:API密钥是非常重要的东西,在生成时就要保管好,不要泄露或遗失。这就像家里的门锁一样,如果不慎丢失了钥匙,只能重新配一把锁(重新生成API key)
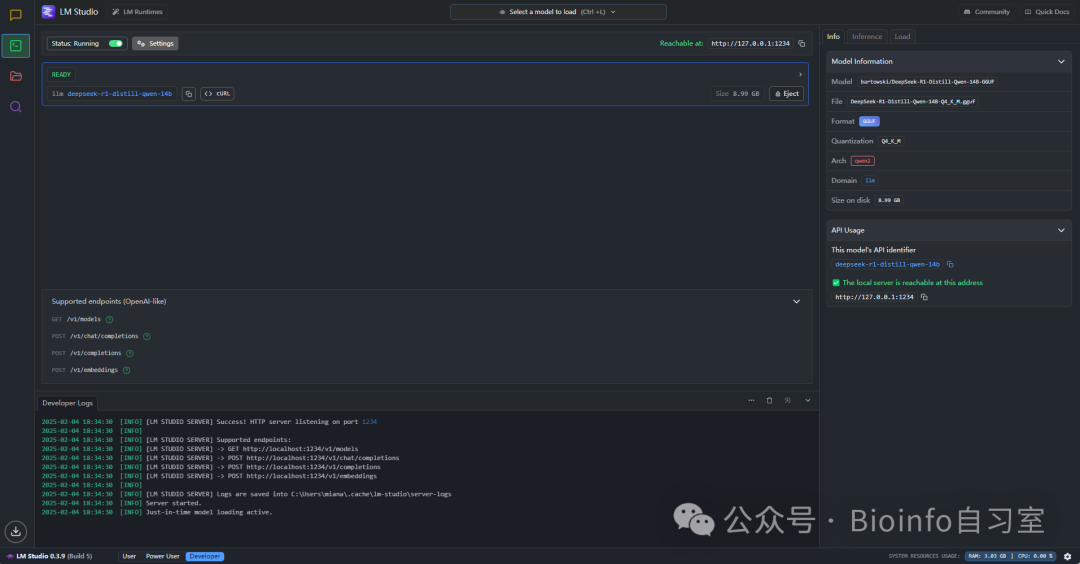
上一篇我们介绍过的LM Studio,也可以为在本地服务器启用API服务,但此时并不需要生成API key,因为调用本地大模型的时候不涉及到第三方服务器。
除了商业大模型自己的开发者平台,有许多第三方云服务也提供API服务,比如AWS、谷歌、阿里云、OpenRouter,还有最近很火的SiliconFlow硅基流动。这些第三方平台有的能提供“一码多用”,让用户通过一个统一的接口或API密钥,调用多个模型或服务,从而让用户可以灵活选择最适合自己需求的模型;有的提供比官方更实惠或灵活的价格,或是可以根据地区降低延迟。
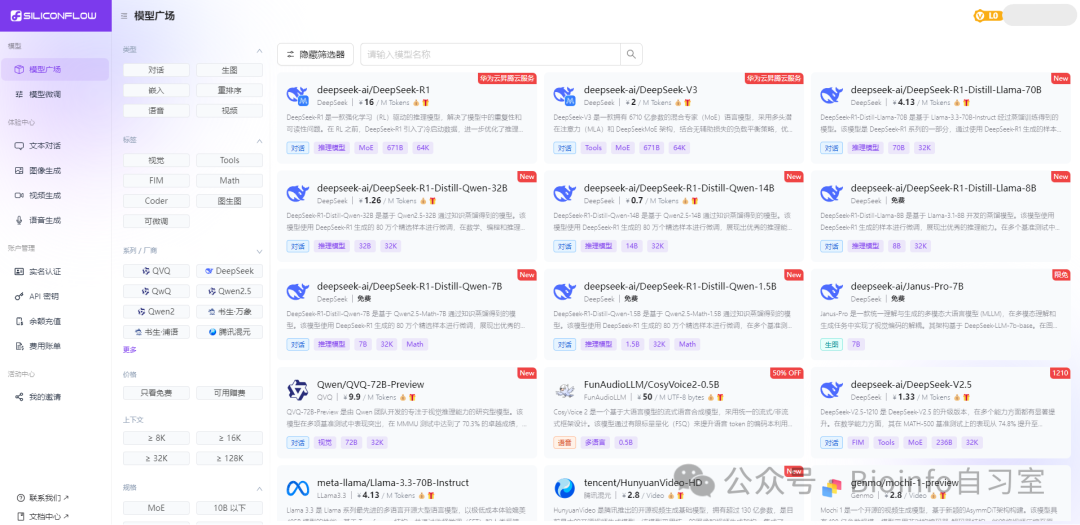
SiliconFlow的模型广场,有许多多模态的模型(文生图、视频音频生成)可选
API的用法
如何调用API?
API 的使用通常分为两部分:发送请求和接收响应。无论你是编程高手还是完全不懂代码的小白,都可以找到适合自己的方法来使用 API。
1. 编程中的直接调用
如果你熟悉编程,可以通过 Python/R 等语言轻松调用 API。以下是一个简单的例子,展示如何在Python使用 OpenAI 的 API 来生成一段关于CRISPR-Cas9的介绍(以下的代码基本上是通用的模板,对于不同平台,只需要替换url和api_key就可以了)
import requests
import json

# 替换为你自己的API密钥
api_key = "sk-你的API密钥"

# 定义API的URL(以OpenAI的GPT接口为例)
url = "https://api.openai.com/v1/completions"

# 设置请求头和参数
headers = {
    "Content-Type": "application/json",
    "Authorization": f"Bearer {api_key}" # 本地大模型不需要key
}

data = {
    "model": "text-davinci-003",   # 选择使用的模型
    "prompt": "请用简洁的语言解释什么是CRISPR-Cas9",
    "max_tokens": 100,             # 控制回答的长度
    "temperature": 0.7             # 控制回答的随机性
}

# 发起POST请求
response = requests.post(url, headers=headers, data=json.dumps(data))

# 解析并打印返回结果
if response.status_code == 200:
    result = response.json()
    print("生成的文本:", result['choices'][0]['text'].strip())
else:
    print("请求失败,状态码:", response.status_code)
    print("错误信息:", response.text)
在R中,同样的请求是这么实现的:
library(httr)
library(jsonlite)

# 替换为你自己的 API 密钥
api_key <-"sk-你的API密钥"

# 定义 API 的 URL(以 OpenAI 的 GPT 接口为例)
url <-"https://api.openai.com/v1/completions"

# 构造请求体数据
data <-list(
  model ="text-davinci-003",          # 使用的模型
  prompt ="请用简洁的语言解释什么是CRISPR-Cas9。",
  max_tokens =100,                    # 控制回答的长度
  temperature =0.7                    # 控制回答的随机性
)

# 发起 POST 请求
response <- POST(
  url,
  add_headers(
    "Content-Type"="application/json",
    "Authorization"= paste("Bearer", api_key)
),
  body = toJSON(data, auto_unbox =TRUE)
)

# 检查响应状态并解析返回内容
if(status_code(response)==200){
  result <- content(response,"parsed")
  cat("生成的文本:\n", result$choices[[1]]$text,"\n")
}else{
  cat("请求失败,状态码:", status_code(response),"\n")
  cat("错误信息:", content(response,"text"),"\n")
}
以上提供的只是一个非常简易的模板。对于复杂的任务,可以通过修改“prompt”部分灵活处理各种各样的需求。
2. 第三方工具集成
有不少第三方工具支持调用大模型的API,不仅限于编程环境下的直接调用,而是以插件或内置功能的形式,融入到日常工作流程中。小编平时爱用的Cursor就是其中一个例子。
Cursor 是一个智能代码编辑器,它可以集成大模型(例如 OpenAI 的 GPT 系列)的API,帮助生成代码、自动补全甚至调试建议,还可以一键应用到代码中运行,属实是生产力神器,且大大降低了写码门槛。它提供付费的Pro版本,让用户可以使用Claude、GPT等大模型自动补完代码,但免费用户也可以自己接入API实现大部分的功能(某些高级功能不支持)。比如,我们让Cursor写一个计算qPCR的Fold Change的程序 (使用cursor自带的deepseek-r1),还挺像模像样的。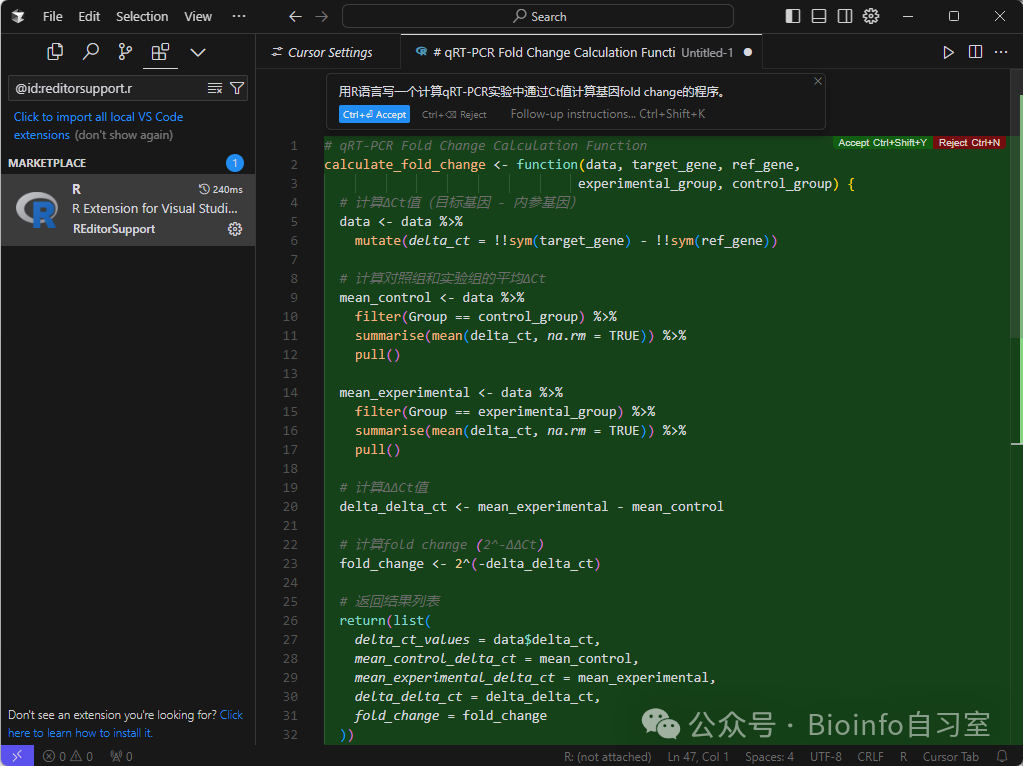 想添加自己的API密钥也很简单,打开设置界面→Models,在你想使用的模型下添加api key就可以啦~如果使用第三方云服务,记得把url部分也替换噢。
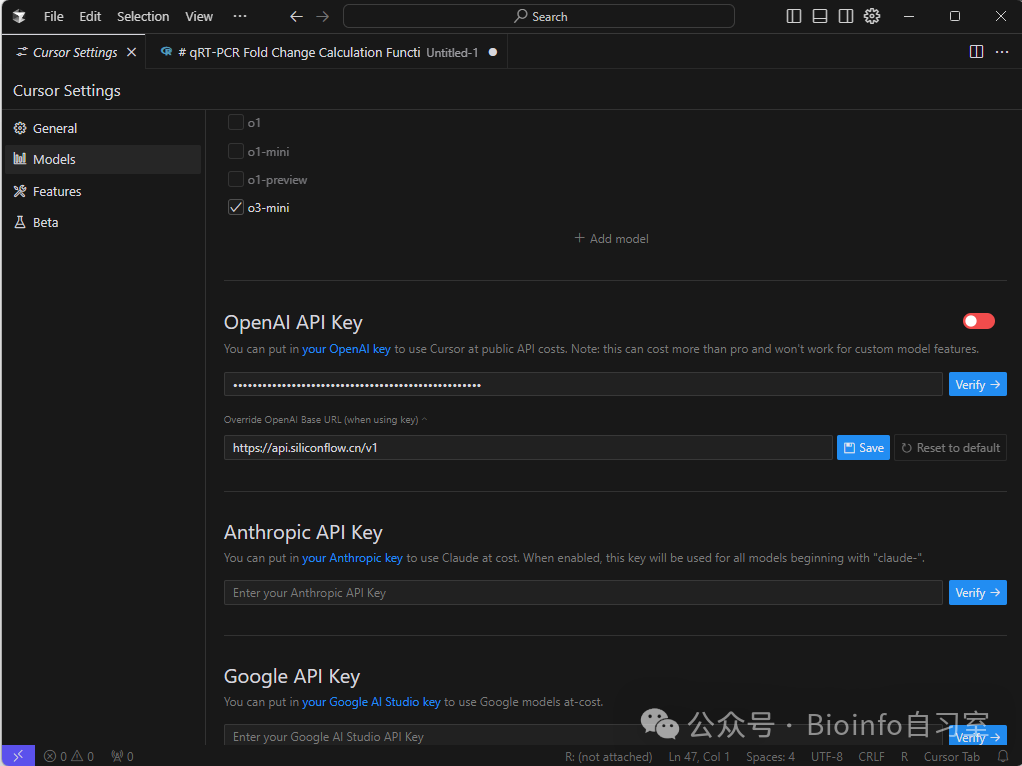
本篇内容就到这里啦~祝大家玩大模型开心!本来想顺便分享一下硅基流动的邀请码,给大家送点额度,但是在本文发布时SiliconFlow因为太火了服务不太稳定,暂时也关闭了邀请功能。想要尝试的同学还可以看看Nvidia NIM(https://build.nvidia.com/deepseek-ai/deepseek-r1)、阿里云百炼(https://bailian.console.aliyun.com)、百度智能云千帆(https://console.bce.baidu.com/qianfan),都提供额度不等的免费试用。有体验过的小伙伴欢迎在评论区分享使用感受!
往期推荐: 把AI请回家:本地LLM入门指北