跟着Theis Lab学单细胞: 特征并非“生而平等”
跟着Theis Lab学单细胞: 特征并非“生而平等”
单细胞最佳实践
特征选择
本章导读 SECTION PREVIEW
1. 了解特征选择的必要性以及目标
2. 理解传统方法的局限性和基于偏差的新方法
3. 实战:使用scry包进行特征选择
本节对应原书 8 Feature Selection
在单细胞RNA测序数据分析中,我们通常会面临一个问题:测序得到的基因数量可能高达3万个,但其中很多基因的表达量为零或接近零,对后续分析贡献不大。今天我们来学习如何通过特征选择(Feature Selection)来筛选出真正有生物学意义的基因,提高分析效率。
01
为什么需要特征选择?
在完成了数据标准化之后,我们的数据虽然消除了技术噪音,保留了生物学差异,但仍然面临一个问题:单细胞RNA测序通常能检测到多达30,000个基因,而其中很多基因的表达量要么为零,要么极低,对我们理解细胞状态和类型贡献不大。
就像在茫茫人海中寻找关键人物一样,我们需要从这3万个基因中筛选出真正能反映细胞生物学特征的"明星基因"。这就是特征选择的目的所在。
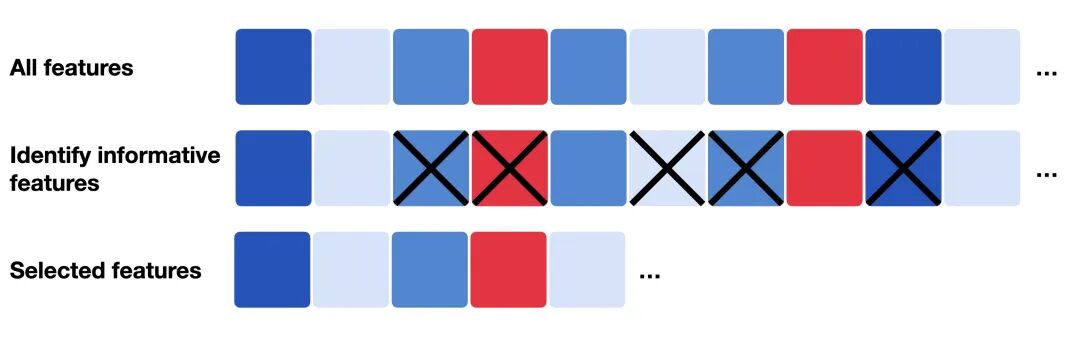
特征选择的本质
特征选择(Feature Selection)的核心目标是从所有基因中筛选出一个子集,这个子集应该:
- • 信息量大: 能够反映细胞间的主要差异
- • 变异性高: 在不同细胞类型或状态间有明显变化
- • 噪音低: 不是由技术因素造成的随机波动
通常情况下,单细胞实验聚焦于特定组织,因此只有一小部分基因具有生物学意义上的表达变异。大多数基因要么在所有细胞中都不表达(管家基因之外的组织特异性基因),要么表达水平恒定(管家基因)。
传统方法的局限
传统的特征选择方法主要有两种思路:
- 1. 高变异基因(Highly Variable Genes, HVG)
- • 计算每个基因的变异系数(coefficient of variation)
- • 选择变异最大的500-2000个基因
- (大家常用的Seurat包,FindVariableFeatures就是这个思路)
- 2. 高表达基因(Highly Expressed Genes)
- • 根据平均表达水平排序
- • 选择表达最高的基因
但这些方法存在一个致命缺陷:还记得上一章我们提到的log1p变换吗?由于不能对零值取对数,我们需要加一个伪计数(通常是1)。这个看似无害的操作实际上会严重影响后续的变异计算。
补课: 伪计数的选择是任意的。选择0.1、1或10会得到完全不同的变异估计,特别是对低表达基因来说。研究表明,小的伪计数值会人为地增加零计数基因的方差。
02
基于偏差(Deviance)的特征选择
偏差方法的原理
Germain等人提出了一种巧妙的解决方案:使用偏差(deviance)进行特征选择 。这种方法的优势在于(术语警告⚠️):
- 1. 直接作用于原始计数: 不需要标准化,避免了伪计数问题
- 2. 有明确的统计学含义: 偏差衡量的是数据与零模型(null model)的拟合程度
- 3. 计算简单: 可以用闭式解(closed-form solution)直接计算
什么是偏差?
简单来说,偏差量化了一个基因是否在所有细胞中都有恒定的表达模式 。如果一个基因在所有细胞中的表达都差不多(符合零模型null model),那么它的偏差值就低;反之,如果一个基因在不同细胞中的表达差异很大(不符合零模型),它的偏差值就高。
高偏差值 = 高信息量 = 值得关注的基因
03
实战:使用scry进行特征选择
首先导入必要的包:
import logging
import anndata2ri
import matplotlib.pyplot as plt
import numpy as np
import rpy2.rinterface_lib.callbacks as rcb
import rpy2.robjects as ro
import scanpy as sc
import seaborn as sns

# 设置环境
sc.settings.verbosity = 0
sc.settings.set_figure_params(
    dpi=80,
    facecolor="white",
    frameon=False,
)

# 配置R接口
rcb.logger.setLevel(logging.ERROR)
ro.pandas2ri.activate()
anndata2ri.activate()

%load_ext rpy2.ipython
本教程适合在jupyter notebook里运行。在R中运行(比如R markdown)可以参考跟着Theis Lab学单细胞: 格式转换,你需要知道底层逻辑(下)实现python部分。
加载R包:
%%R
library(scry)
加载标准化后的数据(也就是上节课跟着Theis Lab学单细胞: “标准化”的数学原理保存的数据。想直接运行的小伙伴也可见文末获取):
# 加载上一章保存的数据
adata = sc.read(
    filename="s4d8_normalization.h5ad",
    backup_url="https://figshare.com/ndownloader/files/40015741",
)

# 将数据传递到R环境
ro.globalenv["adata"] = adata
注意: 偏差方法使用原始计数(存储在adata.X中),不需要任何标准化。
计算偏差并选择特征:
%%R
# 使用scry计算二项偏差
sce = devianceFeatureSelection(adata, assay="X")
将偏差值导出到Python:
# 提取偏差值
binomial_deviance = ro.r("rowData(sce)$binomial_deviance").T
选择偏差值最高的4000个基因:
# 对偏差值排序,选择top 4000
idx = binomial_deviance.argsort()[-4000:]
mask = np.zeros(adata.var_names.shape, dtype=bool)
mask[idx] = True

# 保存结果到adata对象
adata.var["highly_deviant"] = mask
adata.var["binomial_deviance"] = binomial_deviance
为了可视化特征选择的效果,让我们画个基因的平均表达vs离散度散点图:
# 使用scanpy计算每个基因的统计量
sc.pp.highly_variable_genes(adata, layer="scran_normalization")

# 绘制散点图
ax = sns.scatterplot(
    data=adata.var, x="means", y="dispersions", hue="highly_deviant", s=5
)
ax.set_xlim(None, 1.5)
ax.set_ylim(None, 3)
plt.show()
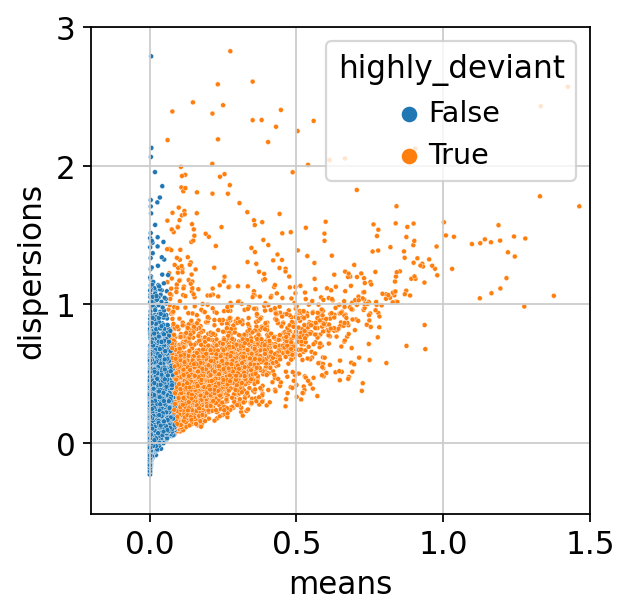 高偏差基因
从图中可以观察到,高平均表达的基因被选为高偏差基因。在实际数据中,高表达基因往往也是生物学上最有意义的基因。
最后保存结果:
adata.write("s4d8_feature_selection.h5ad")
06
后记
使用偏差法时,通常选择2000-5000个高偏差基因较合适。太少可能丢失重要信息,太多则包含过多噪音。当然,不同组织、不同实验条件下,合适的基因数量可能不同。如果后续要做精细的亚群分析,可以适当增加基因数量。也可以在后续评估聚类质量时再修改。
大家觉得使用偏差法和传统方法,哪个效果更好呢?欢迎在评论区交流讨论。本章英文原文及完整代码,可以在后台回复scbp08获取。
----------
单细胞领域大牛编写的最强硬核单细胞教程来啦!想要追更学习笔记,请给我们加个✨,不错过最新推送: