跟着Theis Lab学单细胞: 质控报告应该怎么读?
跟着Theis Lab学单细胞: 质控报告应该怎么读?
Cracking single-cell analysis with Theis Lab
系列编号:No.03 | 发布日期:2025-01-17 | 预计阅读:13分钟
**单细胞最佳实践质控报告解读⭐️本章导读 :**1. 数据质控与预处理2. FastQC报告解读 本节对应原书第三章:Raw Data Processing 3.1
在本节中,我们将探讨通常称为**“预处理”(preprocessing)** 的单细胞与单核RNA测序(sc/snRNA-seq)数据处理的若干基础问题。虽然这一术语已被广泛使用,但严格来说,“预处理”并非恰当的称呼,因为这一过程包含诸多关键步骤,这些步骤将对数据的处理与表示方式做出重要决策,从而决定后续分析的可能性和限制性。出于清晰度的考虑,本节我们将这一过程称为“原始数据处理”(raw data processing)。在这里,我们关注的分析阶段是从已完成测序泳道拆分(lane-demultiplexed)的FASTQ文件开始,一直到得到一个计数矩阵(count matrix)为止 。计数矩阵用于表示每个细胞中每个基因的估计的独立分子数目 ,且可以根据推断的剪接状态(splicing status) 对分子进行分层(见图3.1)。由此得到的计数矩阵是后续各类分析方法的输入起点 。这些分析方法涵盖从数据归一化、整合和过滤,到推断细胞类型、发育轨迹和基因表达动态的方方面面 。因此,一个可靠且精确的计数矩阵估计对于后续分析至关重要。若在原始数据处理阶段出现基本估计偏差,将会导致更高层次分析的错误推断,甚至使得数据中本可能被发现的信号被忽视、削弱或扭曲。虽然从直观上看,我们对原始数据处理的输入(FASTQ文件)和输出(计数矩阵)有明确概念,但在具体实施过程中仍会遇到若干关键且棘手的挑战。当前,为应对这些难题,更加完善的计算方法仍在不断发展。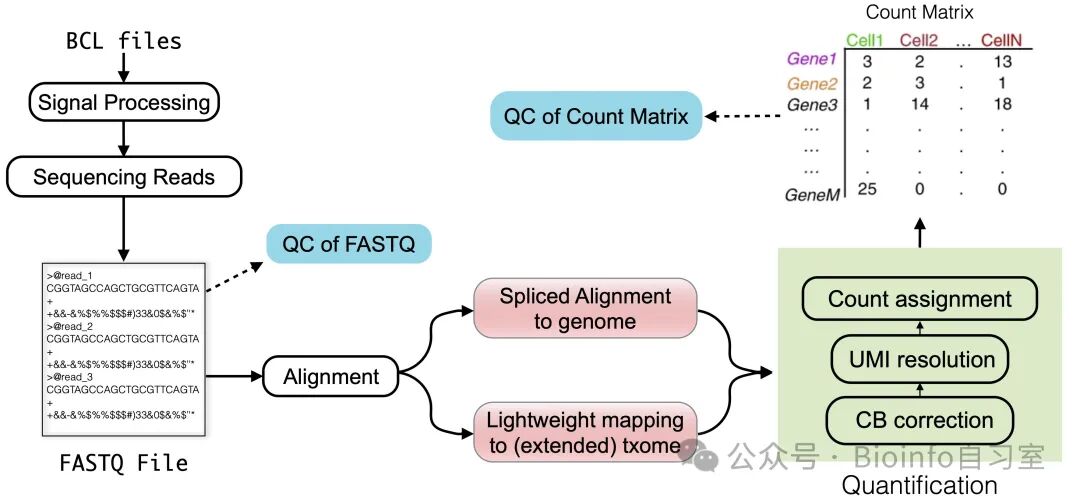
图3.1 本章知识概览。“txome”表示转录组(transcriptome)
预先说明
需要强调的是,我们选择从经过泳道拆分的FASTQ文件作为讨论的起点,这在某种程度上是一个任意划定的界线。在实际工作中,即使FASTQ文件已是相对初步的原始数据,它们本身仍是从更早期的原始信号中经多轮处理与转换而来。例如,在FASTQ文件生成之前的过程(如碱基调用和碱基质量评估)会影响测序片段的最终质量与可信度。此外,在FASTQ生成上游的阶段还可能存在其他问题,例如指数跳跃(index hopping)。不过,这类问题可通过一定的生物信息学手段以及采用双重索引技术得到缓解。在本节中,我们将不深入探讨上述上游影响因素 ,而是将由BCL文件转化而来的FASTQ文件视为处理流程的原始起点,并围绕此起点展开后续讨论。
3. 1 原始数据质控
在获得原始的FASTQ文件后,我们可以通过诸如FastQC 这样的质量控制(QC)工具对读长序列的质量进行快速诊断,以评估读长质量、序列组成等指标。如果运行成功,FastQC 会为每个输入 FASTQ 文件生成一份质量控制报告。总体来说,这份报告会对质量评分、碱基组成及其他相关统计信息 进行汇总,从而帮助我们发现潜在的文库制备或测序问题。尽管如今许多单细胞原始数据处理工具在内部已对部分关键质量指标进行评估(例如序列中的 N 含量和可比对读长的比例),但在开始处理数据之前,仍然有必要快速运行一次独立的质量检测。这是因为这类检测能够提供额外有用的质量控制指标。对于想要了解 RNA-seq 样本的 FASTQ 文件在 FastQC 报告中呈现方式的读者,我们将展示一个示例报告。虽然此报告并非专为单细胞数据设计,但其中大部分结果对于单细胞数据仍然有参考价值,只是需要留意一些注意事项(将在后文阐述)。最后需要说明的是,这些质量控制报告中所提供的大多数指标主要对**“生物学读长”有意义(即来自基因转录本的读长)** 。以 10x Chromium v2 和 v3 数据集为例,这些生物学读长往往对应于文件名中包含 R2 的读长文件 。这是因为技术读长(technical reads)主要由条形码(barcode)和唯一分子标识符(UMI)序列组成,这些序列并非来自转录组本身,因此不应期望呈现典型的生物学特征(如特定的 GC 含量)。不过,像 N 碱基比例这类指标在技术读长中仍然具有参考意义。
FastQC示例报告解读0.总览 Summary
在 HTML 报告的左侧,有一个摘要面板会列出报告中包含的各个模块名称,并附带对应的标志,方便对每部分结果进行快速评估。然而,由于 FastQC 对不同测序平台和生物材料生成的文件采用统一阈值,有时即便是高质量数据也会出现警告(橙色感叹号)或不通过(红色叉号)的情况,而质量存疑的数据却可能通过(绿色对勾)。因此,在对数据质量下结论之前,应该对所有部分/模块进行仔细评估。
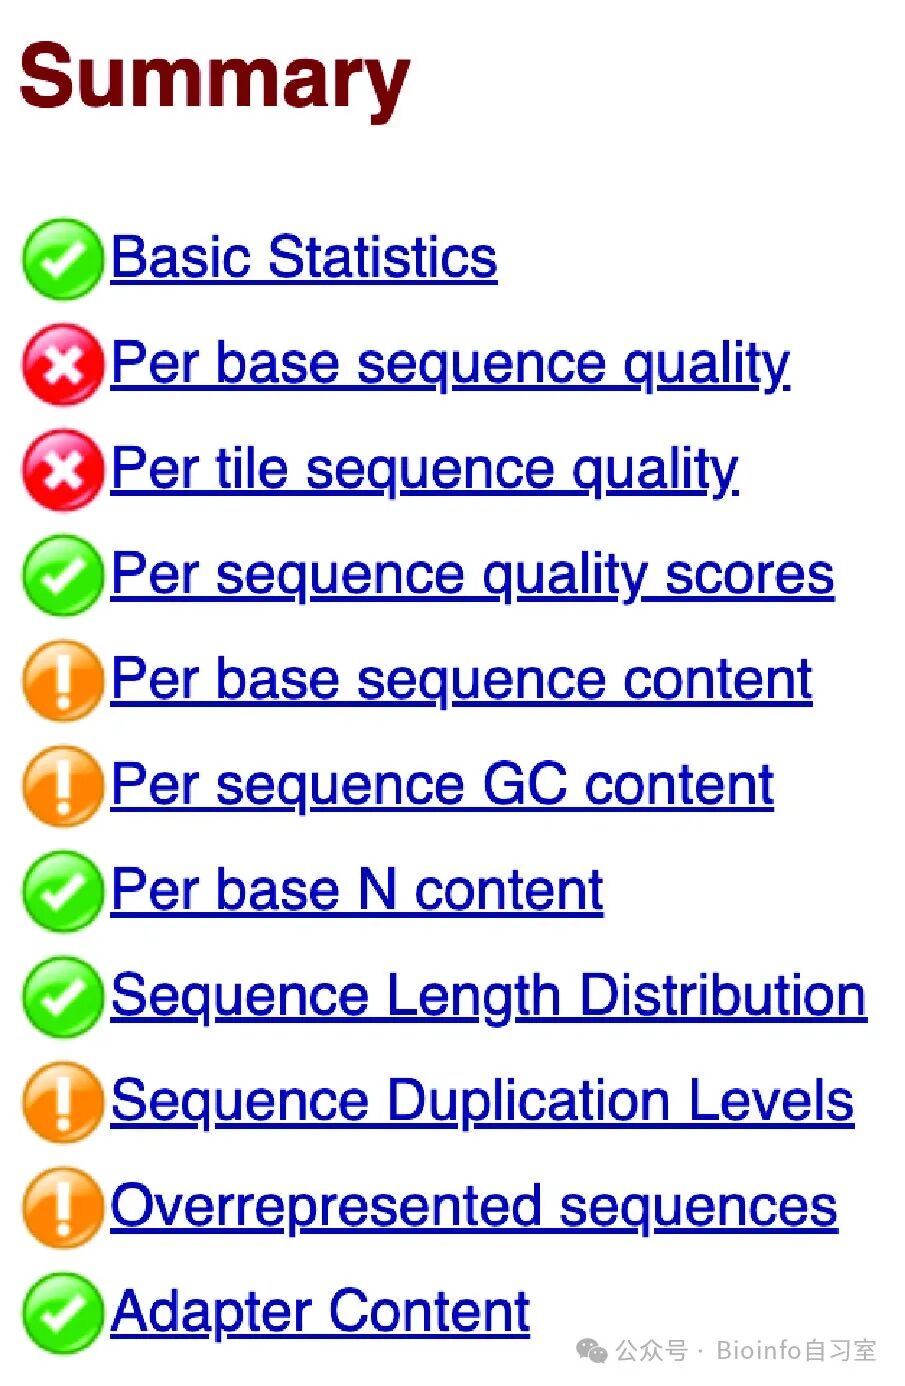
图3.2 一个质量不太好的例子
1.基础数据 Basic Statistics
基础数据模块提供输入 FASTQ 文件中读长的概览信息与统计数据,包括文件名、序列总数、低质量序列数目、序列长度以及所有序列的整体 GC 含量百分比。对于优质的单细胞数据,低质量序列应当非常少,并且大多数读长长度应保持一致 。GC 含量应与测序物种的基因组或转录组的整体 GC 含量相吻合。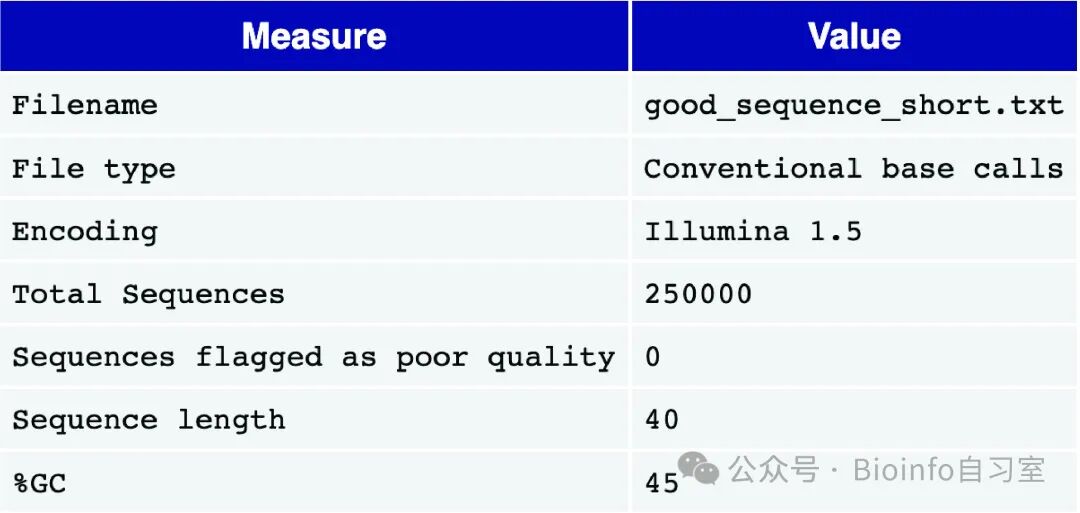
图3.3 一个质量不错的例子,可见第五项“低质量序列”为0。
2.每个位点的质量 Per Base Sequence Quality
在该模块中,我们可以通过箱线图(Box-Whisker 图)查看读长中每个位点的质量分布情况。横轴为读长上的碱基位置,纵轴为质量得分。对于高质量的单细胞数据,每个位置的质量分数的黄盒子(代表该位置质量分数的四分位区间)应全部处于绿色区域(即高质量范围) ,对应分布的须线(10%与90%分位)也应在绿色区域内。通常,随着读长的延伸,质量分数会有所下降,读长末端的一些碱基可能落入橙色区域(中等质量范围),这是许多合成测序方法中常见的信噪比下降现象。但是,这些质量箱线图不应落入红色区域(低质量范围)。如果出现明显的低质量碱基,可以考虑对读长进行质量剪切。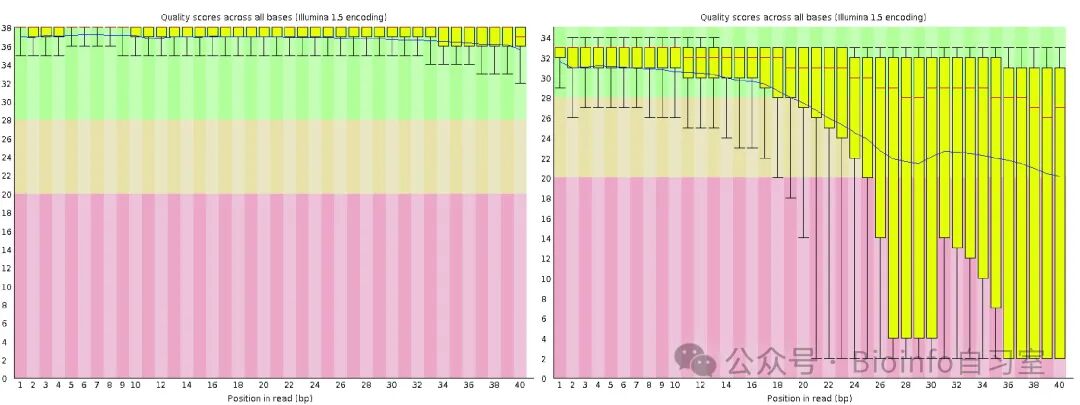
图3.4 测序质量好(左图)和质量不佳(右图)的例子。质量好时,绝大部分位点的质量分数都应该在绿色区域。
3. 测序区块的序列质量 Per Tile Sequence Quality
对于 Illumina 文库,该模块绘制了 Flowcell 中每个测序磁片区块(Tile) 的序列质量与平均质量的偏差图。颜色越“热”,偏差越大 。高质量数据的表现应是整张图呈现蓝色 ,即每个区块的质量相对平均值无显著偏差。如果仅有部分区域显示差异(出现较热的颜色 ),则说明测序过程可能存在短暂问题,例如气泡通过 Flowcell 或通道中存在污点或碎屑。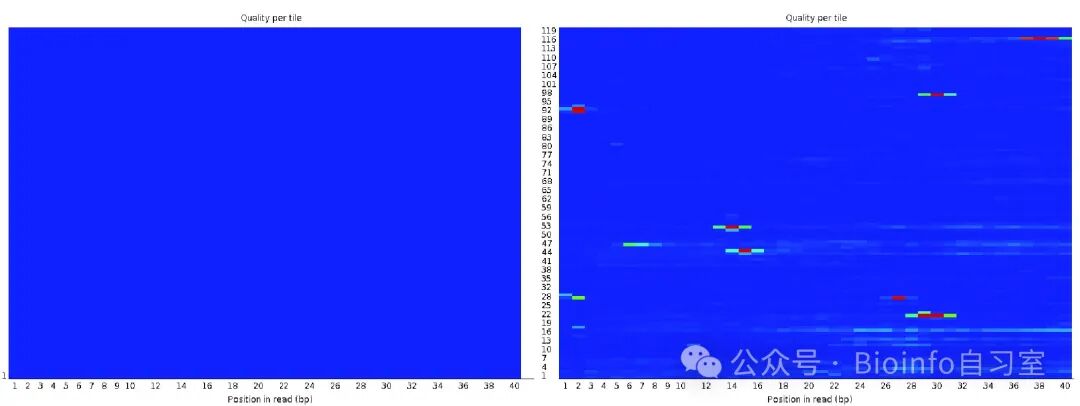
图3.5 测序质量好(左图)和质量不佳(右图)的例子。质量好时,整张热图都应呈现蓝色。
4. 序列的平均得分分布 Per Sequence Quality Scores
这一部分的图表展示了文件中每条读长/序列的平均质量得分分布情况。横轴是平均质量得分 ,纵轴是对应质量得分的序列出现的频率 。对于优质数据,这个图通常只有一个靠高分尾部的峰(即高分序列占据绝大多数) 。如果出现额外的峰值,意味着某些序列可能存在质量问题。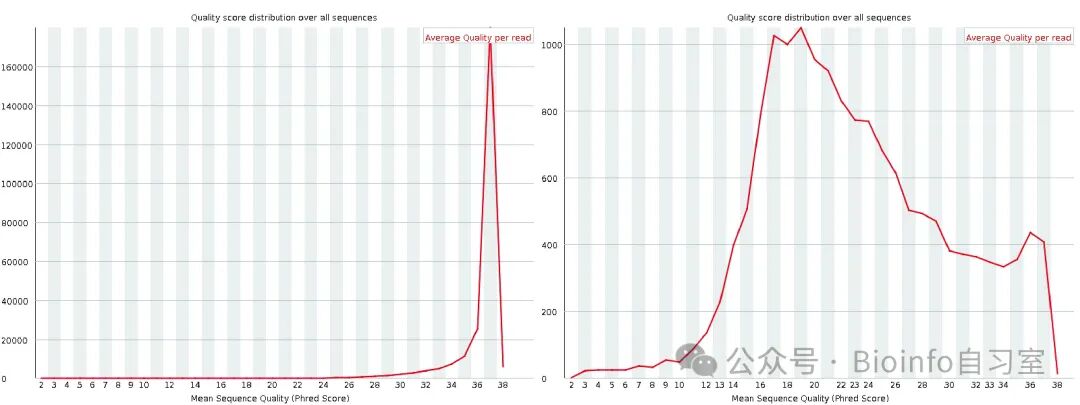
图3.6 测序质量好(左图)和质量不佳(右图)的例子。质量好时,此图应该只在x轴右侧出现一个窄峰。
5. 每个位点的碱基比例 Per Base Sequence Content
这个模块展示文件中所有序列在每个位点上各碱基(A、T、G、C)的比例 。对于单细胞数据(以及bulk RNA测序),在读长开始部分出现波动是常见现象。这是因为读长开头部分往往对应引物结合位点 ,这些位点的序列并非完全随机 ,因此会导致碱基组成偏差。即便如此,FastQC 可能会对这种情况给出警告或错误提示。这在 RNA-seq 文库中很常见,此时的警告和错误提示并不一定真的表示测序有问题。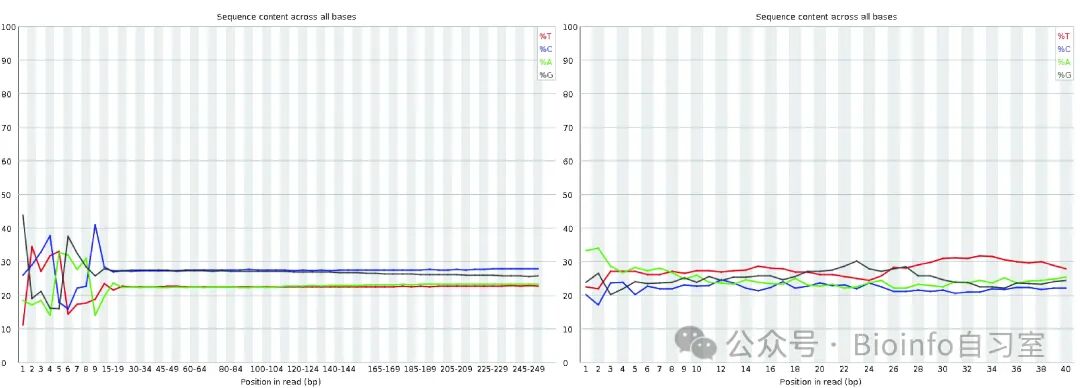
图3.7 测序质量好(左图)和质量不佳(右图)的例子。质量好时,碱基比例应呈直线
6. 序列的GC碱基含量 Per Sequence GC Content
这部分的图表以红色曲线 显示所有读长(reads)的 GC 含量分布,并以蓝色曲线 显示理论(预期)分布。观察到的分布中心峰值应与转录组的整体 GC 含量相对应 。有时,我们看到比理论分布更宽或更窄的峰值范围,这是因为转录组的 GC 含量可能与基因组不同,而理论上蓝色线一般表示与基因组相关的分布。即使分布的差异会触发警告或失败提示,也不一定是转录组真的有问题。但若分布呈现出复杂形态 ,通常提示文库受到了污染。需要注意的是,在转录组学实验中,GC 含量图并不总是容易解释,因为除了转录组本身的序列组成外,样本基因表达水平(未知的)也会影响最终测到的 GC 分布 。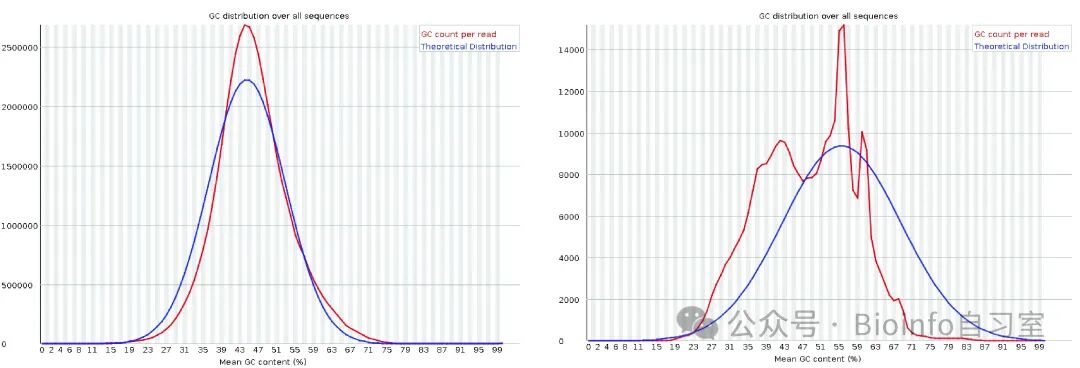
图3.8 测序质量好(左图)和质量不佳(右图)的例子。质量好时,红色和蓝色线的峰应该在同一位置(并不一定需要完全重合)
7. 每个位点的N含量 Per Base N Content
在测序中, “N” 指无法明确判定碱基时,测序仪所赋予的标记 。因为下一代测序的错误率本身很低,对于高质量文库,一般不会在整条读长里看到明显的非零 N 含量。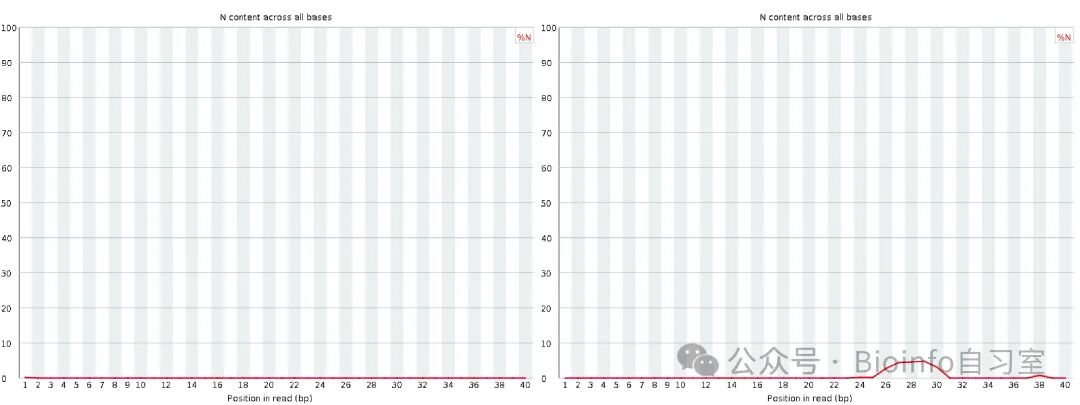
图3.9 测序质量好(左图)和质量不佳(右图)的例子。质量好时,这个图应该是一条0附近的直线,没有凸起的峰。
8. 序列长度分布 Sequence Length Distribution
这个模块展示序列长度的分布。对于大多数单细胞测序试剂体系,所有读长的长度应大致相同 。如果在质量评估前进行了序列剪切(trimming),可能会导致读长长度出现少量差异。⚠️小提示:一般bulk RNA-seq都是2x150bp,也就是双端测序,R1和R2长度应该是一样的。单细胞是单端测序,R1/R2/I1/I2根据版本不同长度也不一样。常见的是R1为8bp,R2为91bp。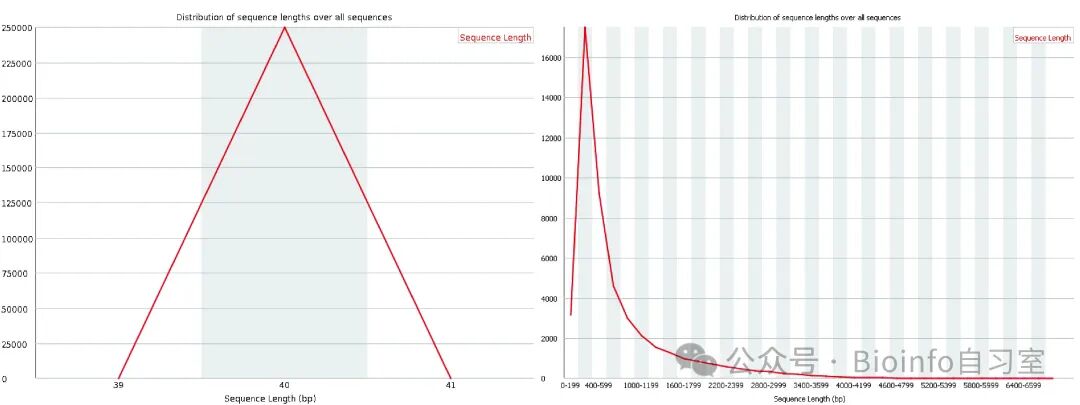
图3.10 测序质量好(左图)和质量不佳(右图)的例子。质量好时,几乎所有序列应该都是同一长度,呈现为一个没有拖尾的单峰。
9. 序列重复水平 Sequence Duplication Levels
这个模块展示读长序列的重复程度分布(蓝色曲线),以及去重复(deduplication)后的分布。由于大部分单细胞平台需多轮 PCR,且高表达基因会产生大量转录本,同时 FastQC 并不“识别”UMI(Unique Molecular Identifier, 用于区分真实分子数),因此常会看到有一小部分序列重复数较高。这可能触发“警告”或“失败”提示,但并不一定代表数据本身存在质量问题。不过,绝大多数序列应保持较低的重复水平。
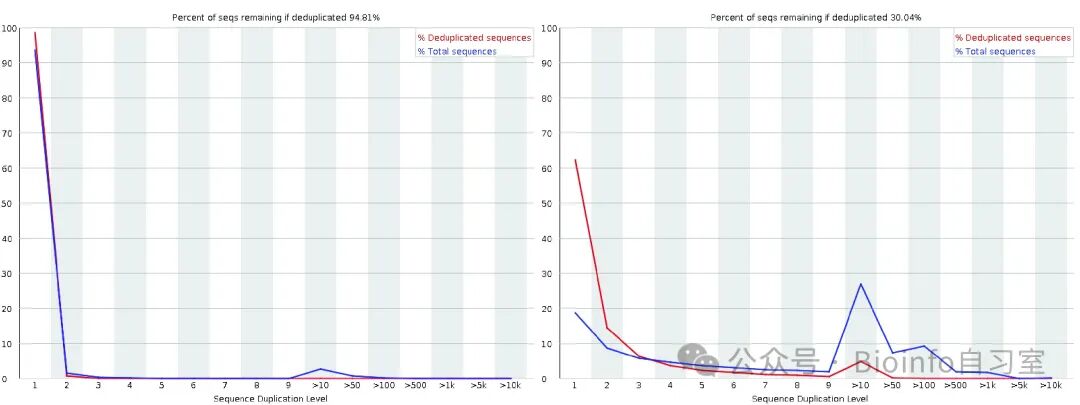 图3.11 质量好(左图)和质量不佳(右图)的例子。质量好时,绝大多数序列应是独一无二的,重复的序列不应超过10%
10. 过度代表序列 Overrepresented Sequences
该模块列出了占全部序列数量 0.1% 以上的读长序列 。经过多轮 PCR 扩增后,高表达基因可能产生一定比例的过度代表序列,但整体而言,大多数序列不应出现过度代表现象。如果显示的过度代表序列并非“未命中”(No Hit)(即,“未命中”的情况一般不需要特别担心) ,可能说明文库受到了相应来源的污染。
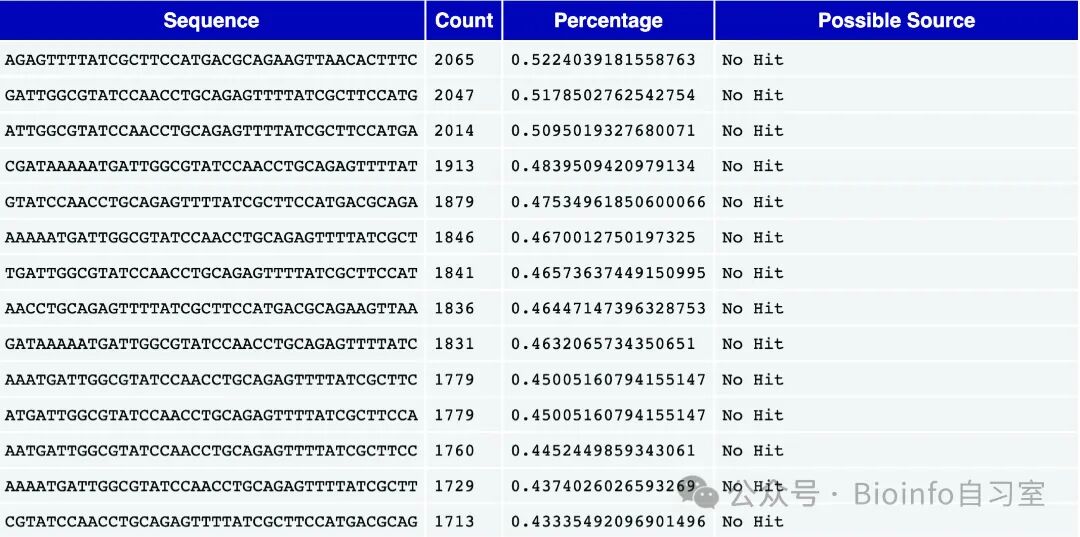 图3.12 过度代表序列的例子。如果有污染,第四栏“Possible Source”会显示推测的来源
11. 接头序列含量 Adapter Content
该模块汇总了各接头(adapter)序列在读长中出现的累积比例,分按碱基位置显示。理想情况下,不应在数据中看到大量的接头序列残留。
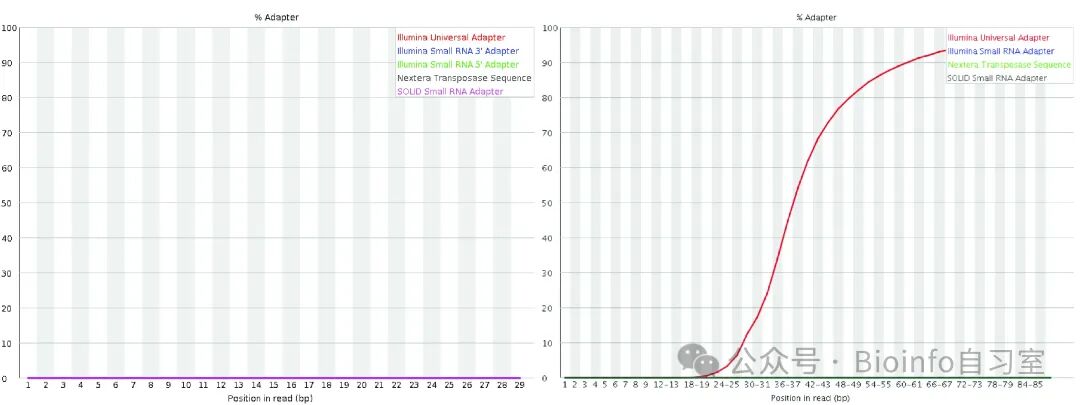 图3.13 质量好(左图)和质量不佳(右图)的例子。质量好时,接头序列的含量应该非常少(0附近)
如果有多个FastQC的报告文件,我们可以使用MultiQC合并。具体的命令也很简单(当然,需要提前安装好multiQC):
cd fastqc # 假设报告存放在叫fastqc的文件夹内multiqc .
后记
本篇对应原书的第三章。这一章干货非常多也非常长,非常细致地介绍了测序文件质控的原理和流程。这一篇主要带大家梳理了FastQC报告的详细解读,预计剩余部分还会分成4-5篇推文。等整理完成再给大家更新暗号和资料。感谢关注~
下篇预告:序列比对和映射 。敬请期待!
往期推荐
跟着Theis Lab学单细胞02: 单细胞测序概述上游笔记1:Let's 下载数据!上游笔记2: cellranger count也没那么难
点赞分享在看留言