跟着Theis Lab学单细胞: “标准化”的数学原理
跟着Theis Lab学单细胞: “标准化”的数学原理
单细胞最佳实践
数据标准化
本章导读 SECTION PREVIEW
1. 了解标准化的重要性和用途
2. 了解标准化的理论基础,如UMI遵循Gamma-Poisson分布
3. 实战:在scanpy中运行数据标准化
本节对应原书 7 Normalization
⚠️干货预警:本章将讨论标准化的数学理论基础,不感兴趣的朋友可以跳过此部分。
在单细胞RNA测序(scRNA-seq)实验中,我们的最终目标是准确测量每个细胞中每个基因的表达水平。然而,从生物样本到最终的基因表达计数矩阵,需要经历多个复杂的实验步骤,每一步都会引入技术变异性:
- 细胞捕获效率的差异
不同细胞被捕获的效率不同,导致起始RNA量存在差异。即使是相同类型的细胞,捕获到的mRNA分子数量也可能相差几倍。 - 逆转录效率的变异
RNA逆转录为cDNA的过程受到多种因素影响,包括RNA的长度、二级结构、逆转录酶的效率等,这些都会造成不同基因和不同细胞间的逆转录效率差异。 - PCR扩增偏好性
在PCR扩增步骤中,不同序列的扩增效率不同,一些GC含量高或存在特殊结构的序列可能扩增效率较低,导致最终计数不能真实反映原始mRNA丰度。 - 测序深度的不均一性
即使在同一次测序运行中,不同细胞获得的测序reads数量也可能差别很大,这直接影响了基因检测的灵敏度。
这些技术因素的存在意味着,原始计数矩阵中观察到的基因表达差异,可能并不完全反映真实的生物学差异 。两个相同的细胞可能由于技术因素而表现出不同的基因表达谱,而两个不同的细胞可能由于测序深度的巨大差异而被误认为相似。
标准化就是要解决这个问题:在尽可能保留真实生物学信号的同时,去除或减少技术变异性的影响 。这是后续所有分析步骤的基础,包括降维、聚类、差异表达分析等。
在上一章中,我们已经完成了去噪,包括去除低质量细胞、环境RNA污染以及双细胞。接下来我们将对数据继续进行标准化。在进入实战前,让我们先了解一下其数学原理。
01
理论基础
🔬 Gamma-Poisson分布
UMI数据(Unique Molecular Identifier)在理论和实践中都服从Gamma-Poisson分布(也就是负二项分布),这意味着均值-方差关系为:。其中 是均值, 是过度离散参数。
补课:
- 1. Gamma-Poisson分布是Poisson分布的泛化。泊松分布是一种离散分布模型,用于模拟在固定的时间间隔、空间区域、或其他度量单位内,独立随机事件发生次数的概率分布。
- 2. 过度离散(overdispersion)指的是数据的方差超出了泊松分布的假设。当 时,就退化为泊松分布; 时,表示存在额外的变异性。
- 3. 在单细胞测序中,UMI的捕获、逆转录和测序可以近似看为独立随机事件,且在给定实验条件下,每个mRNA分子被检测到的概率大致相等。并且相对于细胞中总的分子数量,被成功检测到的分子数量较少,符合泊松过程的稀有事件假设。
📊 技术变异vs生物变异
在scRNA-seq数据中,我们观察到的总变异可以分解为:
总变异 = 生物变异 + 技术变异生物变异: 细胞类型差异、细胞状态变化、基因调控网络的真实差异
技术变异: 测序深度差异、捕获效率差异、扩增偏好性、batch效应等
标准化的挑战在于:如何最大程度地去除技术变异,同时保留生物变异。这需要我们对数据的统计性质有深入理解。
🎯 为什么传统方法不够用?
在bulk RNA-seq中,由于样本中包含大量细胞,技术变异通过平均效应被部分抵消。但在单细胞水平上:
零膨胀严重: 大量基因在单个细胞中不表达,导致计数矩阵中大量零值
方差-均值关系复杂: 低表达基因主要受泊松噪音支配,高表达基因则表现出过度离散
细胞间差异巨大: 不同细胞的总mRNA含量可能相差数个数量级
这些特点使得传统的标准化方法(如RPKM、TPM)在单细胞数据上表现不佳,需要专门设计的标准化策略。
🎨 标准化的艺术
标准化的目标是调整原始计数中的可变采样效应,将可观察的方差缩放到指定范围内。不同的标准化技术复杂程度不同,但都是为了让后续的统计分析方法能够正常工作。
02
标准化的数学策略
💻 准备工作:导入必要的包
import scanpy as sc
import numpy as np
import seaborn as sns
from matplotlib import pyplot as plt
import anndata2ri
import logging
from scipy.sparse import issparse
import rpy2.rinterface_lib.callbacks as rcb
import rpy2.robjects as ro

# 设置scanpy参数
sc.settings.verbosity = 0
sc.settings.set_figure_params(
    dpi=80,
    facecolor="white",
    frameon=False,
)

# 设置R接口
rcb.logger.setLevel(logging.ERROR)
ro.pandas2ri.activate()
anndata2ri.activate()
%load_ext rpy2.ipython

# 加载数据
adata = sc.read(
    filename="s4d8_quality_control.h5ad",
    backup_url="https://figshare.com/ndownloader/files/40014331",
)
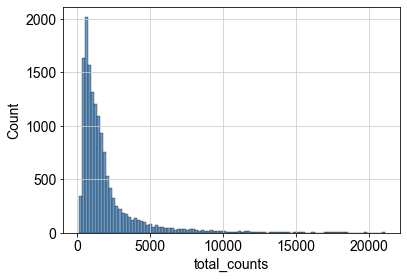
让我们先看看原始计数的分布:
p1 = sns.histplot(adata.obs["total_counts"], bins=100, kde=False)
 来源:scbp
偏移对数变换(Shifted Logarithm)法
偏移对数变换听起来很高大上,其实简单来讲就是两件事:
第一步:标准化计数
标准化计数原始计数尺寸因子
第二步:对数变换
最终结果标准化计数
补课:这里的"+1"叫做伪计数,是为了避免取对数时遇到0值(log(0)是未定义的)。
尺寸因子可以理解为每个细胞的"测序深度校正系数"。计算方法是:
尺寸因子该细胞的总计数目标总数
如果一个细胞测序很深(总计数很高),它的尺寸因子就大,标准化后计数会被"缩小";反之,如果一个细胞测序较浅(总计数较低),它的尺寸因子就小,标准化后计数会被"放大"。这样,所有细胞就在同一个水平上进行比较了。
关键输出指标:
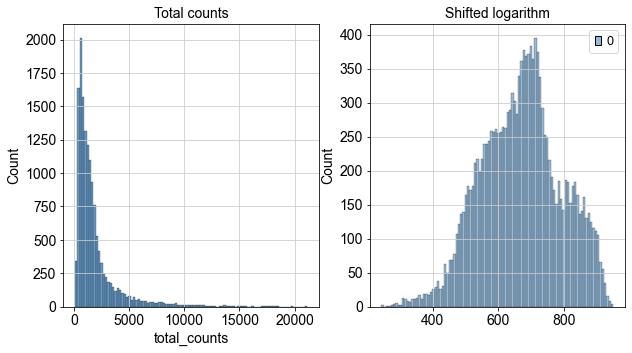
# 进行总计数标准化(不设置目标总和,使用默认值)
scales_counts = sc.pp.normalize_total(adata, target_sum=None, inplace=False)

# 应用log1p变换
adata.layers["log1p_norm"] = sc.pp.log1p(scales_counts["X"], copy=True)

# 可视化结果
fig, axes = plt.subplots(1, 2, figsize=(10, 5))

p1 = sns.histplot(adata.obs["total_counts"], bins=100, kde=False, ax=axes[0])
axes[0].set_title("Total counts")

p2 = sns.histplot(adata.layers["log1p_norm"].sum(1), bins=100, kde=False, ax=axes[1])
axes[1].set_title("Shifted logarithm")

plt.show()
 来源:scbp
偏移对数变换具有以下优点:
- • 快速:计算效率高
- • 有效:在发现数据潜在结构方面表现优异(特别是与PCA结合时)
- • 稳定:有利于后续的降维和差异表达基因识别
scran标准化
Scran方法和偏移对数的基本思路类似,但在估计尺寸因子的方法上更加精细。
为什么需要改进?
偏移对数方法简单地用每个细胞的总计数来计算尺寸因子,但这有几个问题:如果某个细胞有几个基因异常高表达,会拉高总计数。这会导致其他正常表达的基因被"过度校正"。
Scran采用“池化策略(pooling)”解决这个问题。具体来说:
- 1. 分组:先把相似的细胞放在一起形成"池子"
- 2. 池子分析:分析每个池子的整体表达模式
- 3. 反推个体:从池子的信息推算出每个细胞的真实尺寸因子
这样做的好处是:
1. 减少个别异常基因的影响2. 利用相似细胞的信息提高估计精度3. 对稀疏数据更加稳健代码实现如下:
from scipy.sparse import csr_matrix, issparse

# 为Scran准备粗聚类输入
adata_pp = adata.copy()
sc.pp.normalize_total(adata_pp)
sc.pp.log1p(adata_pp)
sc.pp.pca(adata_pp, n_comps=15)
sc.pp.neighbors(adata_pp)
sc.tl.leiden(adata_pp, key_added="groups")

# 准备R环境的数据
data_mat = adata_pp.X.T

# 转换为适当的稀疏矩阵格式
if issparse(data_mat):
    if data_mat.nnz > 2**31 - 1:
        data_mat = data_mat.tocoo()
    else:
        data_mat = data_mat.tocsc()

ro.globalenv["data_mat"] = data_mat
ro.globalenv["input_groups"] = adata_pp.obs["groups"]

%%R
library(scran)
library(BiocParallel)

# 删除临时对象
del adata_pp

%%R -o size_factors
size_factors = sizeFactors(
    computeSumFactors(
        SingleCellExperiment(
            list(counts=data_mat)),
        clusters = input_groups,
        min.mean = 0.1,
        BPPARAM = MulticoreParam()
    )
)

# 保存尺寸因子并进行标准化
adata.obs["size_factors"] = size_factors
scran = adata.X / adata.obs["size_factors"].values[:, None]
adata.layers["scran_normalization"] = csr_matrix(sc.pp.log1p(scran))

# 可视化结果
fig, axes = plt.subplots(1, 2, figsize=(10, 5))

p1 = sns.histplot(adata.obs["total_counts"], bins=100, kde=False, ax=axes[0])
axes[0].set_title("Total counts")

p2 = sns.histplot(
    adata.layers["scran_normalization"].sum(1), bins=100, kde=False, ax=axes[1]
)
axes[1].set_title("log1p with Scran estimated size factors")

plt.show()
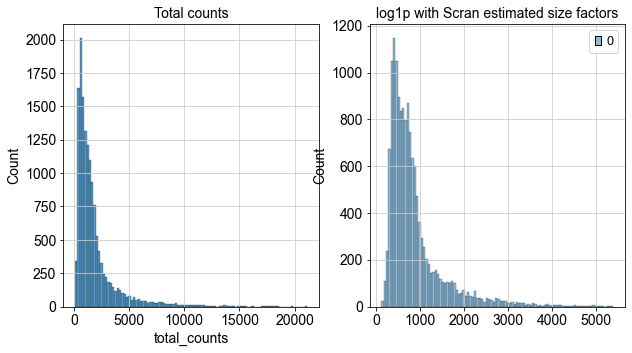
scran标准化适用于需要处理批次效应、或是需要精确估计尺寸因子的场景。
解析皮尔逊残差法(Pearson Residuals)
皮尔逊残差方法的思路和前两种方法有所不同。它不是直接调整计数值,而是计算皮尔逊残差。简单来说:根据基因的平均表达水平和细胞的测序深度,我们可以预测某个基因在某个细胞中"应该"有多少计数,而皮尔逊残差就是实际计数与预期计数的标准化差异 。正值代表这个基因在这个细胞中的表达比预期高,负值代表这个基因在这个细胞中的表达比预期低,接近0则表示表达水平符合预期。
与前两种方法相比,皮尔逊残差有几个特点:
- 1. 不需要取对数: 结果可以直接使用,避免了对数变换的一些问题
- 2. 保留完整信息: 负值也有意义,提供了更丰富的信息
- 3. 直接建模技术效应: 明确地将测序深度作为需要去除的技术因素
皮尔逊残差法适用于寻找在特定细胞类型中异常高表达或低表达的基因、识别稀有细胞类型(基因表达模式特殊)或需要保持数据完整性的分析。
代码实现如下:
# 计算解析皮尔逊残差
analytic_pearson = sc.experimental.pp.normalize_pearson_residuals(adata, inplace=False)
adata.layers["analytic_pearson_residuals"] = csr_matrix(analytic_pearson["X"])

# 可视化结果
fig, axes = plt.subplots(1, 2, figsize=(10, 5))

p1 = sns.histplot(adata.obs["total_counts"], bins=100, kde=False, ax=axes[0])
axes[0].set_title("Total counts")

p2 = sns.histplot(
    adata.layers["analytic_pearson_residuals"].sum(1), bins=100, kde=False, ax=axes[1]
)
axes[1].set_title("Analytic Pearson residuals")

plt.show()
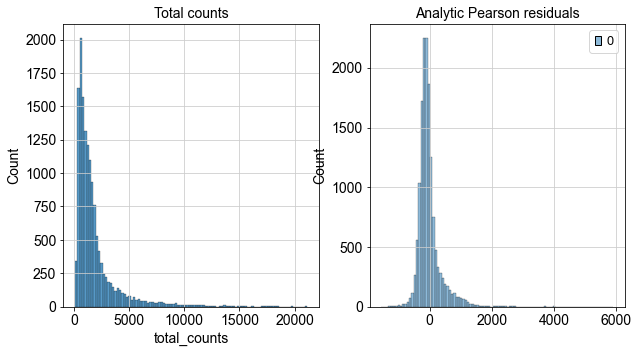
保存结果
# 保存包含所有标准化结果的数据
adata.write("s4d8_normalization.h5ad")
现在我们的adata对象包含了三个标准化层:
- • log1p_norm:偏移对数变换
- • scran_normalization:Scran标准化
- • analytic_pearson_residuals:解析皮尔逊残差
03
小结
🤔 选择指南
根据Ahlmann-Eltze和Huber的基准测试研究,不同标准化方法在不同任务中表现各异:
| 标准化方法 | 最佳应用场景 | 优势 |
|---|---|---|
| 偏移对数变换 | 降维、差异表达基因识别 | 快速、稳定方差 |
| Scran标准化 | 批次效应校正 | 精确尺寸因子估计 |
| 解析皮尔逊残差 | 生物学可变基因选择、稀有细胞类型识别 | 保持异质性、无需额外变换 |
📈 方差稳定化的本质
所有标准化方法的核心目标都是方差稳定化 。在原始计数数据中,方差通常与均值相关:
- • 低表达基因 :主要受泊松噪音影响
- • 高表达基因 :方差随均值二次增长
标准化通过不同的数学变换,试图让所有基因的方差结构更加统一。
🎲 从统计学角度理解不同方法
- 1. 偏移对数 :基于delta方法,通过非线性变换实现方差稳定化
- 2. Scran :基于反卷积的稳健估计方法,通过池化策略减少极值细胞的影响
- 3. 皮尔逊残差 :采用回归分析的框架,显式建模技术变异与生物变异
小编注 :这三种方法代表了不同的统计学思路。偏移对数注重简单有效的变换,Scran强调稳健的参数估计,皮尔逊残差则更注重模型的可解释性。
05
后记
标准化也是单细胞数据分析中的重要环节,原来这里面还有这么多门道!然而,说句老生常谈的“废话”,没有“最佳”的标准化方法,也并不一定是最复杂的就是最好的,绝大多数时候,最简单的log1p已经足够我们做出生物学发现。并且,单细胞作为超级活跃的领域,新的方法也层出不穷。但小编觉得这期内容仍然很有意义。我们需要知道,我们正在使用理想化的假设和简化的数学模型模拟细胞的基因表达,因此对于生信结果需要take it with a grain of salt,实验验证是不可或缺的。
本章英文原文及完整代码,可以在后台回复scbp07获取。
----------
单细胞领域大牛编写的最强硬核单细胞教程来啦!想要追更学习笔记,请给我们加一个小✨,这样最新的推送才会显示在主页: