跟着Theis Lab学单细胞: scanpy+muon,你的细胞百宝箱
跟着Theis Lab学单细胞: scanpy+muon,你的细胞百宝箱
单细胞最佳实践
MuData操作指南
本章导读 SECTION PREVIEW
1. 了解scanpy和muon的API设计与功能模块
2. 掌握scanpy进行单模态数据分析的基本流程
3. 学习muon处理多模态数据的常用方法和工具
本节对应原书 4.3 Unimodal data analysis with scanpy,4.5 Advanced: Multimodal data analysis with muon
01
Scanpy
在前面的章节中,我们学习了两种数据格式:AnnData(用于单一类型的数据)和MuData(用于多种类型的数据)。现在,我们要学习如何实际分析这些数据。在scverse这个工具生态系统中,有不同的软件包专门处理各种类型的单细胞数据。比如:
- • scanpy:主要用于RNA基因表达数据分析
- • squidpy:专门用于空间转录组学(带有位置信息的基因表达)
- • scirpy:主要用于免疫细胞受体数据(T细胞和B细胞的特殊标记)
虽然这些工具各有各的用途,但它们借鉴了scanpy的一些基础功能,尤其是数据预处理和结果可视化部分。
scanpy是一个Python工具包,它以AnnData为基础,帮助我们分析单细胞基因表达数据。它提供了从原始数据清洗到高级分析的全套工具,包括降维、数据可视化、细胞聚类、找出差异基因、细胞发育轨迹推断等功能。由于scanpy基于高效的Python数据科学库开发,它可以轻松处理包含数百万个细胞的大型数据集。
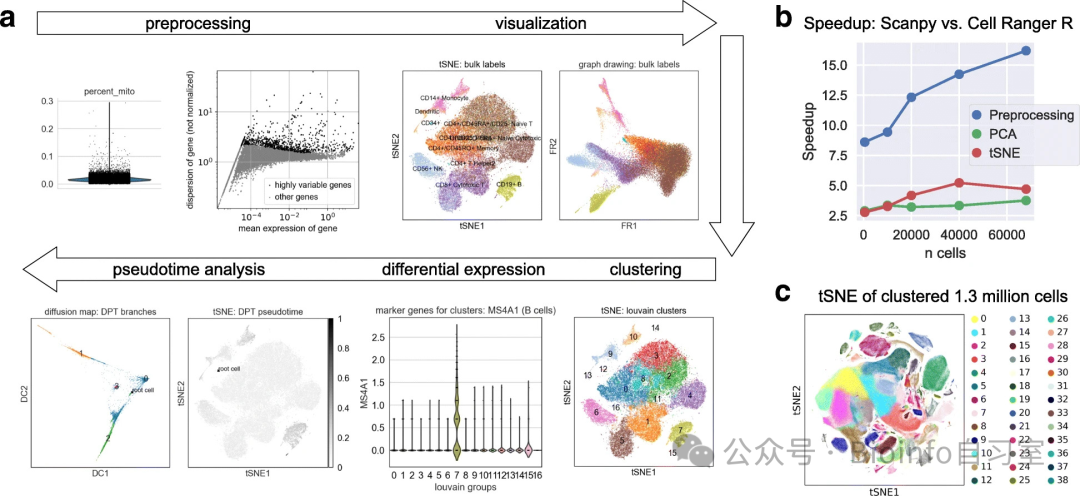 scanpy概览(图片来源:Wolf et al., 2018)
安装scanpy
二选一
pip install scanpy
# 或者
conda install -c conda-forge scanpy
scanpy的API设计
scanpy把相关功能归类到不同的模块中,就像一个工具箱,不同抽屉放不同类型的工具。主要模块包括:
工具箱中的"抽屉":
- •
sc.pp:预处理模块(pp代表preprocessing)- 用于数据清洗、标准化等 - •
sc.tl:分析工具模块(tl代表tools)- 用于降维、聚类等高级分析 - •
sc.pl:绘图模块(pl代表plotting)- 用于各种图表可视化
除了这三个主要模块外,读写数据的功能可以直接通过sc调用。scanpy还提供了一个数据集模块sc.datasets,包含了一些用于学习和测试的样本数据。
这种模块化设计让我们能够清晰地组织分析流程:先进行数据预处理,然后应用分析工具,最后通过图形展示结果。
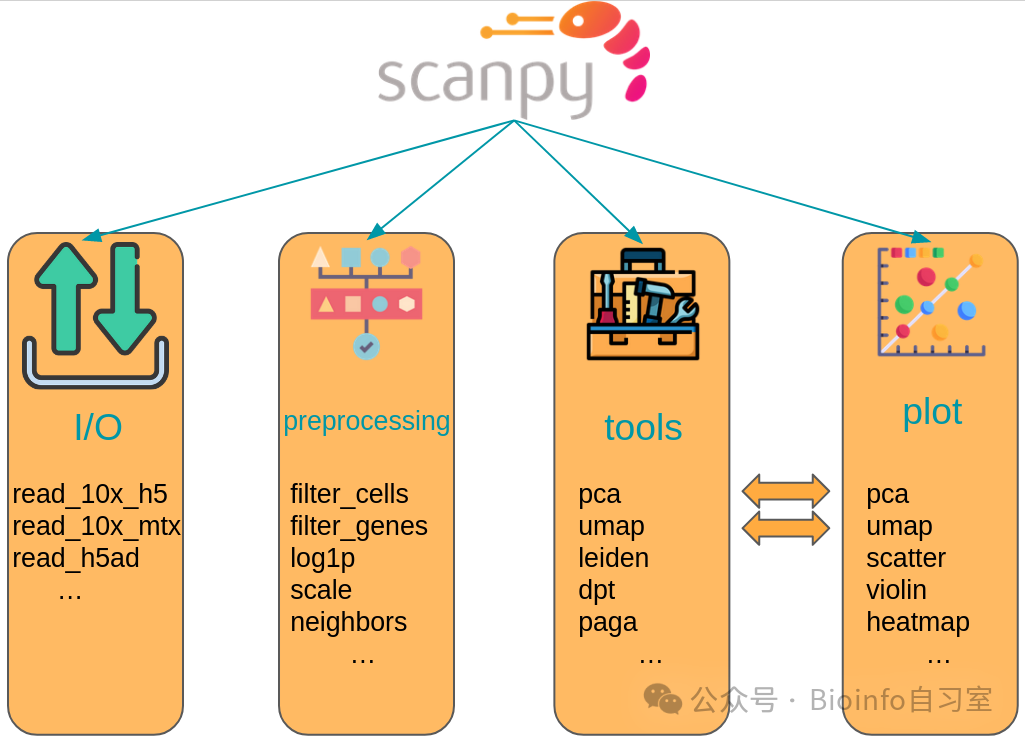 scanpy API概览
⚠️本教程只涵盖了scanpy功能的一小部分。建议读者查阅scanpy的官方文档以获取更详细的信息。
scanpy分析示例
下面我们将通过一个简单例子,演示scanpy的基本使用流程。这不是完整的分析,只是让大家对工具的使用有个直观了解。
我们使用老朋友pbmc3k:来自健康捐赠者的2700个外周血单核细胞(PBMC)样本。PBMC是从血液中分离出来的一组免疫细胞,常用于免疫学和药物研究。
首先,我们需要设置一些基本参数:
# 导入scanpy,一般缩写为sc
import scanpy as sc

# 设置图形参数(分辨率、背景颜色等)
sc.settings.set_figure_params(dpi=80, facecolor="white")

# 打印环境信息(对排查问题很有用)
sc.logging.print_header()
输出:
scanpy==1.9.1 anndata==0.7.8 umap==0.5.2 numpy==1.20.3 scipy==1.7.2 pandas==1.4.3 scikit-learn==1.0.1 statsmodels==0.13.1 python-igraph==0.9.10 pynndescent==0.5.5
这个"header"会显示当前环境中所有相关软件包的版本。版本信息对于研究结果的可重复性以及排查问题都非常重要。
接下来,我们使用scanpy获取3k PBMC数据集作为AnnData对象。数据集会自动下载并保存到指定路径,默认为data文件夹。
adata = sc.datasets.pbmc3k()
adata
输出:
AnnData object with n_obs × n_vars = 2700 × 32738
    var: 'gene_ids'
返回的AnnData对象包含2700个细胞和32738个基因。var槽位还包含基因ID的信息。
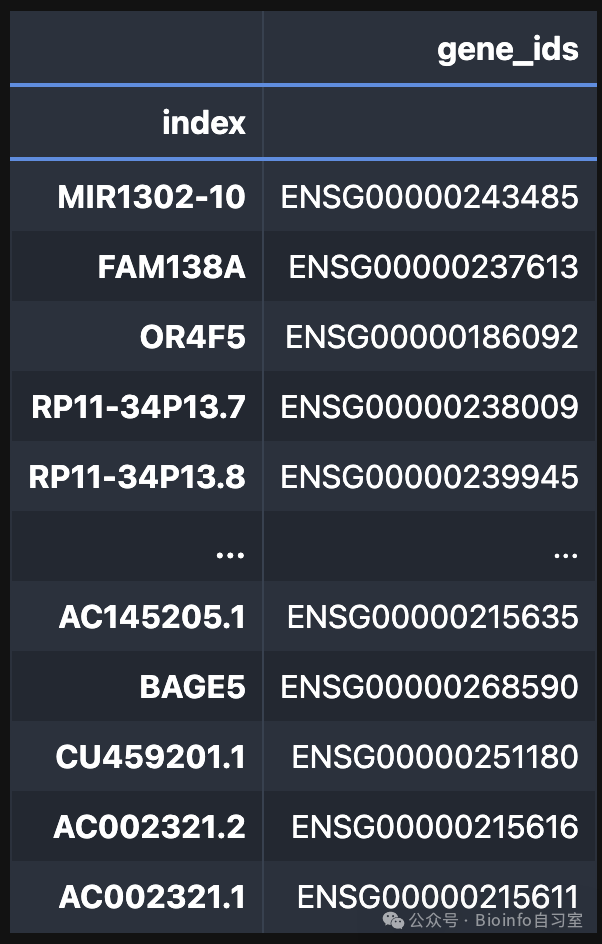 adata.var输出结果
查看每个细胞中计数比例最高的基因,可以调用sc.pl.highest_expr_genes函数,传入AnnData对象(adata几乎是所有scanpy函数的第一个参数),并指定我们想要显示表达量最高的前20个基因。
sc.pl.highest_expr_genes(adata, n_top=20)
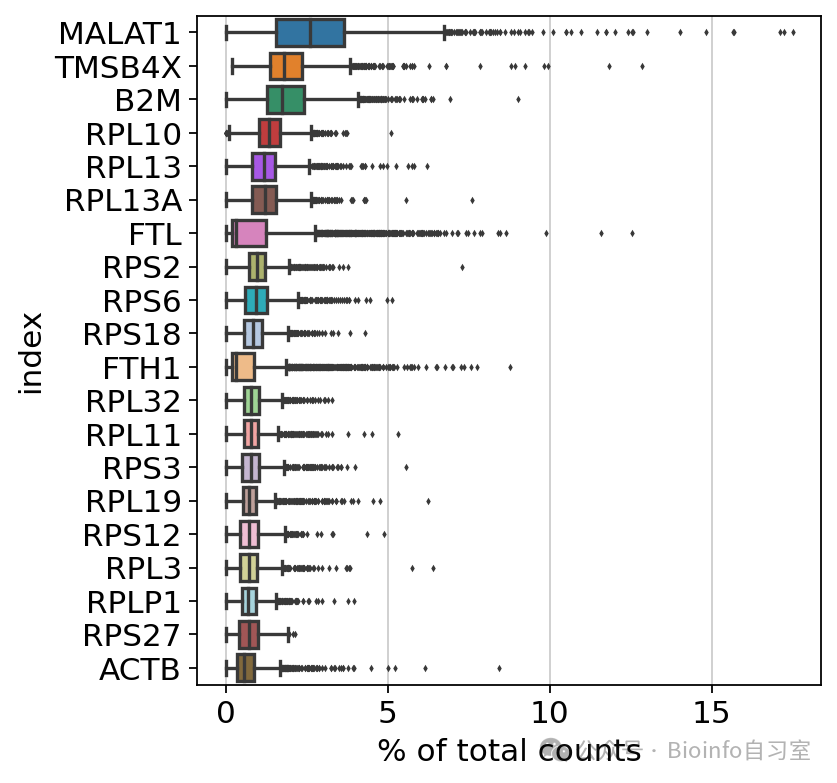 top20 genes
从结果中我们可能会发现MALAT1是表达量最高的基因之一。这种现象在单细胞RNA测序中很常见,与具体的测序方法关系不大。有趣的是,MALAT1基因的表达量通常与细胞健康状况呈负相关,也就是说,表达越高可能意味着细胞状态越差。
接下来进行基本的质量控制,去除那些可能是空液滴或者质量较差的细胞:
# 过滤检测到基因数量太少的细胞(可能是空液滴或细胞碎片)
sc.pp.filter_cells(adata, min_genes=200)

# 过滤在太少细胞中检测到的基因(可能是测序错误或非特异性表达)
sc.pp.filter_genes(adata, min_cells=3)
这两个过滤步骤就像是在显微镜下挑选样本,去除那些看起来不太好的细胞和不太可靠的基因测量值。
⚠️最少200个基因不是金标准,应该根据实际研究的样本选择,在之后的章节中会详述。
单细胞数据通常包含数万个基因,直接分析这么多维度的数据是很困难的。因此,我们需要进行降维,就像把一个复杂的立体结构压缩成一个平面图一样,保留主要特征同时去除噪声。主成分分析(PCA)是常用的第一步降维方法:
# 执行PCA降维
sc.tl.pca(adata, svd_solver="arpack")

# 可视化PCA结果,并按CST3基因表达量着色
sc.pl.pca(adata, color="CST3")
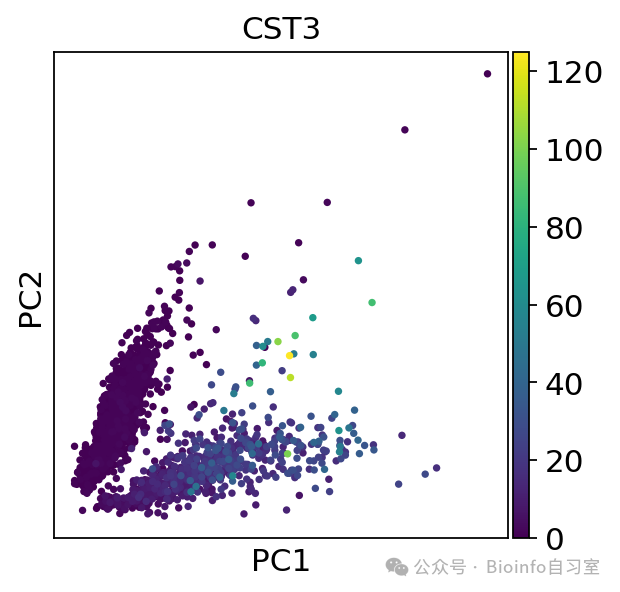 PCA可视化
PCA结果还不够直观,我们需要更进一步。首先建立细胞间的"邻近关系",确定哪些细胞彼此相似:
# 计算细胞间的邻近关系
sc.pp.neighbors(adata, n_neighbors=10, n_pcs=40)
有了这个邻近网络,我们可以使用更高级的降维方法UMAP,生成一个更直观的二维图:
# 计算UMAP嵌入(将高维数据映射到2D平面)
sc.tl.umap(adata)

# 可视化结果,用三个不同基因的表达量给细胞上色
# 相当于Seurat里的FeaturePlot
sc.pl.umap(adata, color=["CST3", "NKG7", "PPBP"])
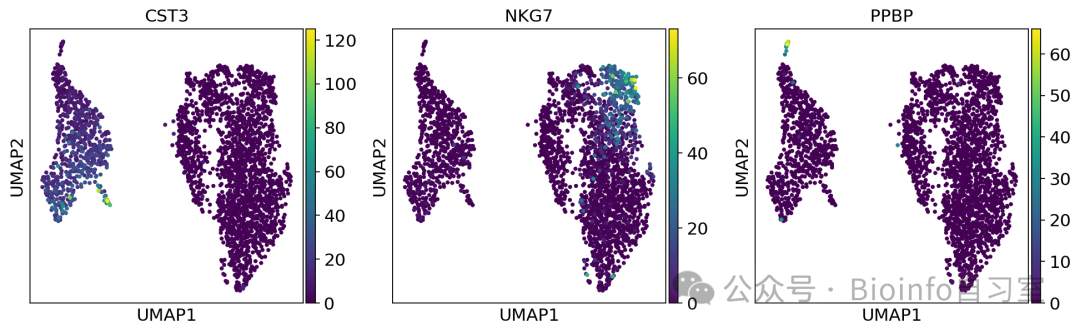 UMAP可视化
UMAP图中,相似的细胞会聚集在一起形成"岛屿"或"群落",不同颜色代表不同基因的表达水平。这些"岛屿"通常代表不同的细胞类型,比如T细胞、B细胞或单核细胞等。
scanpy的文档也提供了教程,我们建议所有需要复习scanpy或刚接触scanpy的读者参考。视频教程可在scverse YouTube频道上获取。
02
Muon
虽然scanpy很强大,但它主要为RNA-seq数据设计。那么如何处理这些"多角度"的数据呢?这就是muon工具的用武之地。
muon扩展了scanpy的功能,专门用于分析:
- • ATAC-seq数据(测量染色质开放状态,告诉我们哪些DNA区域可能处于活跃状态)
- • CITE-seq数据(同时测量细胞表面蛋白质和RNA)
- • 多模态数据的整合分析(将不同类型的数据结合起来获得更全面的细胞特征)
muon不仅可以分别处理各种数据类型,还提供了特殊的算法,能够从多种数据类型的组合中提取更深层次的生物学信息。这就像通过比较照片、红外图和X光片,得到普通观察无法发现的洞见。
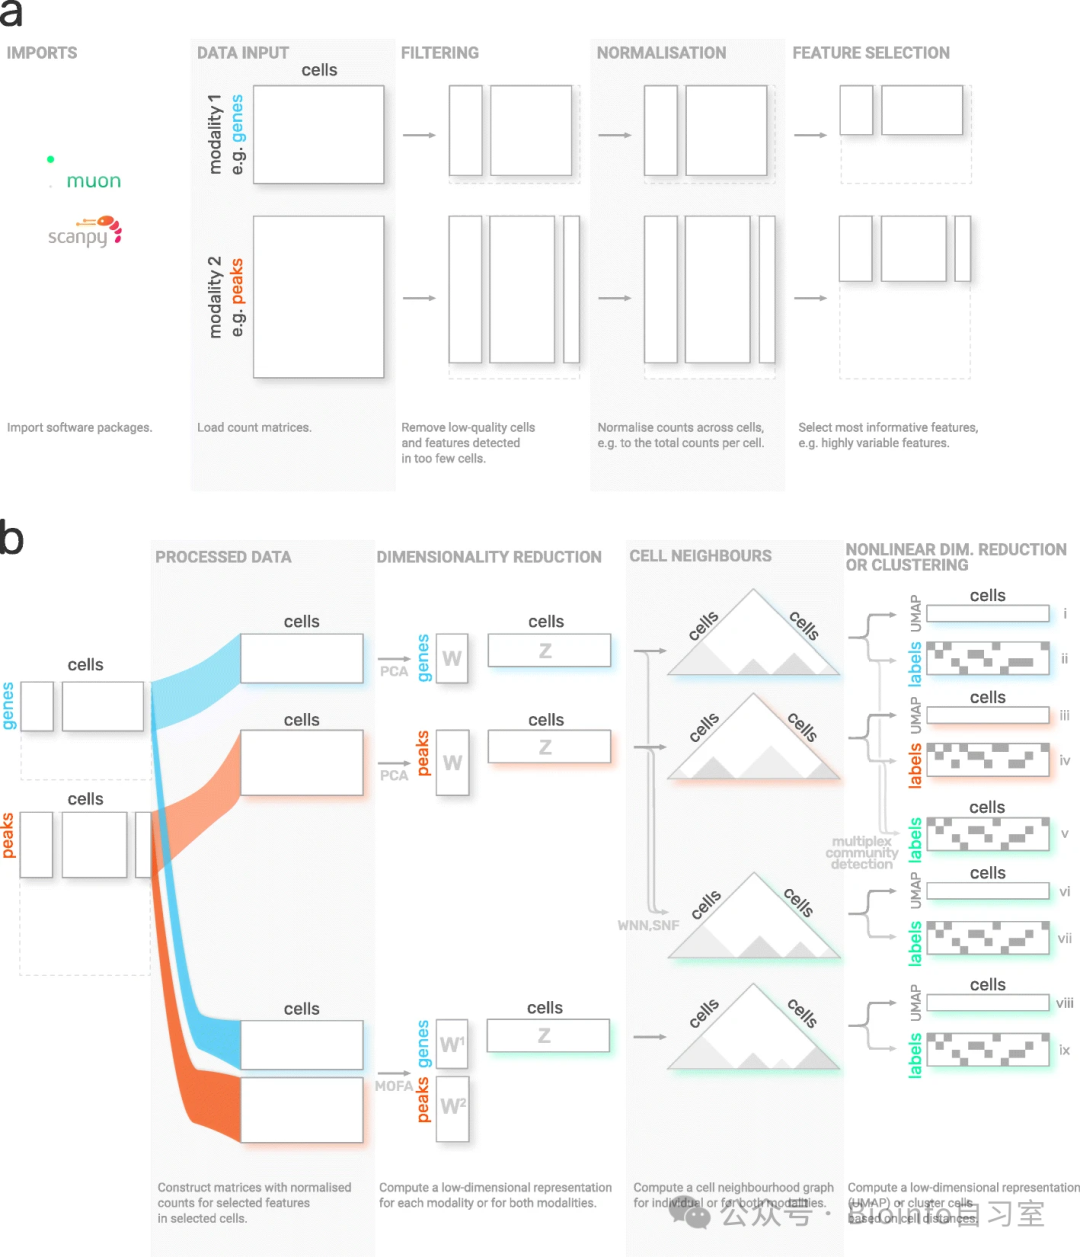 muon概览(图片来源:Bredikhin et al., 2022)
安装muon
muon可以通过PyPI安装:
pip install muon
muon的组织结构
muon的功能组织同样很有条理,遵循两个层次的分类:
- 1. 功能类型分类 (与scanpy类似):
- •
mu.pp: 预处理函数 - •
mu.tl: 分析工具函数 - •
mu.pl: 可视化绘图函数
- •
- 2. 数据类型分类 :
- •
mu.atac: 专门处理ATAC-seq数据的函数 - •
mu.prot: 专门处理蛋白质数据的函数
- •
这种组织方式就像一个双层分类的图书馆,既可以按功能类型(小说、科学书、参考书),也可以按主题(历史、生物、物理)来查找书籍。例如,如果你需要ATAC数据的预处理函数,可以在mu.atac.pp中找到。
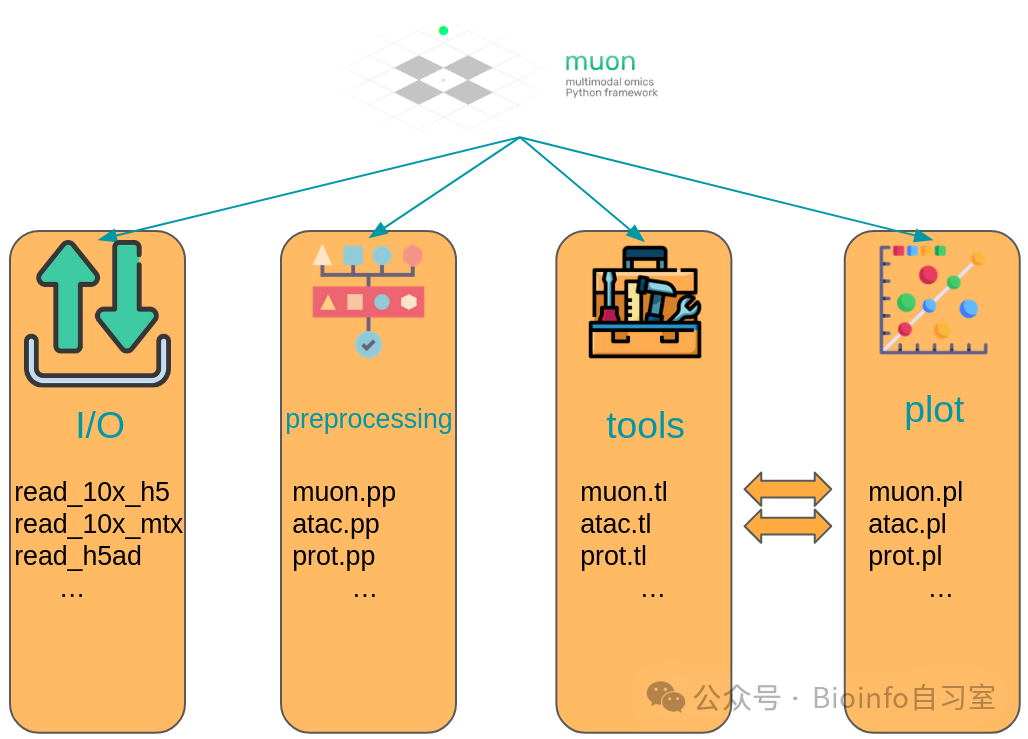 muon API概览
muon实际操作演示
请上我们的老朋友pbmc。跟上一部分一样,这只是一个演示,不是完整分析,目的是让大家了解muon的基本用法。这次使用的是10x Genomics的Multiome数据集,这是一种先进的技术,可以同时测量同一批细胞的RNA表达和染色质可及性。
首先,加载数据:
# 导入必要的库
import mudatasets as mds
import muon as mu

# 下载并加载公开的PBMC多组学数据集
mdata, _ = mds.load("pbmc10k_multiome", with_info=True, full=True)

# 确保变量名称唯一,避免后续分析出错
mdata.var_names_make_unique()
这个mdata对象包含多种数据类型。我们先聚焦于ATAC部分(染色质可及性数据):
# 提取ATAC数据部分
atac = mdata.mod["atac"]
尽管ATAC数据和RNA数据测量的是不同的生物分子,但它们面临的一些数据质量问题很相似。因此,我们可以复用scanpy中的一些通用处理函数。
需要注意的是,在ATAC数据中,我们关注的不是"基因"而是"峰"(peak)—— 这些是染色质开放的区域,代表可能有转录活动的DNA位置。峰相当于ATAC数据中的特征,就像基因是RNA数据中的特征一样。
接下来,我们需要进行质量控制,筛选出高质量的数据:
# 导入scanpy用于基础分析
import scanpy as sc

# 计算质量控制指标
sc.pp.calculate_qc_metrics(atac, percent_top=None, log1p=False, inplace=True)

# 用小提琴图可视化关键指标
sc.pl.violin(atac, ["total_counts", "n_genes_by_counts"], jitter=0.4, multi_panel=True)
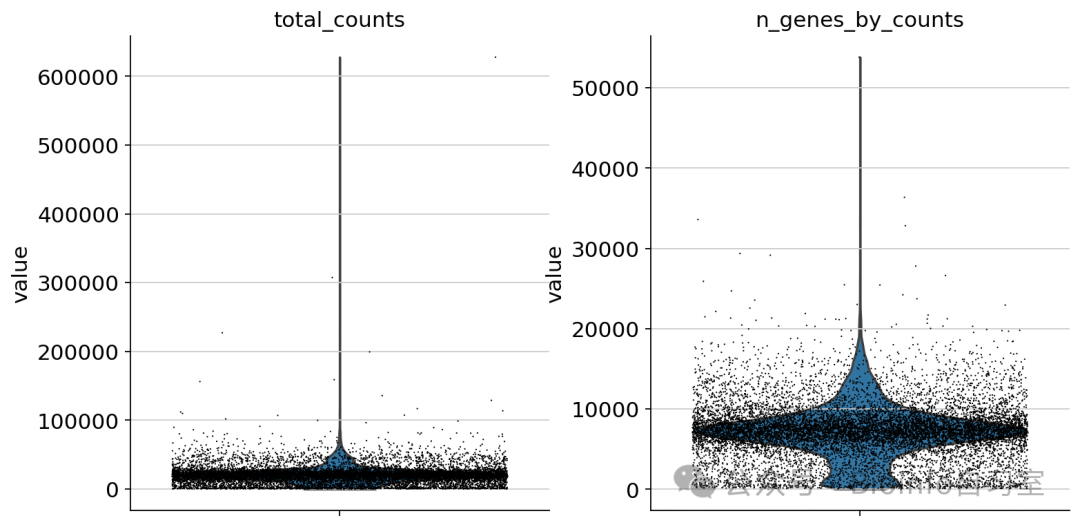 过滤前小提琴图
查看图表后,我们可以设置过滤标准。首先,过滤那些很少出现的峰值(可能是背景噪声):
# 过滤在少于10个细胞中检测到的峰值
mu.pp.filter_var(atac, "n_cells_by_counts", lambda x: x >= 10)
# 查看过滤后指标
sc.pl.violin(atac, ["n_genes_by_counts", "total_counts"], jitter=0.4, multi_panel=True)
muon提供了filter_var函数,比scanpy的等效函数更高效,因为它直接修改原始数据而不是创建副本,节省内存空间。
接下来,我们需要过滤质量可疑的细胞:
# 根据检测到的峰值数量过滤细胞(太少可能是空液滴,太多可能是多细胞)
mu.pp.filter_obs(atac, "n_genes_by_counts", lambda x: (x >= 2000) & (x <= 15000))

# 根据测序读数总数过滤细胞
mu.pp.filter_obs(atac, "total_counts", lambda x: (x >= 4000) & (x <= 40000))

# 过滤后再查看分布
sc.pl.violin(atac, ["n_genes_by_counts", "total_counts"], jitter=0.4, multi_panel=True)
⚠️再次提醒,这里使用的质控标准不是唯一的,具体方法将在后续章节具体讨论
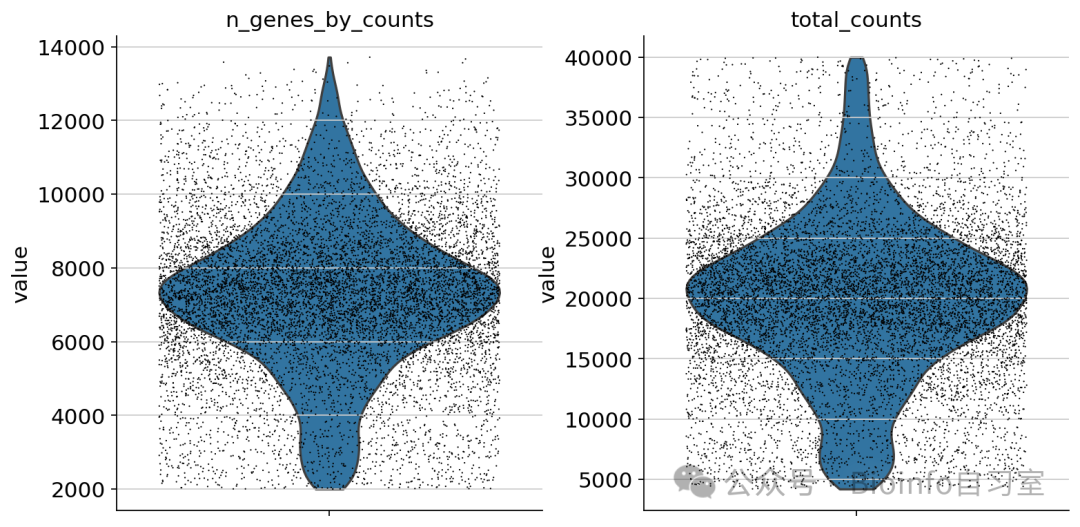 过滤后
muon还提供了另一种可视化方式——直方图,帮助我们从不同角度理解数据分布:
mu.pl.histogram(atac, ["n_genes_by_counts", "total_counts"])
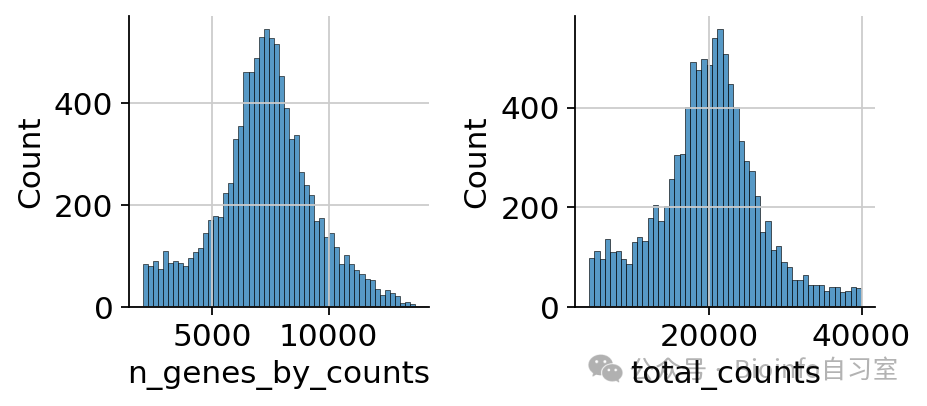 直方图
直方图和小提琴图各有优势:直方图清晰显示分布的形状和峰值,而小提琴图则更好地展示了分布的细节和离群值。
在基本质量控制后,我们可以使用muon中专门为ATAC数据设计的功能。ATAC数据有其特殊性,需要一些特定的分析方法:
# 导入ATAC专用模块
from muon import atac as ac

# ATAC数据特有的质量控制:检查核小体信号
# (这有助于评估染色质开放程度的可靠性)
atac.obs["NS"] = 1
ac.tl.nucleosome_signal(atac, n=1e6)

# 从RNA数据获取基因注释信息,帮助解释ATAC峰值
ac.tl.get_gene_annotation_from_rna(mdata["rna"]).head(3)

# 计算转录起始位点(TSS)富集度
# TSS富集是ATAC数据质量的重要指标
tss = ac.tl.tss_enrichment(mdata, n_tss=1000)
ac.pl.tss_enrichment(tss)
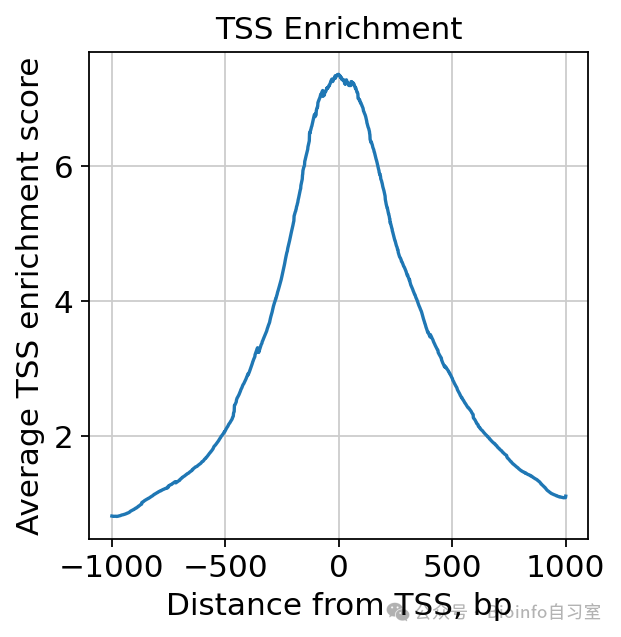 TSS富集度
TSS(转录起始位点)富集分析非常重要,因为基因的启动区域通常应该是染色质开放的(才能让转录因子结合)。如果我们的ATAC数据在这些区域确实显示富集信号,说明数据质量较好。
接下来,我们需要标准化数据并选择重要特征,类似于RNA分析中的步骤:
# 保存原始数据以备后用
atac.layers["counts"] = atac.X

# 将每个细胞的计数标准化到相同水平
sc.pp.normalize_per_cell(atac, counts_per_cell_after=1e4)

# 对数转换,使分布更接近正态分布
sc.pp.log1p(atac)

# 鉴定高变异特征(信号变化最大的峰值)
sc.pp.highly_variable_genes(atac, min_mean=0.05, max_mean=1.5, min_disp=0.5)
atac.raw = atac
尽管PCA也常用于ATAC数据的初次降维,但潜在语义索引(LSI) 也经常使用。LSI在muon的ATAC模块中有相关函数。
#LSI降维
ac.tl.lsi(atac)
#之后跟scanpy流程差不多
sc.pp.neighbors(atac, use_rep="X_lsi", n_neighbors=10, n_pcs=30)
sc.tl.leiden(atac, resolution=0.5)
sc.tl.umap(atac, spread=1.5, min_dist=0.5, random_state=20)
sc.pl.umap(atac, color=["leiden", "n_genes_by_counts"], legend_loc="on data")
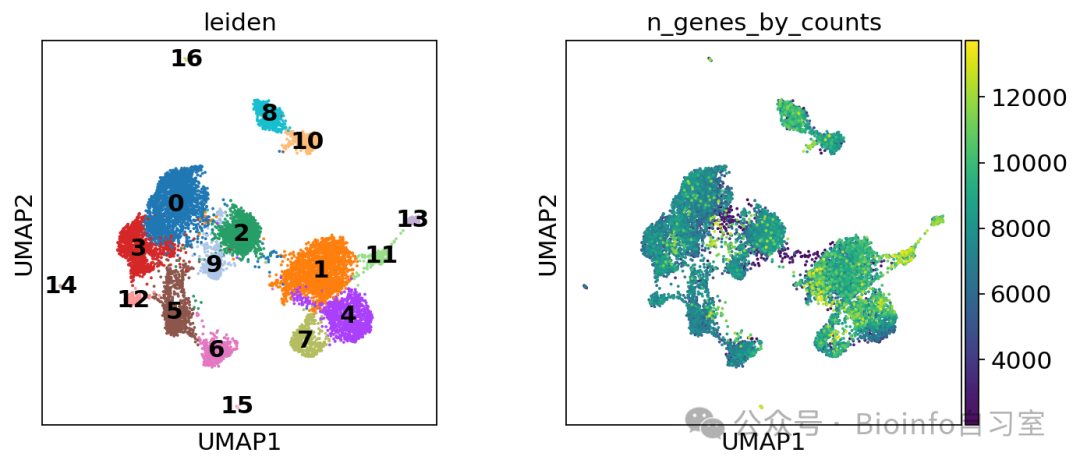 umap
我们可以使用muon中ATAC模块的功能,通过对应于特定基因的峰值中的切割值来为图进行着色。
ac.pl.umap(atac, color=["KLF4"], average="peak_type")
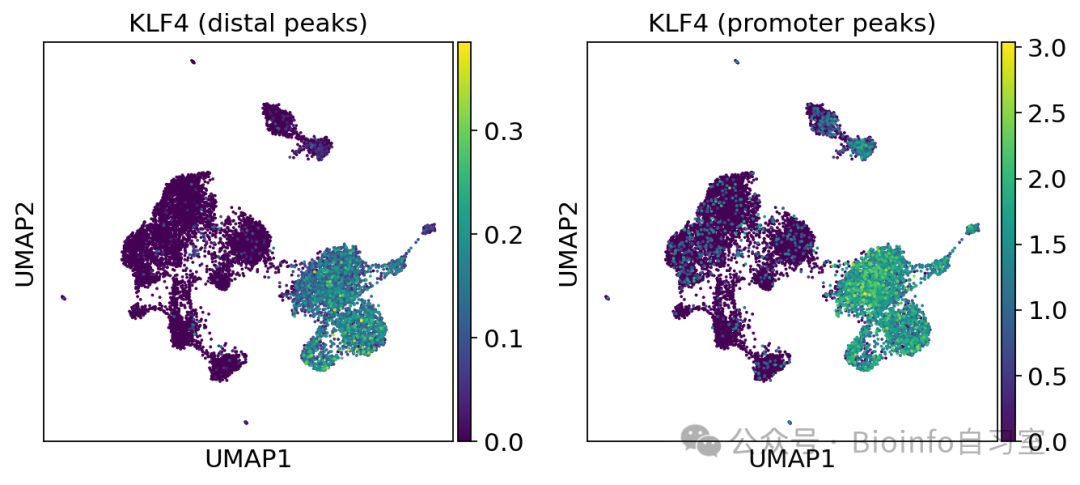 klf4峰
03
后记
本期我们介绍了单细胞分析领域的两个重要工具:scanpy和muon。它们是scverse生态系统的核心组件,分别针对单模态和多模态数据分析。
scanpy自2018年推出以来,已成为单细胞RNA测序数据分析的标准工具之一。它具有高效的实现和丰富的功能,能够处理从几千到几百万个细胞不等的数据集。在单细胞领域的竞争环境中,scanpy以其速度和灵活性在Python生态系统中脱颖而出。
随着多组学技术的发展,muon应运而生,填补了多模态数据分析的空白。它不仅继承了scanpy的设计理念,还添加了对ATAC-seq、CITE-seq等数据类型的特殊支持。muon的一个重要特点是能够同时分析和整合多种数据类型,这对于理解细胞状态的全貌至关重要。
这两个工具都采用了模块化设计,使用户能够根据需要选择合适的分析方法。它们与Python的数据科学生态系统无缝集成,便于用户将单细胞分析与其他分析流程结合。
scverse生态系统正在快速发展,不断有新的工具和方法加入。因此,关注官方文档和最新更新非常重要,以便及时了解新功能和最佳实践。
在下一篇教程中,我们将探讨不同生态系统之间的数据转换方法,特别是如何在R和Python工具之间切换及传递数据,敬请期待!本章英文原文、扩展阅读,以及用到的示例数据、完整代码,可以在后台回复scbp04获取。
----------
单细胞领域大牛编写的最强硬核单细胞教程来啦!想要追更学习笔记,请给我们加一个小✨,这样最新的推送才会显示在主页: