跟着Theis Lab学单细胞: MuData-多模态数据好帮手
跟着Theis Lab学单细胞: MuData-多模态数据好帮手
单细胞最佳实践
MuData操作指南
本章导读 SECTION PREVIEW
1. 了解多模态数据的特点与存储需求
2. 安装MuData,掌握多模态数据的结构
3. 学习MuData的基础操作和读写方式
本节对应原书 4.4 Advanced: Using MuData to store multimodal data
在之前的教程中,我们学习了如何使用AnnData处理单模态数据(如单细胞RNA测序数据)。随着实验技术的发展,多模态测序技术如CITE-Seq可以同时测量细胞的RNA和表面蛋白表达,一次实验获得多种组学数据,大大提高了实验效率。
然而,这些多模态数据需要特殊的数据结构来存储和管理。AnnData主要设计用于单模态数据,对于多模态数据,我们需要使用MuData(多模态数据结构)。
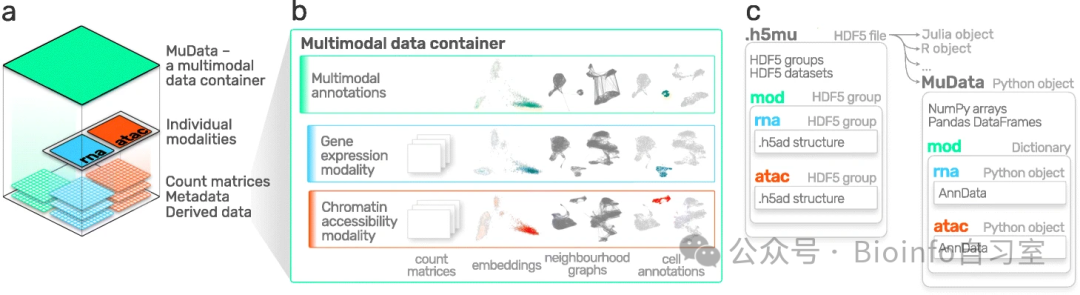 MuData概览。Bredikhin et al., 2022
安装MuData
MuData可以通过PyPI或Conda安装,二选一:
pip install mudata
# 或者
conda install -c conda-forge mudata
4.4.2 初始化MuData对象
MuData的核心设计思想是将多个AnnData对象(每个代表一种模态的数据)组织在一起,同时提供存储跨模态注释信息的能力。
从结构上看,MuData包含一个字典(dict,顾名思义,就是一组成对出现的数据),其中键(key)是模态名称 ,值(value)是对应的AnnData对象。此外,MuData还具有类似于AnnData的属性,如.obs(样本注释)、.obsm(多维样本注释)等,用于存储全局的多模态信息。
让我们简单看看MuData是如何工作的:
import mudata as md
创建一些模拟数据:
import numpy as np
import anndata as ad

# 创建一些模拟数据
n, d, k = 1000, 100, 10  # n=样本数, d=特征数, k=潜在维度

# 生成随机数据
z = np.random.default_generator().normal(
    loc=np.arange(k), scale=np.arange(k) * 2, size=(n, k)
)
w = np.random.default_generator().normal(size=(d, k))
y = np.dot(z, w.T)  # 形状: (1000, 100)
创建两个AnnData对象,代表两种模态:
# 创建第一个模态的AnnData
adata = ad.AnnData(y)
adata.obs_names = [f"obs_{i+1}"for i inrange(n)]  # 样本名称
adata.var_names = [f"var_{j+1}"for j inrange(d)]  # 特征名称

# 创建第二个模态的AnnData
d2 = 50# 第二个模态有50个特征
w2 = np.random.default_generator().normal(size=(d2, k))
y2 = np.dot(z, w2.T)  # 形状: (1000, 50)

adata2 = ad.AnnData(y2)
adata2.obs_names = [f"obs_{i+1}"for i inrange(n)]  # 样本名称(与第一个模态相同)
adata2.var_names = [f"var2_{j+1}"for j inrange(d2)]  # 特征名称
将这两个AnnData对象包装进一个MuData对象中:
# 创建MuData对象,命名第一个模态为"A",第二个为"B"
mdata = md.MuData({"A": adata, "B": adata2})

# 看看MuData对象的样子
print(mdata)
# 输出:
# MuData object with n_obs × n_vars = 1000 × 150
#   2 modalities
#     A:    1000 x 100
#     B:    1000 x 50
可以看到,这个MuData对象包含了1000个样本和150个特征(100+50),这些特征 (feature) 分布在两个模态中。
这里的模态A和模态B可以理解为同一批样本的两种不同测量数据。例如,在CITE-seq数据中,模态A代表RNA测序数据,模态B代表表面蛋白测量数据。两个模态具有相同的样本(细胞),但测量的特征(基因或蛋白)不同。
4.4.3 MuData的属性
MuData对象有很多属性,让我们来看看最常用的几个:
- 1. 模态访问 :通过
.mod属性或直接使用方括号访问各个模态
# 列出所有模态的名称
print(list(mdata.mod.keys()))  # 输出: ['A', 'B']

# 访问模态A
print(mdata.mod["A"])  # 方法1
print(mdata["A"])      # 方法2(简写形式)
- 2. 形状信息 :MuData的shape是各模态的综合
print(mdata.shape)    # 输出: (1000, 150)
print(mdata.n_obs)    # 输出: 1000(样本数)
print(mdata.n_vars)   # 输出: 150(特征总数)

# 查看各个模态的形状
print([adata.shape for adata in mdata.mod.values()])
# 输出: [(1000, 100), (1000, 50)]
- 3. 更新MuData :如果修改了原始的AnnData对象,需要更新MuData
# 修改模态B的特征名称
adata2.var_names = ["var_ad2_" + e.split("_")[1] for e in adata2.var_names]

# 查看MuData中的特征名称(尚未更新)
print("更新前的特征名称: ...", ", ".join(mdata.var_names[-3:]))

# 更新MuData
mdata.update()

# 再次查看特征名称(已更新)
print("更新后的特征名称: ...", ", ".join(mdata.var_names[-3:]))
注意⚠️ :MuData存储的是对原始AnnData对象的引用,而不是副本。这意味着如果你修改了原始的AnnData对象,这些修改也会反映到MuData中。
# 向原始的adata添加信息
adata.uns["随便写点啥"] = {"这是": "测试数据"}

# 通过MuData访问该信息
print(mdata.mod["A"].uns["随便写点啥"])  # 输出: {'这是': '测试数据'}
4.4.4 变量映射
当创建MuData对象时,会自动生成样本与模态之间以及特征与模态之间的映射关系。在我们的例子中,所有样本在两个模态中都是相同的,但特征是不同的。
# 检查样本映射是否完整(所有值都是True)
print(np.sum(mdata.obsm["A"]) == np.sum(mdata.obsm["B"]) == n)  # 输出: True

# 查看特征映射(对模态A,前100个是True,后50个是False)
print(mdata.varm["A"][:5], "...", mdata.varm["A"][-5:])
4.4.5 MuData视图
与AnnData类似,对MuData对象进行切片会创建原始数据的视图(view),而不是复制数据:
# 创建前100个样本和前10个特征的视图
view = mdata[:100, :10]
print(view.is_view)        # 输出: True
print(view["A"].is_view)   # 输出: True
如果需要对数据进行修改,应该创建一个副本(copy):
# 创建副本
mdata_sub = view.copy()
print(mdata_sub.is_view)  # 输出: False
4.4.6 共同样本
理想情况下,MuData的所有模态都包含相同的样本集合,但现实世界中经常会有数据缺失。MuData的设计考虑到了这种情况,它允许不同模态有不同的样本集合。你可以使用muon.pp.intersect_obs()等工具处理缺失数据。
4.4.7 MuData的读写操作
MuData对象可以序列化为基于HDF5的.h5mu文件,每个模态都存储在/mod组下:
# 写入文件
mdata.write("my_mudata.h5mu")

# 读取文件(backed=True表示数据留在磁盘上,不全部加载到内存)
mdata_r = md.read("my_mudata.h5mu", backed=True)
print(mdata_r)
如果原始对象是backed的,那么在创建副本时需要提供文件名:
mdata_sub = mdata_r.copy("mdata_sub.h5mu")
print(mdata_sub.is_view)   # 输出: False
print(mdata_sub.isbacked)  # 输出: True
4.4.8 多模态分析方法
当你的MuData对象准备好后,就可以使用多模态分析方法来处理数据了。最简单的方法是将多个模态的矩阵拼接起来,然后进行降维等操作。
例如,我们可以通过水平拼接两个模态的数据矩阵,然后进行主成分分析(PCA):
# 将两个模态的矩阵拼接
x = np.hstack([mdata.mod["A"].X, mdata.mod["B"].X])
print(x.shape)  # 输出: (1000, 150)

# 定义一个简单的PCA函数
defsimple_pca(mdata):
    from sklearn import decomposition

    # 水平拼接所有模态的数据矩阵
    x = np.hstack([m.X for m in mdata.mod.values()])

    # 执行PCA,保留2个主成分
    pca = decomposition.PCA(n_components=2)
    components = pca.fit_transform(x)

    # 将主成分存储在MuData的.obsm属性中
    mdata.obsm["X_pca"] = components

# 运行PCA
simple_pca(mdata)
print(mdata)
需要注意的是,在实际应用中,不同模态的特征通常具有不同的生成机制和分布特性,直接拼接可能不是最优的整合策略。对于组学数据,我们通常需要使用专门的多组学整合方法。muon包提供了多种多模态整合算法,能够更有效地挖掘不同模态数据之间的关联信息。在后续教程中,我们将详细介绍这些方法。
后记
本期带大家详细了解了MuData对象的结构和基础操作,这些内容为后续的多模态数据分析奠定了基础。随着CITE-seq、ATAC-seq等多模态技术的发展,处理不同类型的组学数据已成为单细胞分析中的必备技能。MuData通过将多个AnnData对象有机地组织在一起,解决了多模态数据的存储和分析问题。
值得注意的是,与AnnData类似,MuData也支持"视图"和"副本"机制,这使得它能够高效地处理大规模数据。通过直接与磁盘上的文件建立连接,MuData可以减少内存占用,加快数据处理速度。这一特性对于处理越来越大的单细胞多组学数据集至关重要。
简单回顾一下:
- 1. MuData是AnnData的扩展,专门用于存储和处理多模态数据
- 2. 一个MuData对象包含多个AnnData对象(每个代表一种模态)
- 3. MuData不仅存储各个模态的数据,还可以存储跨模态的注释信息
- 4. 通过MuData,你可以轻松地进行单模态操作或多模态整合分析
在下一篇教程中,我们将深入探讨如何使用muon包进行多模态数据分析。敬请期待!本章英文原文、扩展阅读,以及用到的示例数据、完整代码,可以在后台回复scbp04获取。
----------
单细胞领域大牛编写的最强硬核单细胞教程来啦!想要追更学习笔记,请给我们加一个小✨,这样最新的推送才会显示在主页: