跟着Theis Lab学单细胞: 给RNA“测速”
跟着Theis Lab学单细胞: 给RNA“测速”
单细胞最佳实践
拟时序
本章导读 SECTION PREVIEW
1. RNA速率如何从静态数据中推断细胞的动态发育方向?
2. 剪接动力学模型:未剪接RNA(unspliced)和已剪接RNA(spliced)的比值,如何暗示基因表达的"未来走向"?
3. 两种主流模型:稳态模型(Steady-state)和EM模型各有什么假设与局限?
4. 实战演练:以经典的胰腺内分泌发育数据为例,手把手带你跑通scVelo流程
5. 避坑指南:RNA velocity并非万能,什么情况下它会"翻车"?
本节对应原书 14 RNA Velocity
上一章中提到过,单细胞RNA测序是破坏性的。一旦对细胞进行测序,细胞就被裂解了,我们无法再追踪同一个细胞在后续时间点的变化。换句话说,单细胞数据本质上是一张 "快照"(snapshot) ,而非一段连续的"延时摄影"。
想象你在火车站拍了一张照片,照片里有站在不同位置的旅客。你能猜到哪些人是刚进站的、哪些人即将上车吗?单细胞数据面临的正是类似的挑战——我们只有一个时间点的信息,却想推断细胞的"过去"和"未来" 。
传统的轨迹推断(Trajectory Inference, TI) 方法可以帮助我们在发育景观中定位细胞的相对位置,但它们通常只能告诉我们细胞"在哪里",而无法告诉我们细胞"往哪里去"——也就是说,缺乏方向性 的信息。
RNA速率(RNA velocity) 的出现,正是为了填补这一空白。它利用scRNA-seq数据中一个常被忽视的信息——未剪接RNA(unspliced RNA)与已剪接RNA(spliced RNA)的比例 ——来推断基因表达变化的方向和速度。
RNA velocity的生物学基础
从DNA到成熟mRNA的旅程
给大家补补课。基因表达是一个动态过程,大致可以分为以下步骤:
转录(Transcription) :DNA被转录为前体mRNA(pre-mRNA) ,也称为未剪接RNA(unspliced RNA) 。此时的RNA包含外显子(exon)和内含子(intron)。
剪接(Splicing) :内含子被切除,外显子被拼接在一起,形成成熟mRNA(mature mRNA) ,即已剪接RNA(spliced RNA) 。
降解(Degradation) :成熟mRNA最终会被细胞降解。
你可以把这个过程想象成一条流水线:原材料(unspliced)进来,加工成成品(spliced),成品最终报废。如果流水线上原材料堆积得越来越多,说明生产正在"加速";反之,如果原材料越来越少而成品还在,说明生产正在"减速"。
核心数学模型
RNA velocity的核心思想可以用以下两个微分方程描述:
其中:
- :未剪接RNA的丰度
- :已剪接RNA的丰度
- :转录速率(transcription rate)
- :剪接速率(splicing rate)
- :降解速率(degradation rate)
RNA velocity 被定义为已剪接RNA丰度随时间的变化率,即 。
★
小编注 :这个模型假设每个基因的动力学是独立的,即基因A的转录速率不影响基因B。虽然这是一个简化假设,但在许多场景下是合理的近似。
参数推断的两种主流方法
由于单细胞数据没有真实的时间标签,我们无法直接用传统的动力学参数估计方法。RNA velocity算法另辟蹊径,通过分析相位图(phase portrait) ——即unspliced与spliced RNA丰度的散点图——来推断参数。
稳态模型(Steady-state Model)
这是RNA velocity最早的实现方式 (La Manno et al., Nature 2018),其核心假设包括:
- 动力学已经达到稳态(equilibrium)
- 转录、剪接、降解速率保持恒定
- 所有基因共享相同的剪接速率
在稳态条件下,相位图会呈现一个标志性的 "杏仁形"(almond shape) :上半弧对应基因诱导期(induction),下半弧对应基因抑制期(repression)(下图d)。
稳态模型通过对极端分位数的数据进行线性回归 来估计稳态比例(steady-state ratio),然后将每个细胞相对于这条拟合线的残差 定义为RNA velocity。
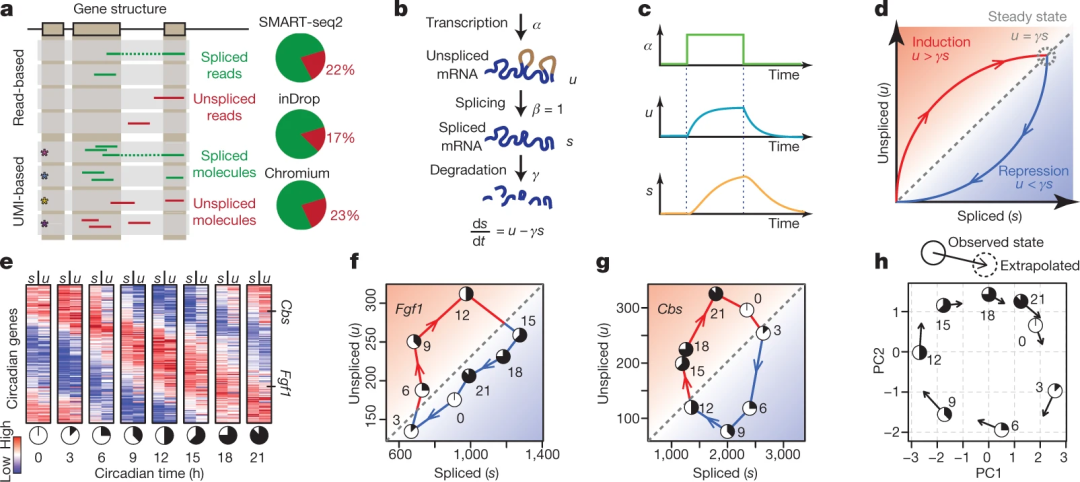 稳态模型示意图。来源: La Manno et al., Nature 2018
EM模型(Dynamical Model)
为了克服稳态模型的局限,scVelo引入了更灵活的EM模型 (也称为动态模型)。
改进之处 :
- 不再假设已达到稳态
- 允许每个基因有独立的剪接速率
- 使用全部数据点 进行参数推断
- 同时推断每个细胞的潜在时间(latent time)
该算法采用期望最大化(Expectation-Maximization, EM) 框架:
- E步 :估计每个细胞的潜在时间和状态(诱导、抑制或稳态)
- M步 :基于E步的结果,更新模型参数
★
小编注 :EM模型虽然更强大,但也不是万能的。它仍然假设速率恒定,而且对相位图的形状有一定要求。如果你的数据中某个基因的相位图完全不像"杏仁",那么模型拟合可能会出问题。
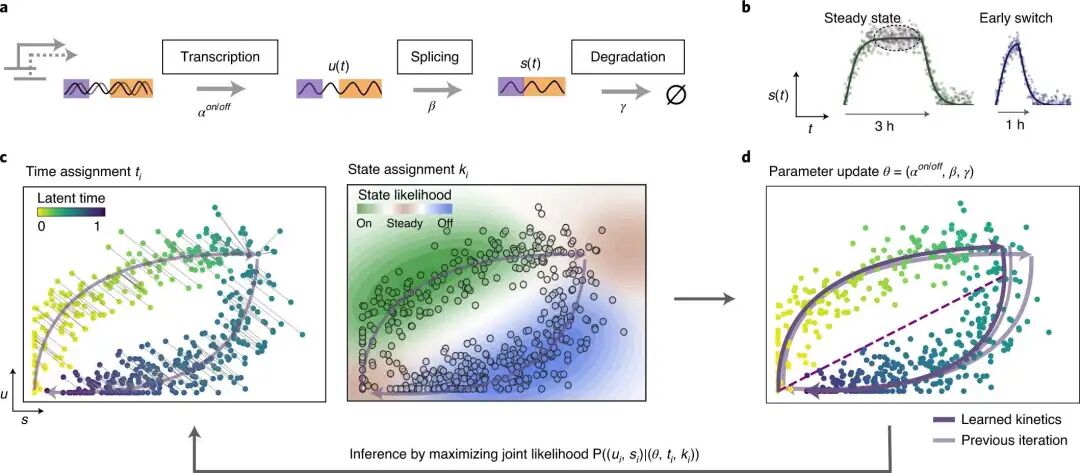 稳态模型的示意图。来源: Bergen et al., Nat Biotechnol 2020
实战:胰腺内分泌发育分析
下面,我们以经典的胰腺内分泌发育数据 为例,演示如何使用scVelo进行RNA velocity分析。
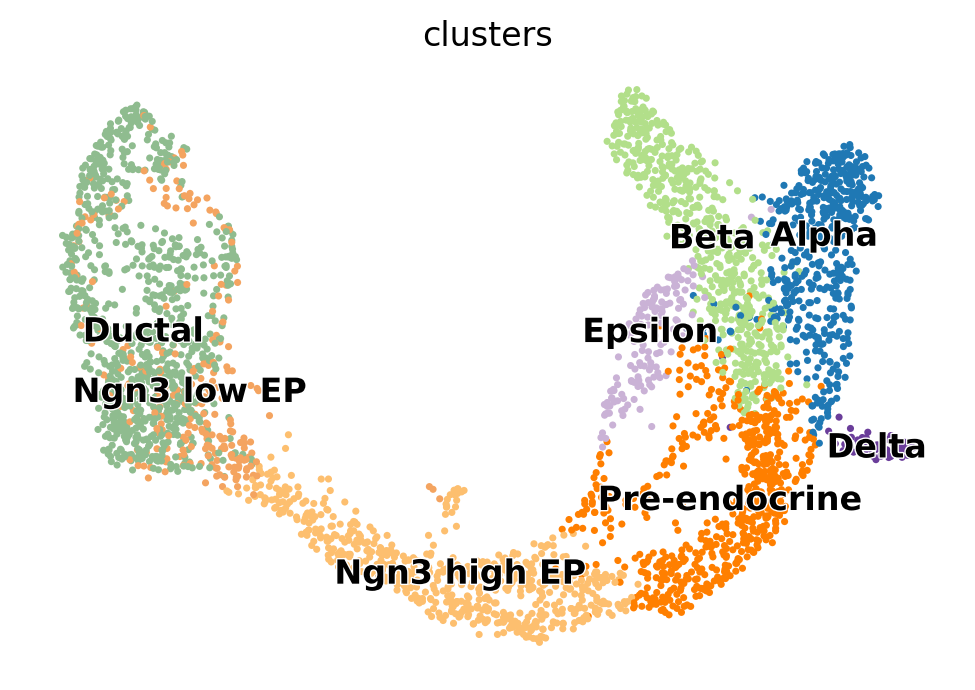
这个数据集来自Bastidas-Ponce等人2019年发表的研究,描述了胰腺前内分泌细胞(Ductal, Ngn3 low EP, Ngn3 high EP, Pre-endocrine)分化为四种成熟内分泌细胞(Alpha, Beta, Delta, Epsilon)的过程。
环境配置与数据加载
from pathlib import Path
import scanpy as sc
import scvelo as scv

scv.settings.set_figure_params("scvelo")

DATA_DIR = Path("../../data/")
DATA_DIR.mkdir(parents=True, exist_ok=True)
FILE_PATH = DATA_DIR / "pancreas.h5ad"

adata = scv.datasets.pancreas(file_path=FILE_PATH)
adata
输出:
AnnData object with n_obs × n_vars = 3696 × 27998
    obs: 'clusters_coarse', 'clusters', 'S_score', 'G2M_score'
    var: 'highly_variable_genes'
    uns: 'clusters_coarse_colors', 'clusters_colors', 'day_colors', 'neighbors', 'pca'
    obsm: 'X_pca', 'X_umap'
    layers: 'spliced', 'unspliced'
    obsp: 'distances', 'connectivities'
注意layers中包含了spliced和unspliced两层数据,这正是RNA velocity分析所需的核心输入。如果你的数据没有这两层,需要先用专门的定量工具(如alevin-fry、kallisto bustools等)重新处理原始fastq文件。
数据预处理
scRNA-seq数据通常很嘈杂,需要先进行预处理:
scv.pp.filter_and_normalize(adata, min_shared_counts=20, n_top_genes=2000)
输出:
Filtered out 20801 genes that are detected 20 counts (shared).
Normalized count data: X, spliced, unspliced.
Extracted 2000 highly variable genes.
Logarithmized X.
这一步完成了:
- 过滤低表达基因(spliced和unspliced都至少要有20个counts)
- 文库大小归一化
- 提取2000个高变异基因
- 对数转换
接下来,计算PCA和邻域图,并对表达量进行邻域平滑(moment smoothing) :
sc.tl.pca(adata)
sc.pp.neighbors(adata)
scv.pp.moments(adata, n_pcs=None, n_neighbors=None)
输出:
computing moments based on connectivities
    finished (0:00:00) --> added
    'Ms' and 'Mu', moments of un/spliced abundances (adata.layers)
★
小编注 :邻域平滑是RNA velocity分析中非常关键的一步。由于单细胞数据极度稀疏,直接使用原始counts会导致相位图过于嘈杂。平滑后的
Ms和Mu分别代表已剪接和未剪接RNA的"平滑表达量",是后续建模的基础。
可视化一下我们的数据:
scv.pl.scatter(adata, basis="umap", color="clusters")
4.3 稳态模型的RNA velocity推断
首先,我们用稳态模型(mode="deterministic")计算RNA velocity:
scv.tl.velocity(adata, mode="deterministic")
输出:
computing velocities
    finished (0:00:00) --> added
    'velocity', velocity vectors for each individual cell (adata.layers)
计算velocity graph并可视化为流线图(stream plot):
scv.tl.velocity_graph(adata, n_jobs=8)
scv.pl.velocity_embedding_stream(adata, basis="umap", color="clusters")
输出:
computing velocity graph (using 8/96 cores)
    finished (0:00:05) --> added
    'velocity_graph', sparse matrix with cosine correlations (adata.uns)
computing velocity embedding
    finished (0:00:00) --> added
    'velocity_umap', embedded velocity vectors (adata.obsm)
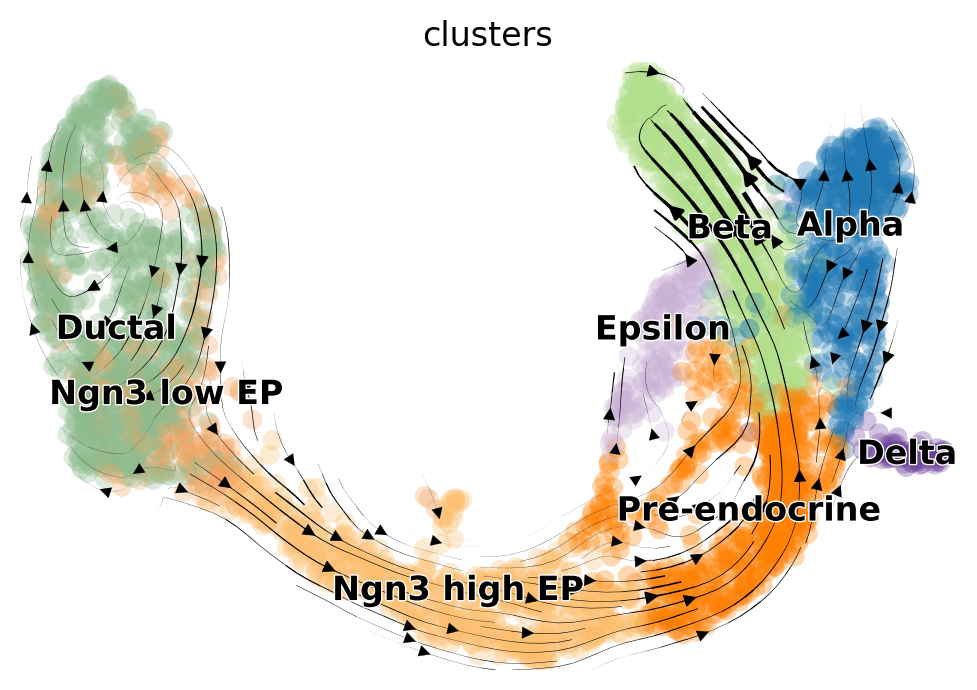 Steady-state velocity stream
4.4 EM模型(动态模型)的RNA velocity推断
接下来,我们使用更先进的EM模型。首先需要恢复剪接动力学参数:
scv.tl.recover_dynamics(adata, n_jobs=8)
输出:
recovering dynamics (using 8/96 cores)
    finished (0:01:00) --> added
    'fit_pars', fitted parameters for splicing dynamics (adata.var)
★
小编注 :这一步是EM模型的核心,会耗费较长时间。它会为每个基因独立拟合剪接动力学参数(α, β, γ),并估计每个细胞在每个基因上的潜在时间。
我们可以查看哪些基因被拟合得最好(通过fit_likelihood排序):
top_genes = adata.var["fit_likelihood"].sort_values(ascending=False).index
scv.pl.scatter(adata, basis=top_genes[:5], color="clusters", frameon=False)
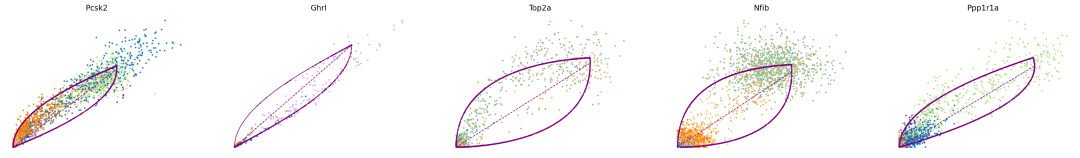 Top genes phase portraits
★
小编注 :上图展示了5个拟合质量最高的基因的相位图。紫色曲线是模型拟合的轨迹,虚线是稳态比例线。可以看到Pcsk2、Top2a、Ppp1r1a呈现较好的"杏仁形",表示模型拟合可靠;而Nfib和Ghrl的相位图形状不太理想,可能需要谨慎解读。
有了动力学参数,就可以计算动态模型的velocity:
scv.tl.velocity(adata, mode="dynamical")
scv.tl.velocity_graph(adata, n_jobs=8)
scv.pl.velocity_embedding_stream(adata, basis="umap")
输出:
computing velocities
    finished (0:00:02) --> added
    'velocity', velocity vectors for each individual cell (adata.layers)
computing velocity graph (using 8/96 cores)
    finished (0:00:02) --> added
    'velocity_graph', sparse matrix with cosine correlations (adata.uns)
computing velocity embedding
    finished (0:00:00) --> added
    'velocity_umap', embedded velocity vectors (adata.obsm)
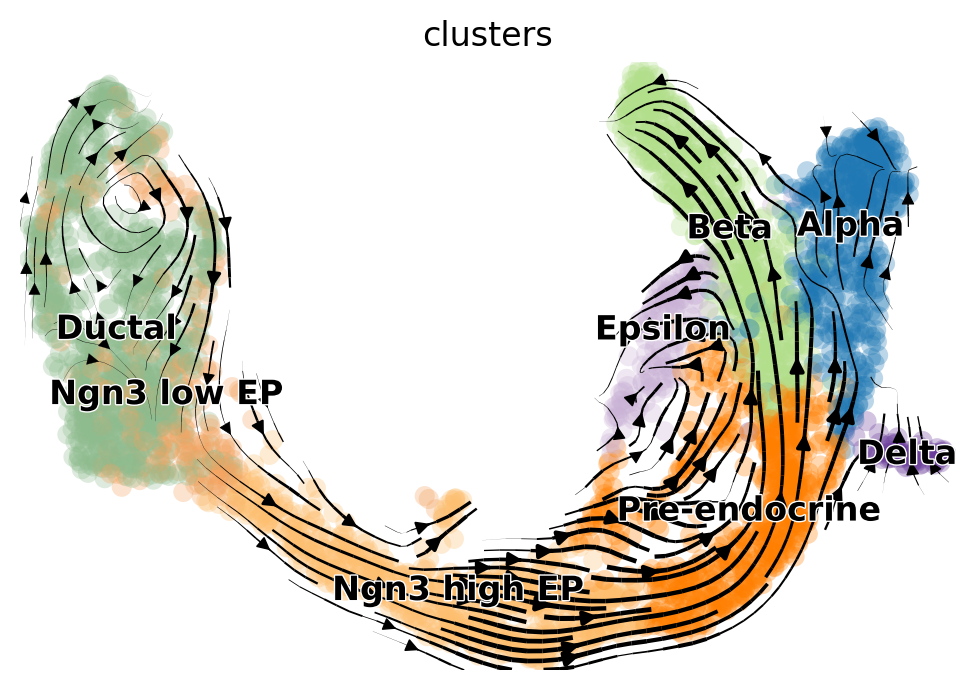 EM model velocity stream
4.5 两种模型的比较
对比两种模型的结果,我们可以发现:
- EM模型更好地捕获了Ductal细胞的细胞周期 :流线图中可以看到明显的旋转模式
- 稳态模型存在"逆流"问题 :从Alpha到Pre-endocrine出现了不合理的回流箭头
★
小编注 :尽管2D流线图直观易懂,但它本质上是将高维velocity向量投影到低维空间,可能会引入伪影。如果需要严格的定量分析,建议使用CellRank等下游工具在高维空间中进行。
关键要点与避坑指南
RNA velocity适用的场景
发育过程的时间尺度必须与RNA半衰期相当
- ✅ 胚胎发育、内分泌分化等快速过程
- ❌ 阿尔茨海默病、帕金森病等长期慢性疾病
- ❌ 外周血单核细胞(PBMC)等稳态系统(成熟细胞类型之间没有转换)
相位图需要呈现预期的"杏仁形"
- 如果某个基因的相位图形状异常(如出现多个分支),应谨慎使用或将数据分割为单独的谱系分析
常见的"翻车"场景
模型假设被违反
- 例如,红细胞成熟过程中转录速率会发生显著变化,此时恒定速率假设不成立
低维投影的误导
- 流线图高度依赖于基因选择和绑图参数
- 嵌入空间边缘区域的投影质量通常较差
稀有细胞类型的影响
- 如上文中Epsilon细胞数量很少,相位图中只有寥寥数点,模型拟合不可靠
最佳实践建议
- 检查相位图 :在解读结果之前,务必查看关键基因的相位图,确认模型拟合质量
- 使用CellRank进行下游分析 :避免过度依赖2D流线图,在高维空间中进行命运推断
- 结合先验知识 :如果velocity方向与已知的生物学知识矛盾,很可能是模型出了问题
新方向与前沿进展
RNA velocity领域正在快速发展,一些新方法正在尝试解决当前模型的局限:
| 方法/工具 | 主要改进 |
|---|---|
| CellRank | 在高维空间中进行细胞命运推断,避免低维投影的伪影 |
| veloVI | 变分推断框架,为velocity估计提供不确定性量化 |
| DeepVelo | 使用神经ODE建模,允许非恒定速率 |
| VeloVAE | 直接使用原始counts,避免预处理引入的偏差 |
★
小编注 :如果你对RNA velocity的理论和局限想有更深入的了解,强烈推荐阅读Bergen等人2021年在Molecular Systems Biology发表的综述"RNA velocity—current challenges and future perspectives"。
本章英文原文及完整代码,可以在后台回复scbp14 获取。
参考文献
- La Manno G, et al. RNA velocity of single cells. Nature. 2018.
- Bergen V, et al. Generalizing RNA velocity to transient cell states through dynamical modeling. Nature Biotechnology. 2020.
- Bergen V, et al. RNA velocity—current challenges and future perspectives. Molecular Systems Biology. 2021.
- Bastidas-Ponce A, et al. Massive single-cell mRNA profiling reveals a detailed roadmap for pancreatic endocrinogenesis. Development. 2019.
- Lange M, et al. CellRank for directed single-cell fate mapping. Nature Methods. 2022.
- Gayoso A, et al. Deep generative modeling of transcriptional dynamics for RNA velocity analysis in single cells. Nature Biotechnology. 2022.
Bioinfo自习室交流群欢迎各位生信爱好者加入!欢迎后台戳戳小编。
----------
单细胞领域大牛编写的最强硬核单细胞教程来啦!想要追更学习笔记,请给我们加个✨,不错过最新推送: