跟着Theis Lab学单细胞: 聚类、降维傻傻分不清?
跟着Theis Lab学单细胞: 聚类、降维傻傻分不清?
单细胞最佳实践
聚类分析
本章导读 SECTION PREVIEW
1. 理解单细胞聚类分析的生物学意义和技术原理
2. 掌握KNN图构建和Leiden算法的核心概念
3. 学会使用不同分辨率参数控制聚类粒度
4. 实战:使用scanpy进行聚类分析和结果可视化
本节对应原书 10 Clustering
在之前的章节中,我们已经学会了如何对单细胞RNA测序数据进行预处理和降维可视化。通过PCA、UMAP等方法,我们能够在二维平面上看到细胞的分布模式。但此时的细胞还只是一个个抽象的点,我们还不知道它们代表什么类型的细胞。
接下来的自然步骤就是识别数据集中的细胞结构 ,也就是找出哪些细胞属于同一类型。这个过程通常叫做细胞身份注释(cell identity annotation)。为了实现这一目标,我们需要先将相似的细胞聚集成群,这就是聚类分析的核心任务。
★
降维 vs 聚类
很多初学者会混淆降维和聚类这两个概念。简单来说:
- 降维 (如PCA、UMAP)是将高维数据投射到低维空间,让我们能够可视化细胞的分布
- 聚类 是根据细胞的相似性将它们分组,每个组可能代表一种细胞类型
降维后的可视化图上,虽然我们能看到细胞聚集成团,但这些"团"并没有被正式定义。聚类算法的作用就是明确地划分出这些群组。
聚类的核心:KNN图
在单细胞分析中,我们通常基于K最近邻(KNN)图 来进行聚类。这个过程可以分为以下几步:
计算距离矩阵 :在降维后的表达空间(通常是前30-50个主成分)中,计算所有细胞两两之间的欧氏距离
构建KNN图 :
- 图中的每个节点代表一个细胞
- 每个细胞连接到它的K个最相似的邻居
- K值通常设置在5到100之间,具体取决于数据集的大小
社群(community)检测 :在KNN图上运行社区检测算法(如Leiden或Louvain),识别密集连接的区域
★
为什么要用KNN图?
KNN图能够很好地反映表达数据的拓扑结构。在基因表达空间中距离近的细胞,在KNN图中也会紧密连接。这种图结构特别适合用社群检测算法来识别细胞群体。
Leiden算法:聚类的利器
Leiden vs Louvain
Leiden算法是Louvain算法的改进版本。在多项基准测试中,这两种算法都显著优于其他单细胞聚类方法。但由于Louvain算法已不再维护,我们推荐使用Leiden算法 。
★
Leiden和Louvain的区别**
- Louvain算法 :早期广泛使用的社区检测算法,但存在一些缺陷,可能产生内部连接不够紧密的社区
- Leiden算法 :2019年提出的改进版本,保证产生的社区内部连接良好,结果更稳定可靠
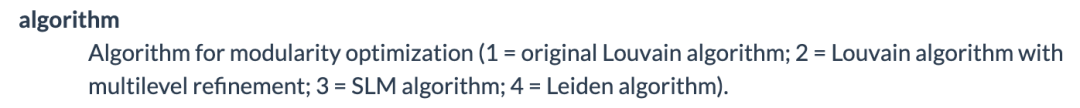
- Seurat默认使用Louvain算法,scanpy默认使用Leiden算法。但是Seurat的
FindClusters()也可以通过定义algorithm=4使用Leiden算法。
Leiden算法的工作原理
Leiden算法通过比较聚类内部的连接数量与整个数据集中预期的连接数量来创建聚类。具体步骤如下:
- 初始分区 :每个节点(细胞)自成一个社区
- 节点移动 :尝试将单个节点从一个社区移动到另一个社区,寻找更好的分区
- 分区细化 :对当前分区进行优化
- 网络聚合 :基于细化后的分区生成聚合网络
- 迭代优化 :重复上述过程,直到无法进一步改进
分辨率:“对齐颗粒度”
Leiden算法有一个重要的分辨率参数(resolution) ,它决定了聚类的精细程度:
- 较高的分辨率 (如1.0、2.0):产生更多、更小的聚类
- 较低的分辨率 (如0.25、0.5):产生更少、更大的聚类
选择合适的分辨率参数对后续的细胞类型注释至关重要。
★
一般分辨率达到0.8-1.0就可以分出较精细的群了。也可以先选一个较低的分辨率,如0.1-0.2,然后再去做亚群分析。
实战:人类骨髓细胞聚类分析
让我们用一个实际的例子来演示如何进行聚类分析。我们使用NeurIPS人类骨髓数据集中的一个样本(site4-donor8)。
1. 加载数据和基础设置
import scanpy as sc

# 设置scanpy参数
sc.settings.verbosity = 0
sc.settings.set_figure_params(dpi=80, facecolor="white", frameon=False)

# 加载预处理后的数据
adata = sc.read("s4d8_subset_gex.h5ad")
这个数据集已经经过了标准预处理(scran),这有助于我们更好地识别细胞的亚群状态。
2. 构建KNN图和UMAP嵌入
# 基于前30个主成分构建KNN图
sc.pp.neighbors(adata, n_pcs=30)

# 计算UMAP嵌入用于可视化
sc.tl.umap(adata)
★
neighbors vs clusters
sc.pp.neighbors():构建KNN图,定义细胞之间的邻居关系sc.tl.leiden():在KNN图上运行聚类算法,将细胞分组
前者是聚类的准备工作,后者才是真正的聚类步骤。
3. 运行Leiden聚类
我们可以尝试不同的分辨率参数:
# 默认分辨率(1.0)
sc.tl.leiden(adata)

# 尝试不同的分辨率,并保存到不同的键中
sc.tl.leiden(adata, key_added="leiden_res0_25", resolution=0.25)
sc.tl.leiden(adata, key_added="leiden_res0_5", resolution=0.5)
sc.tl.leiden(adata, key_added="leiden_res1", resolution=1.0)
4. 可视化聚类结果
# 在UMAP上展示不同分辨率的聚类结果
sc.pl.umap(
    adata,
    color=["leiden_res0_25", "leiden_res0_5", "leiden_res1"],
    legend_loc="on data",
)
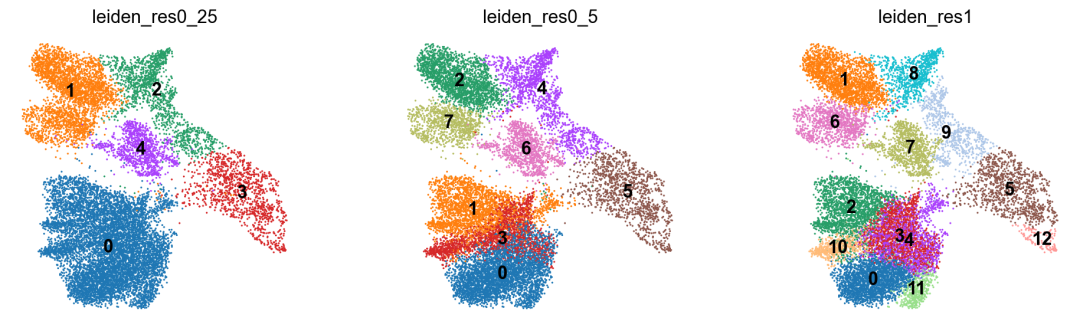
通过可视化,我们可以清楚地看到分辨率参数的影响:
- 分辨率0.25 :聚类较粗糙,识别出的细胞群体较少
- 分辨率0.5 :中等粒度的聚类
- 分辨率1.0 :更精细的聚类,识别出更多的细胞亚群
5. 关于可视化的重要提醒
需要特别注意的是,UMAP图上聚类之间的距离不能过度解读 。由于UMAP将高维数据投射到2D平面,距离信息可能会失真。因此,不要根据UMAP图上的距离来判断不同细胞类型之间的相似性。
亚群分析:深入挖掘
Leiden算法还支持对特定聚类进行亚聚类(sub-clustering) 分析。通过对KNN图进行子集化,我们可以:
- 识别某个细胞类型内的不同状态
- 获得更精细的细胞类型标注
- 发现罕见的细胞亚群
但要注意,过度的亚聚类可能会将噪声识别为有意义的模式。
总结
聚类是识别细胞类型的基础 :通过聚类,我们将相似的细胞分组,为后续的细胞类型注释做准备
Leiden算法是首选 :基于KNN图的Leiden社区检测是当前单细胞聚类的标准方法
分辨率参数很重要 :根据研究目的选择合适的分辨率,较高的分辨率能识别更精细的细胞亚群
谨慎解读可视化结果 :UMAP等二维嵌入中的距离信息可能失真,不要过度解读聚类间的空间关系
亚聚类提供更多细节 :对感兴趣的聚类进行亚聚类分析,可以发现更精细的细胞状态
下一步,我们将学习如何对这些聚类进行生物学注释,赋予它们具体的细胞类型身份。这将帮助我们从"cluster 3"这样的抽象描述,转变为"CD8+ T细胞"这样有生物学意义的标注。
我们公众号之前也发过几篇关于注释的文章哦~请看:我愿称新Azimuth为最强注释工具
大家在实际分析中更倾向于使用哪种分辨率?欢迎在评论区分享你的经验!本章英文原文及完整代码,可以在后台回复scbp10 获取。
----------
单细胞领域大牛编写的最强硬核单细胞教程来啦!想要追更学习笔记,请给我们加个✨,不错过最新推送: