跟着Theis Lab学单细胞: 跨越批次的鸿沟(上)
跟着Theis Lab学单细胞: 跨越批次的鸿沟(上)
单细胞最佳实践
细胞整合(上)
本章导读 SECTION PREVIEW
1. 什么是批次效应,为何它是单细胞分析中几乎绕不开的坎?
2. 数据整合方法千千万,它们背后的核心思路有何异同?
3. 如何巧妙地选择高变基因,避免被批次效应“带偏”?
4. 实战演练:如何使用scVI和scANVI这两个明星工具完成高质量的数据整合?
本节对应原书 12 Integration 12.1-12.6
在单细胞RNA测序的世界里,批次效应(Batch Effect) 是几乎所有分析者都会遇到的核心挑战。当我们希望整合来自不同实验批次、不同供体、甚至不同实验室的数据以获得更全面的生物学洞见时,如何有效去除批次效应,让数据“求同存异”,就成了整个分析的成败关键。本文将系统性地介绍单细胞数据整合的原理、方法与实战。
一、为什么需要数据整合?
简单来说,批次效应是指那些并非源于生物学差异,而是因样本处理方式不同而导致的基因表达量变化 。
举个经典的例子:假设两个实验室分析来自同一批捐赠者的组织样本。A实验室优化了组织解离方案,最大程度地减少了细胞在处理过程中的应激反应;而B实验室则使用了常规方案。那么,即便两种方案处理的细胞在原始组织中的表达谱完全相同,B实验室的数据中很可能也会出现大量应激相关基因(如JUN、FOS等)的异常高表达。
批次效应的来源五花八门,有时难以精确追溯。有些是纯粹的技术差异 ,如样本处理流程、实验试剂、测序深度等;有些则与生物学因素 相关,例如不同的供体、组织区域或采样位置的差异。
★
小编注: 在分析前,区分技术性批次和生物性批次至关重要。我们的目标是去除前者引入的技术性噪音,同时保留后者中我们真正关心的生物学信号。例如,供体间的差异可能是需要校正的批次效应,也可能是研究疾病与健康状态的关键生物学变量。如何界定,取决于你的核心科学问题。
有效地整合数据、去除批次效应,能帮助我们:
- 跨越批次差异的鸿沟,识别出那些原本被噪音掩盖的稀有细胞群。
- 在多个数据集中进行细胞类型的查询和比对分析。
- 回答单个数据集无法解决的宏大问题,例如“在不同个体中,哪些细胞类型会表达新冠病毒(SARS-CoV-2)的入侵因子?”。
如何选择批次校正的层级?
这是数据整合前必须做出的关键决策。我们到底应该以哪个变量(covariate)为“批次”进行校正?是样本(sample)、供体(donor)还是整个数据集(dataset)?
选择的“批次”粒度越精细,被移除的差异就越多,但这也大大增加了误删真实生物学信号的风险。例如,你的样本来自同一位供体的不同组织区域,如果直接以“样本”为批次进行整合,那么不同组织区域间真实的生物学差异也会被一并“校正”掉。在这种情况下,或许以“供体”为批次是更合理的选择,这样既能消除个体间的技术差异,又能保留我们感兴趣的组织位置差异。
二、整合方法的四大家族
绝大多数批次校正方法都遵循相似的逻辑三部曲:
- 降维(Dimensionality Reduction) :将数据投影到低维空间,以增强信噪比。
- 建模与校正(Modeling & Correction):在低维空间中鉴定并移除批次效应。
- 空间映射(Projection) :将校正后的低维数据重新映射回高维的基因表达空间(可选步骤)。
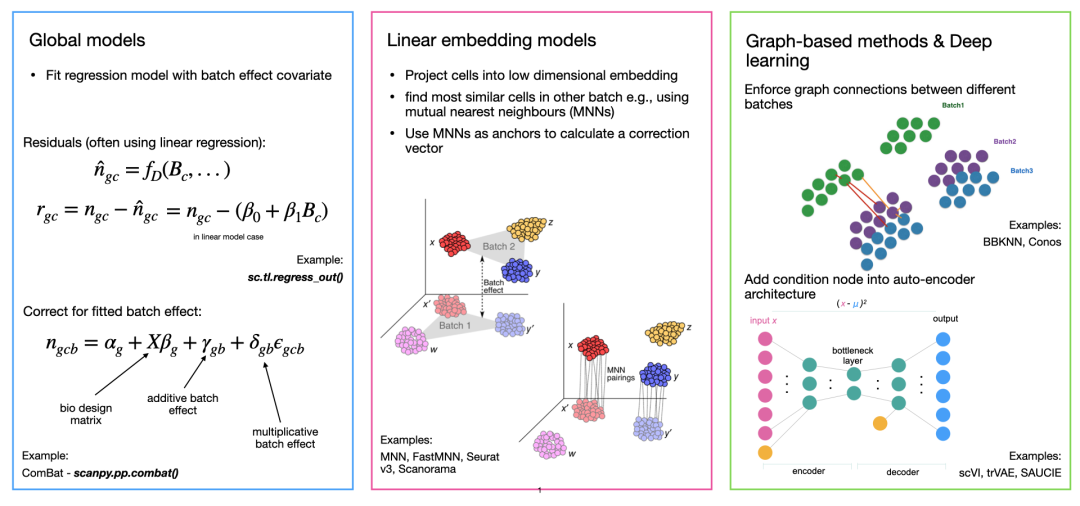 整合方法的大致分类
根据其核心算法的差异,我们可以将主流的整合方法划分为四大类:
- 全局模型(Global Models) :这类方法起源于处理芯片和Bulk转录组数据,它们假设批次效应在所有细胞上是基本一致的(例如,整体加上或乘上某个值)。经典代表是ComBat 。
- 线性嵌入模型(Linear Embedding Models) :这是第一代为单细胞数据量身定制的方法。它们通常先通过SVD(奇异值分解)等方法对数据进行降维嵌入,然后在嵌入空间中寻找不同批次间“相互最近的邻居细胞对”(Mutual Nearest Neighbors, MNNs),并将这些细胞对作为“锚点”,计算出局部化的校正向量。这是目前最庞大的一族,代表有MNN、Seurat v3、Harmony、Scanorama 等。
- 基于图的方法(Graph-based Methods) :这类方法通常运算速度最快。它们的核心思想是,在构建细胞近邻图(k-Nearest Neighbor, kNN)时,强制在不同批次的细胞之间建立连接,从而将不同批次“编织”在一起。最知名的代表是BBKNN 。
- 深度学习模型(Deep Learning Models) :这是最新、最复杂的整合方法,通常在处理大规模、复杂数据集时表现优异。它们大多基于自编码器(Autoencoder)框架,通过在模型中加入“批次”这个条件变量,让模型在学习数据结构时忽略批次信息,从而在低维的隐空间(latent space)中消除批次效应。代表方法有scVI、scANVI、scGen 等。
三、实战演练
数据准备与预处理
在本教程中,我们将使用一份人骨髓单核细胞的10x Multiome公开数据集进行演示。该数据集包含多个批次,我们选取其中的3个批次,共计10,270个细胞用于后续分析。
import scanpy as sc
import scvi
import numpy as np
import pandas as pd

# 下载数据 (terminal)
# wget "https://figshare.com/ndownloader/files/45452260" -O openproblems_bmmc_multiome_genes_filtered.h5ad

# 读取数据
adata = sc.read_h5ad("openproblems_bmmc_multiome_genes_filtered.h5ad")

label_key = "cell_type" # 细胞类型
batch_key = "batch"      # 批次信息

# 筛选本次分析要用的三个批次
keep_batches = ["s1d3", "s2d1", "s3d7"]
adata = adata[adata.obs[batch_key].isin(keep_batches)].copy()

# 本教程只关注基因表达(GEX),过滤掉ATAC等其他模态的特征
adata = adata[:, adata.var["feature_types"] == "GEX"].copy()

# 过滤掉在所有细胞中都不表达的基因
sc.pp.filter_genes(adata, min_cells=1)

# 将原始计数矩阵(counts)放回adata.X,这是后续很多整合方法(特别是scVI)的推荐输入
adata.X = adata.layers["counts"].copy()

# 重新进行标准化和对数化,用于后续可视化和部分非计数模型
sc.pp.normalize_total(adata)
sc.pp.log1p(adata)
检查未整合数据
在动手整合之前,我们必须先直观地看一看原始数据中的批次效应有多严重。
# 标准预处理流程
sc.pp.highly_variable_genes(adata)
sc.tl.pca(adata)
sc.pp.neighbors(adata)
sc.tl.umap(adata)

# 在UMAP图上按细胞类型和批次进行双重着色
sc.pl.umap(
    adata,
    color=[label_key, batch_key],
    wspace=0.5 # 调整子图间距
)
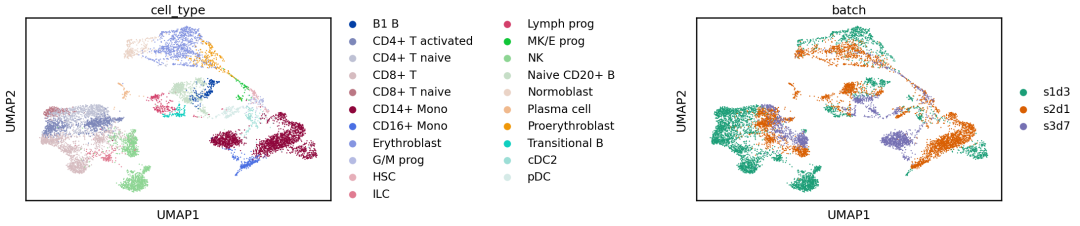 未整合的数据呈现明显批次效应
从UMAP图上可以清晰地看到,尽管某些细胞类型(如HSC)在不同批次间有所重叠,但大部分细胞还是依据其来源批次(batch)明显地分隔开,而不是按照它们的生物学身份(cell_type)聚集成纯净的细胞簇。这就是需要进行批次校正的典型信号。
批次感知的特征选择(Batch-aware HVG Selection)
在进行降维和整合前,我们需要挑选信息量最大的基因,即高变基因(Highly Variable Genes, HVGs)。但在含有多个批次的数据中,传统的HVG选择方法可能会犯一个错误:它可能会把那些因批次效应而“假性”高变的基因(例如,只在某个批次中被激活的应激基因)误选进来。
更稳健的做法是采用批次感知的HVG选择 :
- 在每一个批次内部 独立计算HVGs。
- 选择那些在尽可能多的批次中 都被鉴定为高变的基因作为最终的基因集。
Scanpy的highly_variable_genes函数通过设定batch_key参数,可以轻松实现这一点。
sc.pp.highly_variable_genes(
    adata,
    n_top_genes=2000,
    flavor="cell_ranger", # 经典的HVG计算方法
    batch_key=batch_key   # 关键参数!
)

# 创建一个只包含高变基因的AnnData对象,用于后续整合分析
adata_hvg = adata[:, adata.var["highly_variable"]].copy()
★
小编注: 该选择多少HVGs?scvi-tools的开发者建议选择1000到10000个基因。选得太少,可能会丢失定义稀有细胞群的关键Marker基因;选得太多,则会显著增加计算负担。一个比较保险的策略是,宁可多选一些(如3000-5000个),也不要选得太少。
基于变分自编码器(VAE)的整合:scVI
scVI (single-cell Variational Inference)是当前最流行的深度学习整合方法之一。它基于一个条件变分自编码器(CVAE) 。其核心思想是,在对基因的原始表达计数(raw counts)进行建模时,将“批次信息”作为一个已知的条件(condition)输入到模型中。这样,模型在降维(从高维基因空间压缩到低维隐空间)的过程中,就会学会“忽略”批次信息,使得最终得到的低维嵌入(latent representation)不再受批次效应的影响。
1. 准备scVI所需数据
scVI有其标准的数据设置流程,通过setup_anndata函数完成。这一步会告诉模型在哪里找到需要的数据(如原始计数)和需要校正的批次变量。
adata_scvi = adata_hvg.copy()

# 设置scVI模型
scvi.model.SCVI.setup_anndata(
    adata_scvi,
    layer="counts",  # 明确指定使用原始计数矩阵
    batch_key=batch_key
)
2. 构建与训练模型
 # 创建scVI模型实例
model_scvi = scvi.model.SCVI(adata_scvi)

# 训练模型
# 教程中给出了一个动态设定训练轮数(epochs)的方法,以适应不同大小的数据集
# 基本思想是:总训练迭代次数约为20000*400,再除以细胞数得到epoch
max_epochs = np.min([round((20000 / adata.n_obs) * 400), 400])
model_scvi.train(max_epochs=max_epochs)

# 训练完成后,从模型中提取整合后的低维嵌入
adata_scvi.obsm["X_scVI"] = model_scvi.get_latent_representation()
3. 可视化整合结果
现在,我们基于整合后的X_scVI嵌入重新计算邻居图和UMAP。
# 使用整合后的嵌入(X_scVI)计算kNN图
sc.pp.neighbors(adata_scvi, use_rep="X_scVI")
sc.tl.umap(adata_scvi)

# 再次可视化
sc.pl.umap(
    adata_scvi,
    color=[label_key, batch_key],
    wspace=0.5,
    title=["Cell Type (scVI integrated)", "Batch (scVI integrated)"]
)
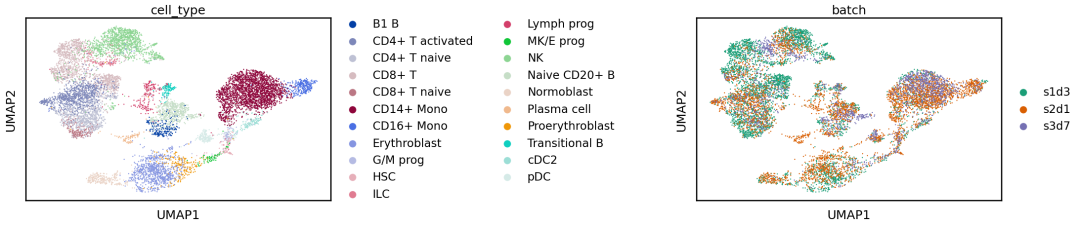 scVI整合后的数据
可以看到,经过scVI整合后,UMAP图上的批次效应基本消失,来自不同批次的细胞得到了良好的混合,而原先因批次分隔的相同细胞类型(如CD4 T)也成功地聚合在了一起。
利用细胞标签信息进一步优化:scANVI
如果我们已经拥有部分(甚至全部)细胞的类型标签,就可以使用scANVI (single-cell ANnotation using Variational Inference) 来实现更高质量的整合。scANVI是scVI的一个扩展模型。它在scVI的基础上,额外利用细胞标签信息作为监督信号,从而在去除批次效应的同时,能更好地保留定义细胞类型的生物学差异。
训练scANVI模型
scANVI的训练通常是一个微调(fine-tuning) 过程,即在一个已经预训练好的scVI模型基础上继续训练,这样可以大大节约计算时间。
# 基于已训练的scVI模型,创建scANVI模型
model_scanvi = scvi.model.SCANVI.from_scvi_model(
    model_scvi,
    labels_key=label_key,
    unlabeled_category="unlabelled" # 如果有未标注细胞,可以指定一个名称
)

# 训练scANVI模型(通常需要更少的轮数)
max_epochs_scanvi = int(np.min([10, np.max([2, round(max_epochs / 3.0)])]))
model_scanvi.train(max_epochs=max_epochs_scanvi)

# 提取scANVI整合后的嵌入
adata_scanvi = adata_scvi.copy() # 方便对比
adata_scanvi.obsm["X_scANVI"] = model_scanvi.get_latent_representation()

# 可视化
sc.pp.neighbors(adata_scanvi, use_rep="X_scANVI")
sc.tl.umap(adata_scanvi)
sc.pl.umap(adata_scanvi, color=[label_key, batch_key], wspace=1)
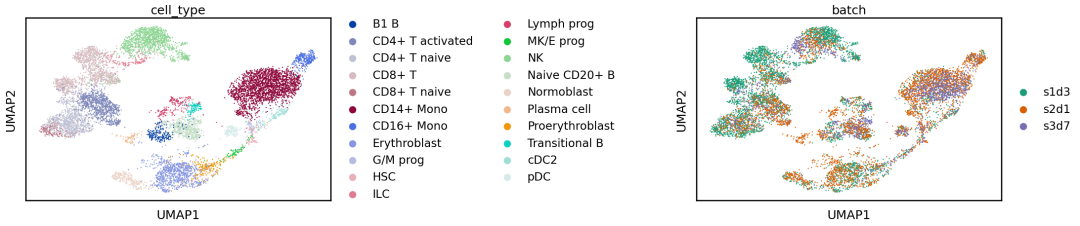 scANVI整合后的数据
大量的基准测试表明,scANVI通常能比scVI更好地保留生物信号,但代价是有时批次校正的效果会略微减弱。值得一提的是,scANVI也支持半监督模式 ,即数据集中只有一部分细胞有可靠标签,这在真实世界的项目中非常实用。
后记
在本篇(上)中,我们探讨了批次效应的来源、数据整合的必要性,并详细介绍了两种基于深度学习的强大整合工具——scVI和scANVI。这类方法在处理复杂、大规模数据集时表现出色,且扩展性好,但缺点是需要较多的计算资源(特别是GPU)。
在下篇中,我们将继续介绍另外两类主流方法——基于图的BBKNN和基于线性嵌入的MNN,并探讨如何量化评估整合效果的好坏。敬请期待!
大家怎么看待去批次?什么工具效果比较好,什么工具容易过拟合?欢迎在评论区分享你的经验!本章英文原文及完整代码,可以在后台回复scbp12 获取。
Bioinfo自习室交流群欢迎各位生信爱好者加入:
----------
单细胞领域大牛编写的最强硬核单细胞教程来啦!想要追更学习笔记,请给我们加个✨,不错过最新推送: