跟着Theis Lab学单细胞: AnnData入门
跟着Theis Lab学单细胞: AnnData入门
单细胞最佳实践
AnnData入门
本章导读 SECTION PREVIEW
1. 了解目前主流的分析系统以及异同
2. 安装AnnData、了解单模态数据的基本结构
3. 掌握AnnData的基础操作
本节对应原书 4.1 Single-cell analysis frameworks and consortia,4.2. Storing unimodal data with AnnData
01
单细胞下游分析
所谓的单细胞“下游”分析,一般指的是从获得计数矩阵 (count matrix) 后开始的探索性分析。然而,由于单细胞数据的特殊性,比如稀疏(矩阵的绝大部分都是0)、数据量大(一般几千到几百万个细胞不等)、信噪比低(存在空液滴、多细胞、环境DNA、Drop-out)等,没有现成的工具可以使用。早期的研究者通常自己写脚本来分析数据,但现在已经有专门为单细胞数据分析设计的框架了。目前最受欢迎的三种选择是基于R语言的Bioconductor和Seurat生态系统,以及基于Python的scverse。这些框架不仅在编程语言上有所不同,其底层的数据结构和配套的分析工具也各有千秋。


• **Bioconductor **是一个致力于开发、支持和分享免费开源软件的项目,专注于对包括单细胞在内的多种生物实验数据进行严谨且可重复的分析。Bioconductor 的最大优势在于其一致的开发者和用户体验,以及配有用户友好的示例文档(vignettes),帮助用户快速上手。
• **Seurat **是一个广受好评的R包,专为单细胞数据分析而设计。它提供了从数据预处理到多模态和空间数据分析的全套工具。Seurat 的出色之处在于其详尽的示例文档和庞大的用户群体。然而,当面对超大规模数据集(如超过50万个细胞)时,R语言的两种选择(Bioconductor 和 Seurat)可能会遇到扩展性问题,这促使了基于Python的社区开发了 scverse 生态系统。
• **scverse **是一个专注于生命科学基础工具的组织和生态系统,最初聚焦于单细胞数据分析。它的优势在于出色的扩展性、灵活性以及与现有Python数据科学和机器学习工具的强大互操作性。


都具备基础分析功能的同时,这些生态系统还在努力实现不同框架之间的“无缝对接”,方便大家根据具体问题灵活选择工具。本书将根据具体问题选择最适合的工具,因此会混合使用上述几种框架,但所有分析的基础都将基于 scverse 生态系统,以保持一致的数据结构和生态链。我们将把讲述重点放在概念本身而不是实现细节上,关于后者读者可以自行查阅官方文档和教程。
02
使用AnnData存储单模态数据
前文提到过,在完成序列比对和基因注释后,基因组数据通常会被汇总成一个特征矩阵(feature matrix)。对于单细胞RNA测序(scRNA-seq)数据来说,这个矩阵的形状是观测数 x 变量数,其中观测值对应细胞条形码(cellular barcodes),变量对应注释的基因,所以通俗来说,特征矩阵也就是细胞 x 基因的矩阵。在分析过程中,我们会为矩阵中的观测值和变量添加一些计算得出的测量值 measurements(比如QC指标或潜在空间嵌入)以及先验知识 prior knowledge(比如样本来源或替代基因标识符)。
在 scverse 生态系统中,AnnData 是用来将数据矩阵与这些注释关联起来的核心工具。为了提高效率,AnnData 支持稀疏矩阵(sparse matrices)和部分读取(partial reading),这样可以更快地处理大规模数据。
AnnData 在功能上与 R 生态系统中的数据结构(比如 Bioconductor 的 SummarizedExperiment 或 Seurat 对象)相似,但 R 包通常使用转置后的特征矩阵(基因 x 细胞)。
Anndata的核心结构
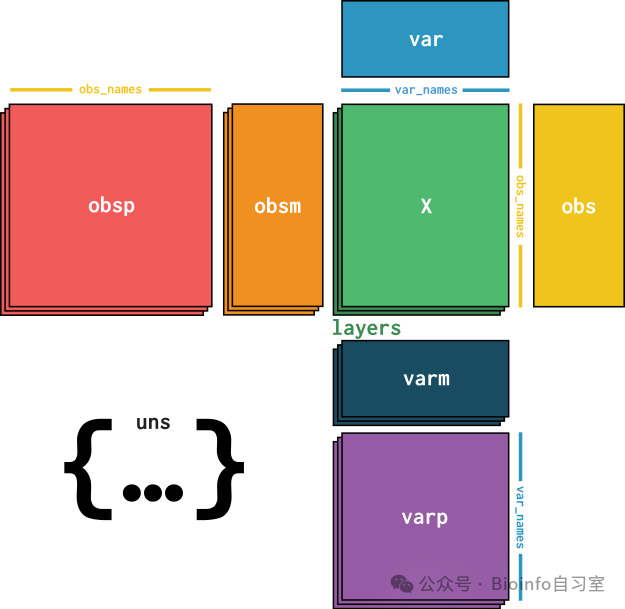 AnnData数据结构图
在 AnnData 的核心中,存储了一个稀疏或密集矩阵(在 scRNA-seq 中就是计数矩阵),称为X。这个矩阵的维度是obs_names x var_names,其中 obs(观测值)对应细胞条形码,var(变量)对应基因标识符。矩阵X被两个Pandas数据框(DataFrame)包围。其中 obs保存细胞的注释信息,var保存基因的注释信息。
AnnData 还可以储存很多额外信息。比如,其他关于观测值和变量的多维数据(如UMAP)储存在obsm和varm中,图结构(比如细胞之间的关系或基因之间的关系)存储在obsp和varp中,任何不适合其他槽位的非结构化数据都可以存储在uns中,还可以通过layers存储矩阵X的额外值。例如,可以在名为counts的层中存储未经标准化的原始计数数据,而在默认的层中存储标准化后的数据。
AnnData 主要设计用于单模态数据(比如只包含 scRNA-seq 数据)。不过,AnnData 的扩展版本(稍后会介绍的 MuData)能够高效地存储和访问多模态数据。
03
AnnData的基础操作
安装
以下方式可以任选其一,安装AnnData的同时也会安装相关的依赖包。
# 使用conda
conda install -c conda-forge anndata
# 使用pip
pip install anndata
初始化
假设我们要存储的是基因表达计数数据(比如 scRNA-seq 数据),可以按照以下步骤创建一个AnnData对象。
首先导入所需的库:
import anndata as ad
import numpy as np
import pandas as pd
from scipy.sparse import csr_matrix
然后,生成一些随机数据来模拟基因表达计数矩阵,并用这些数据初始化一个 AnnData 对象,称为adata。
# 创建稀疏矩阵,模拟基因表达数据
counts = csr_matrix(
    np.random.default_rng().poisson(1, size=(100, 2000)), dtype=np.float32
)
# 初始化 AnnData 对象
adata = ad.AnnData(counts)
adata

AnnData object with n_obs × n_vars = 100 × 2000
这表示我们的数据有 100 个观测值(细胞)和 2000 个变量(基因)。原始数据可以通过adata.X访问:
adata.X

<100x2000 sparse matrix of type '<class 'numpy.float32'>'
    with 126413 stored elements in Compressed Sparse Row format>
为了方便理解,我们可以为细胞和基因添加名称,存储在 .obs_names 和 .var_names 中。
# 为细胞和基因命名
adata.obs_names = [f"Cell_{i}"for i inrange(adata.n_obs)]
adata.var_names = [f"Gene_{i}"for i inrange(adata.n_vars)]

print(adata.obs_names[:10])  # 打印前 10 个细胞的名称

Index(['Cell_0', 'Cell_1', 'Cell_2', 'Cell_3', 'Cell_4', 'Cell_5', 'Cell_6',
       'Cell_7', 'Cell_8', 'Cell_9'],
      dtype='object')
注释信息
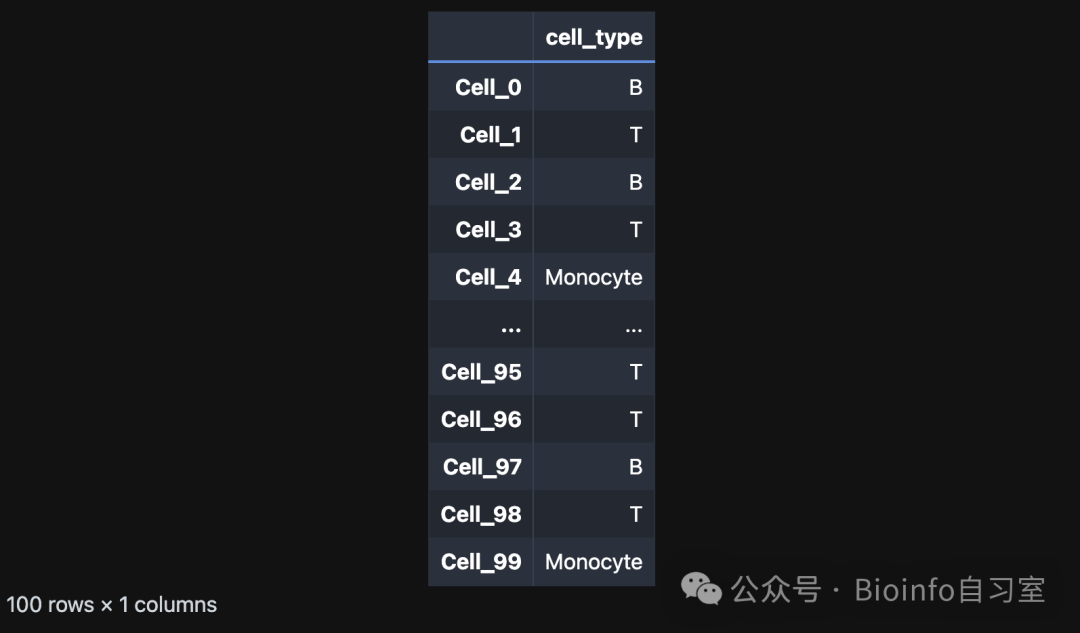
在单细胞数据分析中,细胞和基因通常会有额外的注释信息,比如细胞类型或基因功能。这些信息可以通过 .obs和.var属性添加到 AnnData 对象中。例如,我们可以随机生成一些细胞类型信息,并将其存储到 .obs 中:
# 随机生成细胞类型信息
cell_types = np.random.default_rng().choice(["B", "T", "Monocyte"], size=adata.n_obs)
adata.obs["cell_type"] = pd.Categorical(cell_types)  # 使用分类数据提高效率
# AnnData会自动更新
adata

AnnData object with n_obs × n_vars = 100 × 2000
    obs: 'cell_type'
也可以单独读取.obs:
adata.obs
取子集
我们可以通过注释信息对数据进行筛选。例如,提取所有属于 "B" 细胞的数据:
bdata = adata[adata.obs.cell_type == "B"]
bdata

View of AnnData object with n_obs × n_vars = 26 × 2000
    obs: 'cell_type'
多维数据
有些注释信息可能是多维的,比如 UMAP 嵌入结果或基因级别的元数据。这些信息可以通过.obsm和.varm属性存储。
例如,我们可以随机生成一些 UMAP 嵌入数据并存储到.obsm中:
# 添加 UMAP 嵌入数据
adata.obsm["X_umap"] = np.random.default_rng().normal(0, 1, size=(adata.n_obs, 2))
# 添加基因级别的元数据
adata.varm["gene_stuff"] = np.random.default_rng().normal(0, 1, size=(adata.n_vars, 5))
# 查看umap数据
adata.obsm

AxisArrays with keys: X_umap

# 查看更新的AnnData
adata

AnnData object with n_obs × n_vars = 100 × 2000
    obs: 'cell_type'
    obsm: 'X_umap'
    varm: 'gene_stuff'
关于.obsm和.varm还有两个小问题要注意:1. 这两个槽位用于存储阵列格式的元数据,可以是Pandas数据框、scipy的稀疏矩阵或者numpy的密集阵列。2. 使用scanpy时,这两个槽位的数据不方便被调取画图。需要画图的数据建议保存在.obs槽位里。
非结构化数据
对于不适合其他槽位的未结构化数据,可以使用.uns属性存储。这个槽位没有格式上的要求,可以是任意信息,比如实验设计、试剂版本等等。但如果该信息可以用其他槽位存储,就尽量不要使用这个槽位。我们来试试:
adata.uns["random"] = [1, 2, 3]
adata.uns

# 会以dictionary形式存储
OverloadedDict, wrapping:
    OrderedDict([('random', [1, 2, 3])])
With overloaded keys:
    ['neighbors'].
数据层
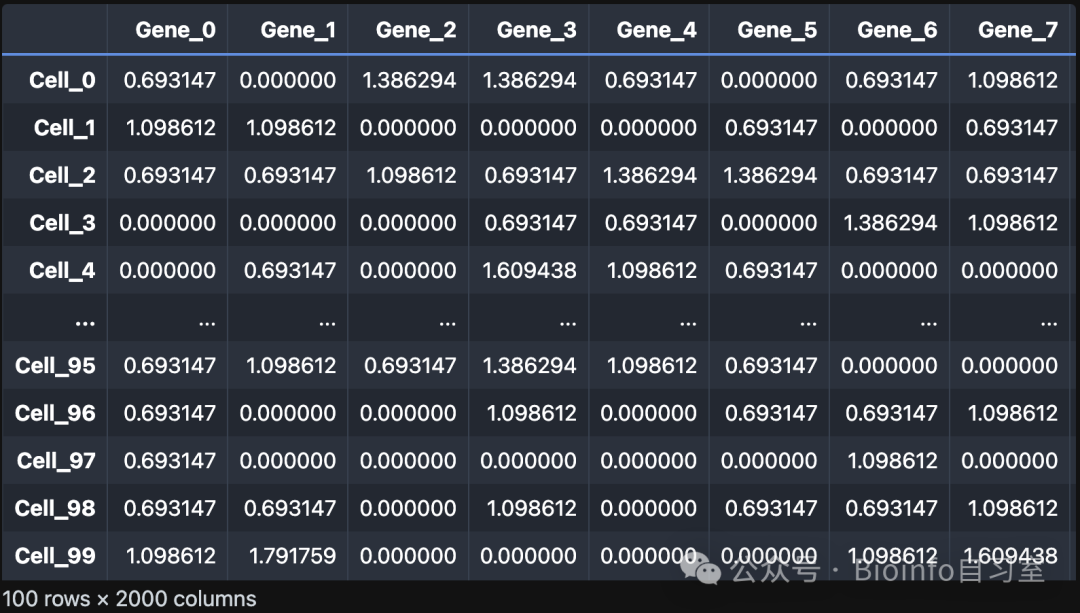
如果我们有不同形式的核心数据(比如原始数据和标准化后的数据),可以将它们存储在不同的层(layers)中。例如,我们可以对原始数据进行对数变换并存储到一个新的层中:
adata.layers["log_transformed"] = np.log1p(adata.X)
adata

AnnData object with n_obs × n_vars = 100 × 2000
    obs: 'cell_type'
    uns: 'random'
    obsm: 'X_umap'
    varm: 'gene_stuff'
    layers: 'log_transformed'
写入新的数据层并不会更改原始数据。让我们确认一下:
#对比X和log_transformed层
(adata.X != adata.layers["log_transformed"]).nnz == 0
# False
也可以将某层的数据导出到Pandas数据框,如下:
adata.to_df(layer="log_transformed")
读写
AnnData 对象一般保存为.h5ad文件,这是hdf5文件的一种,特点是保留了层级数据结构,同时支持压缩、占用空间少,使得磁盘上和加载到内存中的数据结构相似,从而实现高效的读写。我们试试看保存刚才的AnnData对象:
# 写入h5ad文件
adata.write("my_results.h5ad", compression="gzip")
# 查看磁盘上的数据结构
!h5ls 'my_results.h5ad'

X                        Group
layers                   Group
obs                      Group
obsm                     Group
uns                      Group
var                      Group
varm                     Group
...然后重新读取数据:
adata_new = ad.read_h5ad("my_results.h5ad")
adata_new

AnnData object with n_obs × n_vars = 100 × 2000
    obs: 'cell_type'
    uns: 'random'
    obsm: 'X_umap'
    varm: 'gene_stuff'
    layers: 'log_transformed'
数据视图与副本
为了更好地理解 AnnData 的数据访问机制,我们来看一个关于元数据的实际应用场景。假设我们的观测数据来自多个仪器,这些仪器在多年的研究中记录了 10 个读数,并且样本是从不同地点的不同受试者身上采集的。通常情况下,我们会以某种格式获取这些信息,并将其存储在一个 Pandas DataFrame 中:
obs_meta = pd.DataFrame(
    {
        "time_yr": np.random.default_rng().choice([0, 2, 4, 8], adata.n_obs),
        "subject_id": np.random.default_rng().choice(
            ["subject 1", "subject 2", "subject 4", "subject 8"], adata.n_obs
        ),
        "instrument_type": np.random.default_rng().choice(
            ["type a", "type b"], adata.n_obs
        ),
        "site": np.random.default_rng().choice(["site x", "site y"], adata.n_obs),
    },
    index=adata.obs.index,  # 这些是与之前相同的 ID
)
接下来,我们将这些元数据与原始数据结合,形成一个完整的数据容器:
adata = ad.AnnData(adata.X, obs=obs_meta, var=adata.var)
adata

AnnData object with n_obs × n_vars = 100 × 2000
    obs: 'time_yr', 'subject_id', 'instrument_type', 'site'
AnnData 对象的行为类似于 NumPy 数组:它可以存储实际数据 ,也可以引用另一个 AnnData 对象 (称为“视图”)。当我们对 AnnData 对象进行切片操作时,返回的结果是一个视图(view) ,而不是数据的副本(copy) (这也是Python跟R的重大区别之一,R在执行此操作时,会创建一个新的对象)。视图有两个优点:
- 1. 不会分配新的内存;
- 2. 可以直接修改底层的 AnnData 对象。
如果需要获得一个包含实际数据的 AnnData 对象,可以通过调用.copy()方法将视图转换为独立的对象。不过,通常情况下这并不是必需的,因为对视图中的元素进行修改时,内部会自动调用.copy()方法。
# 获取前 5 个细胞和指定基因的视图
adata_view = adata[:5, ["Gene_1", "Gene_3"]]
adata_view

View of AnnData object with n_obs × n_vars = 5 × 2
    obs: 'time_yr', 'subject_id', 'instrument_type', 'site'
我们检查原始的adata,会发现数据维度并未发生变化。
adata

AnnData object with n_obs × n_vars = 100 × 2000
    obs: 'time_yr', 'subject_id', 'instrument_type', 'site'
如果我们希望创建一个包含实际数据的 AnnData 对象,则需要调用.copy()方法:
adata_subset = adata[:5, ["Gene_1", "Gene_3"]].copy()
对于视图,我们还可以修改其中的部分数据。例如,将某一列的前 3 个元素设置为 0:
print(adata[:3, "Gene_1"].X.toarray().tolist())
adata[:3, "Gene_1"].X = [0, 0, 0]
print(adata[:3, "Gene_1"].X.toarray().tolist())

[[0.0], [2.0], [1.0]]
[[0.0], [0.0], [0.0]]
但是,当我们尝试修改/读取视图的一部分时,内容会被自动复制,并生成一个新的数据存储对象,而不再是视图了。
adata_subset = adata[:3, ["Gene_1", "Gene_2"]]
adata_subset

View of AnnData object with n_obs × n_vars = 3 × 2
    obs: 'time_yr', 'subject_id', 'instrument_type', 'site'

# 尝试修改view的一部分
adata_subset.obs["foo"] = range(3)
# adata_subset就会变成实际的数据
adata_subset

Trying to set attribute `.obs` of view, copying.
AnnData object with n_obs × n_vars = 3 × 2
    obs: 'time_yr', 'subject_id', 'instrument_type', 'site', 'foo'
使用Pandas进行灵活切片
我们还可以利用 Pandas 的强大功能,使用序列(sequences)或布尔索引(boolean indices)对数据进行切片。
adata[adata.obs.time_yr.isin([2, 4])].obs.head()

       time_yr subject_id instrument_type   site
Cell_0        4  subject 8          type b  site x
Cell_2        2  subject 2          type b  site y
Cell_3        4  subject 8          type a  site y
Cell_5        2  subject 2          type a  site y
Cell_10       2  subject 8          type b  site x
大文件的部分读取
如果单个.h5ad文件非常大,可以使用“支持模式”(backed mode)或read_elem将数据部分加载到内存中。
adata = ad.read("my_results.h5ad", backed="r")
adata.isbacked  # 检查是否处于支持模式

True
在这种模式下,AnnData 对象会保持与磁盘上文件的连接:
adata.filename

PosixPath('my_results.h5ad')
由于我们是以只读模式使用的,因此不会对文件造成任何损坏。然而,当完成对文件的操作后,还是需要关闭文件连接:
adata.file.close()
04
后记
本期带大家详细了解了python的AnnData对象的结构和基础操作,这些可以说是之后的分析的重中之重,毕竟基础不牢地动山摇。小编本人使用R比较多,整理完也觉得教程中提到的“副本”和“视图”的区别很有意思,感觉是python能高效处理大数据的底层逻辑。当然Seurat也在引进这样的技术,v5.0以后支持的BPCells包依赖的也是这种原理,通过跟磁盘上的文件建立连接,直接在磁盘上读写,省去了加载到内存这一步,可以大大减少资源占用、加快速度。以后有机会也出个教程跟大家详细探讨吧!
下一期我们将调整一下原文顺序,先来了解多模态数据结构MuData以及相关的操作,然后再用简单的例子带大家走一遍scanpy和muon的基础流程。除此之外,原书的“导论”一章中还包括不同生态系统中的转换方法,相信很多读者朋友也对这部分感兴趣。
“导论”部分主要是以简略的方式介绍单细胞技术以及上下游流程。关于下游分析中每一步骤的细节,比如如何选择质控标准、调参;还有高级分析,比如细胞轨迹、通路富集、调控网络等等,还有更加详细的论述。希望系统性学习单细胞分析的朋友不要错过!
本章英文原文、扩展阅读,以及用到的示例数据、完整代码,可以在后台回复scbp04获取。
----------
单细胞领域大牛编写的最强硬核单细胞教程来啦!想要追更学习笔记,请给我们加一个小✨,这样最新的推送才会显示在主页: