跟着Theis Lab学单细胞: 定量那些事儿
跟着Theis Lab学单细胞: 定量那些事儿
Cracking single-cell analysis with Theis Lab
No.05 | 发布日期:2025-01-31 | 预计阅读:10分钟
单细胞最佳实践
条形码、UMI解析和分子定量
本章导读 SECTION PREVIEW
1. 什么是细胞条形码 (Cell Barcode,CB) 和唯一分子标识符 (Unique Molecule Identifier,UMI)?它们有什么作用?
2. 如何正确识别和提取CB和UMI的信息?
3. 如何合并CB和UMI信息和比对结果,得到细胞水平的基因定量?
本节对应原书 3.3 Cell barcode correction,3.4 UMI resolution
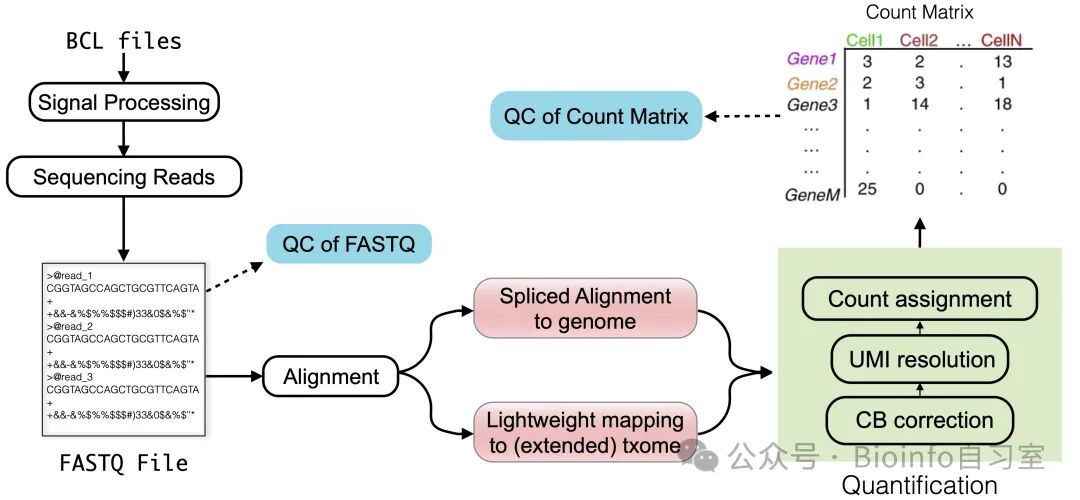 图1. 本章知识概览。本节将讨论右下角“量化”的部分
01
Cell Barcode校正
近年来,基于液滴的单细胞分离技术(如10x Genomics提供的系统)已经成为研究细胞异质性成因及其影响的重要工具。在这种技术中,每个被捕获的细胞的RNA会被封装在一个水基液滴中,同时加入一个带有独特条形码的微珠。这些微珠会为每个细胞的RNA贴上唯一的短核苷酸序列标签,称为细胞条形码(Cell Barcodes, CBs) 。随后,这些条形码会与从RNA逆转录得到的cDNA片段一起被测序。微珠上的条形码具有高度多样性,可以同时标记细胞内的分子内容,并通过计算方法将测序数据拆分到不同的细胞“容器”中进行分析。
比对方向的影响
根据样本的化学处理方式及用户选择的处理选项的不同,并非所有与参考基因组比对的测序片段都会用于定量分析和条形码校正。常用的过滤标准之一是比对方向(alignment orientation):某些实验方案要求比对读数必须源自转录本的特定方向。例如,在10x Genomics 3' Chromium中, 生物学读数应比对到转录本的正链 (forward strand, 然而比对时也会产生反义读数,即anti-sense reads)。因此,研究者可自行决定是否忽略或过滤与底层序列反向互补的比对结果。若实验方案采用此类"链特异性"协议,应予以明确记录。注:bulk RNA-seq双端测序通常是strand-specific且比对到反链(everse-strand)。
条形码校正的关键问题
尽管条形码技术非常强大,但在实际操作中可能会出现一些误差,导致观察到的细胞条形码数量与实际捕获的细胞数量不一致。常见的误差来源包括:
双细胞/多细胞 (doublet/multiplets):有时,一个条形码可能对应两个或多个细胞,这会导致细胞数量被低估。
空液滴(empty droplets):某些液滴中可能没有细胞,但环境中的游离RNA仍会被标记并测序,导致细胞数量被高估。
序列错误(sequence error):在PCR扩增或测序过程中可能会引入错误,进一步影响细胞数量的估算。
为了应对这些问题,科学家开发了许多计算工具来过滤低质量数据并校正条形码错误。例如:
去除背景RNA污染:通过算法识别并去除非特异性RNA信号。
检测双细胞事件:利用统计模型识别可能的双细胞条形码。
校正测序错误:根据条形码序列的相似性修正测序过程中的小错误。
常用的校正策略
- 基于已知列表的校正:
某些技术(如10x Genomics)使用一组预先设计的条形码列表(一般称为“白名单”,whitelist)。如果某个条形码与白名单中的条形码非常接近(比如只有一个碱基不同),就可以认为它是正确的条形码。这种方法虽然高效,但也可能因为条形码之间的相似性而产生歧义。
* 注:实际条形码和已知条形码的相似度实际上是根据汉明距离(Hamming Distance,等长字符串同一位置不同字符的总数)或者编辑距离(Edit Distance/Levenshtein Distance,将一个字符串转换为另一个字符串需要的最小操作数)衡量的。
- 基于“拐点”的方法:
如果没有已知的条形码列表,可以通过绘制条形码频率分布图找到“拐点”,从而区分高质量条形码和低质量条形码。这种方法灵活且适用于多种实验条件,但在某些情况下可能不够稳健。
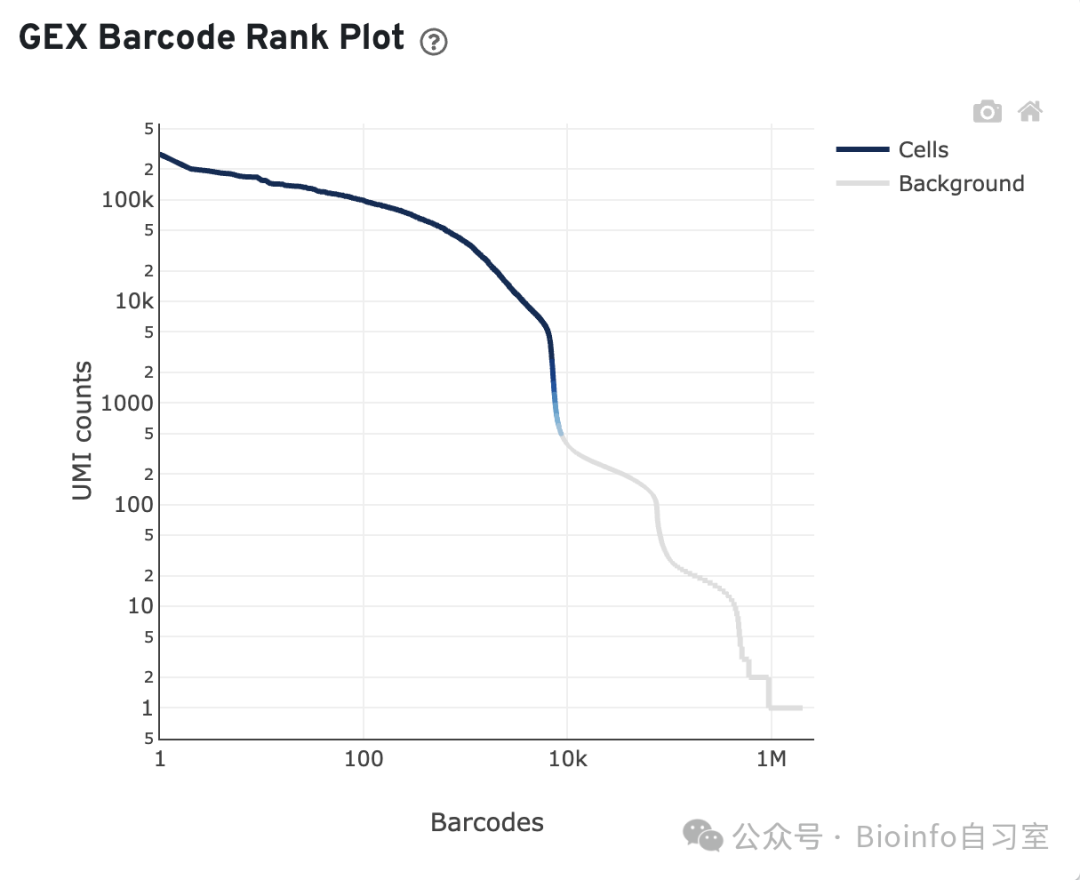
图2.条形码频率分布图示意。cellranger会通过识别“拐点”判断哪些可能是背景
- 基于预期细胞数的过滤:
用户可以提供一个预期的细胞数量,算法会根据条形码的频率排序选择最可能的高质量条形码。
- 强制指定有效条形码数量:
最简单的方法是直接指定一个阈值,高于该阈值的条形码被认为是有效的。然而,这种方法需要用户对实验数据有较好的了解。
如何从观察数据中选择高质量条形码仍是一个热门的研究问题,单细胞和单核实验也会面临不同的复杂情况。此外,随着单细胞测序技术的规模增长,条形码序列的多样性不足可能造成序列校正时条形码的冲突。为解决这些问题,我们将需要更智能的条形码设计方法和更长的核苷酸序列。
02
UMI解析和定量
在完成条形码校正后,接下来的任务是对每个细胞中的基因表达量进行量化。这一过程依赖于唯一分子标识符(Unique Molecular Identifiers, UMIs),它们用于标记每个原始RNA分子,从而帮助我们估算每个基因的真实表达水平。
在理想情况下:
每个read都携带正确的UMI,
同一UMI下的所有read都能唯一比对到同一个基因,
且每个UMI与PCR前的mRNA分子是一一对应的。
在这种情形下,去重工作非常简单:同一UMI的所有reads都是同一原始mRNA分子的PCR重复。因此,一个基因在一个细胞中的分子数可以简单地由不同 UMI 的数量来确定。然而,实际操作中常常遇到以下两个问题,使得简单的去重规则不足以准确反映每个基因的分子数:
- UMI错误:
在PCR扩增或测序过程中,UMI可能会发生突变或读取错误。如果不处理这些错误,可能会高估RNA分子的数量。
- 多映射问题(Multimapping):
某些UMI可能对应多个基因,导致无法确定其来源。简单丢弃这些数据可能会导致信息丢失或偏差。
此外,还有一些其他问题,比如:
收敛碰撞(Convergent Collision):指的是同一个 UMI 被用来标记同一细胞中来自同一基因的两个不同初始分子。通常这种情况较少见,对结果的影响也较小。
发散碰撞(Divergent Collision):指的是同一初始分子在不同位置产生了多个 UMI。这类问题在处理未剪接转录本的内含子时较为常见,目前仍是研究热点。
由于 UMI 在高通量单细胞 RNA 测序中的广泛应用,如何处理上述问题以准确估计基因丰度已经引起了广泛关注,并催生了多种 UMI 分辨率的方法。
图论方法解析UMI
为了应对上述挑战,科学家提出了基于图论(graph-based)的UMI解析方法。这种方法将UMI和它们的映射关系表示为一个“UMI图”,并通过一系列步骤逐步简化这个图,最终得到每个基因的真实分子计数。(注:由于原文包含许多数学细节,这里我们不展开讨论,而是简单概括该方法的主要步骤)
1. 定义节点(Node):
每个节点代表一组具有相同UMI和映射信息的读段。具体来说,如果两个读段的UMI标签相同,并且它们映射到相同的参考序列(如基因组位置或基因),则它们属于同一个节点。如果某个UMI映射到多个基因,则该节点被称为“多基因节点”,需要进一步处理。
2. 定义边(Edge):
如果两个节点的UMI非常相似(比如只有一个碱基不同),就在它们之间画一条边。具体来说,节点之间的边基于UMI序列的相似性和映射信息来定义:
通常使用汉明距离或编辑距离来衡量UMI之间的相似性(详见前文)。如果两个UMI的距离小于某个阈值(例如1),则认为它们可能是来源于同一个RNA分子。
映射交集:如果两个节点的映射信息有交集(即它们映射到至少一个共同的基因),则它们之间会建立一条边。
3. 简化图形:
通过合并相似的节点或删除冗余的边,逐步简化图结构,直到每个节点唯一对应一个原始RNA分子。具体来说,这个过程常用的方法有:
连通分量(Connected Components):将图划分为若干连通分量,每个连通分量代表一个原始RNA分子。
贪婪合并(Greedy Collapsing):逐步合并相似的节点,直到满足特定条件。
树形结构搜索(Arborescence Search):寻找符合规则的子图(如单色树),以减少图的复杂性。
多基因UMI的处理和定量
多基因UMI顾名思义,是指映射到多个基因的UMI。这类UMI的存在会导致基因表达量的不确定性。为了解决这个问题,科学家提出了以下方法:
(1)简单丢弃
最直接的方法是直接丢弃所有多基因UMI。然而,这种方法可能会导致数据丢失,尤其是对于那些容易产生多映射读段的基因家族(如序列相似的基因)。
(2)概率分配
更高级的方法是利用统计模型对多基因UMI进行概率分配。例如期望最大化算法(EM Algorithm)。 EM算法是一种常用的迭代优化方法,用于估计潜在变量的分布。在UMI解析中,EM算法可以用来推断多基因UMI的基因来源。具体步骤如下:
- 初始化每个基因的表达量。
- 根据当前的表达量估计,计算多基因UMI属于每个基因的概率。
- 更新基因的表达量估计。
- 重复上述步骤,直到收敛。
这种方法能够充分利用数据中的信息,避免简单的丢弃策略带来的偏差。由于单细胞数据中每个细胞的信息有限,单独处理可能导致结果不够准确。近年来,研究人员还提出了一些方法来共享信息,使得UMI解析和低丰度基因的定量更为准确。最终,我们得到每个细胞中各个基因的分子计数矩阵,这将作为后续下游分析的原始表达数据。
03
后记
原书超硬核的第三章终于接近尾声了!这一章中由于包含很多非常冗长的细节、数学模型等等,小编做了比较多的简化和改写(但是关键的概念和框架都保留了),希望读者们不会觉得过于晦涩难懂。从下一章开始,我们将进入“下游流程”的范畴,这也是更多研究者关心的内容。在正式开始数据分析之前,书中还将介绍基于Python和scanpy的分析框架和衍生工具,以及在常用分析系统之间的转换(如SingleCellExperiment、Seurat等等)。想要入门scanpy生态的同学可以持续关注!
下篇预告:计数矩阵的质控策略(概述)。敬请期待!
---