跟着Theis Lab学单细胞: 质控到底控什么?
跟着Theis Lab学单细胞: 质控到底控什么?
单细胞最佳实践
质量控制
本章导读 SECTION PREVIEW
1. 了解常见质控指标以及标准,学会画QC图评估数据质量
2. 使用SoupX进行环境RNA污染的去除
3. 使用scDblFinder检测双细胞,了解双细胞检测的原理
本节对应原书 6 Quality Control
单细胞RNA测序数据具有两个重要特性:首先,由于mRNA限制,数据中存在大量零值(dropout现象) ;其次,数据校正和质量控制的能力有限,因为技术问题可能与生物学效应混淆 。因此,我们必须选择适合数据特性的预处理方法,避免过度校正或移除真实的生物学信号。
随着测序技术的发展和细胞捕获数量的增加,单细胞分析工具快速演进。目前已有许多工具专门用于预处理,包括:双细胞检测、质量控制、标准化、特征选择和降维。工具的选择会显著影响下游分析和数据解释。过度过滤可能丢失稀有细胞亚群,而过于宽松则可能影响细胞注释的准确性 。因此,选择经过验证的最佳实践工具至关重要。
在本教程中,我们将用已完成原始处理的单细胞数据(UMI计数矩阵),即维度为条码数×转录本数的矩阵。这里使用"条码"而非"细胞",是因为条码可能标记多个细胞(双细胞)或未标记任何细胞(空液滴)。
01
环境配置、数据准备
我们使用2021年NeurIPS会议单细胞数据整合挑战的10x Multiome数据集。该数据集包含12个健康人类供体的骨髓单核细胞,在四个不同位点测量产生嵌套批次效应。本教程使用供体8,样本4的数据展示预处理的过程(获取示例数据方式见文末)。
import numpy as np
import scanpy as sc
import seaborn as sns
from scipy.stats import median_abs_deviation

sc.settings.verbosity = 0
sc.settings.set_figure_params(dpi=80, facecolor="white", frameon=False)

# 读取数据
adata = sc.read_10x_h5(
    filename="filtered_feature_bc_matrix.h5",
    backup_url="https://figshare.com/ndownloader/files/39546196",
)
加载数据后,scanpy提示变量名称不唯一。我们运行var_names_make_unique()函数,为重复基因名称添加数字后缀。
注: 其他常见处理重复基因的方式:1.仅保留第一个或最大的数值,2.将所有重复基因对应计数相加。每种方式各有优劣,可根据自身需要选择
adata.var_names_make_unique()
该数据集包含16,934个条码和36,601个基因。在列(基因)对应的注释.var中还有genome,gene_ids (ensembl id) 和feature_types的信息。
大多数分析假设每个观测值代表一个完整单细胞,但低质量细胞、游离RNA污染或双细胞可能违反这一假设。因此在下游分析前应进行质量控制。
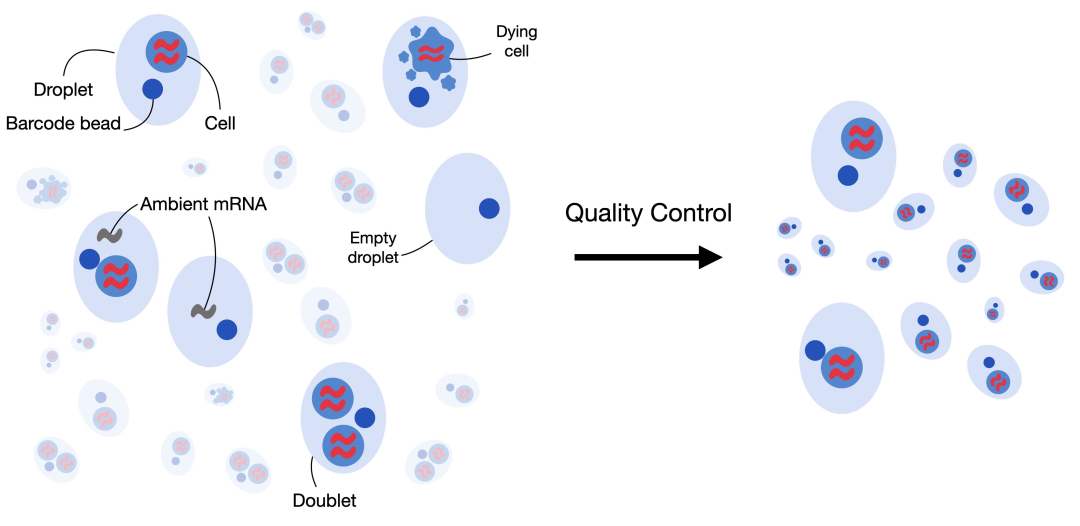 数据中可能存在的噪音,来源:scbp
02
过滤低质量细胞
核心指标
细胞质量控制基于三个关键协变量:
- 1. 每个条码的计数数(计数深度)
- 2. 每个条码的基因数
- 3. 每个条码线粒体基因计数比例
低基因数、低计数深度和高线粒体比例可能表明细胞膜破损,需要过滤。但必须综合考虑这些指标:高线粒体比例的细胞可能参与呼吸过程;低/高计数可能对应静止细胞或大体积细胞。建议采用宽松策略,避免丢失重要亚群。
自动阈值设定
传统上,研究者常手动设定以上指标的阈值,例如500个基因或者10%线粒体基因。虽然大多数情况下固定标准对下游分析影响较小,但在某些疾病或特定组织中该标准并不通用。例如,肿瘤细胞中线粒体基因含量可能普遍偏高、某些不活跃细胞可能表达基因量较少。
此外,由于实验方法和测序平台的不同,测序数据也可能呈现不同的质量。当样本/数据集较多时,人工设定阈值费时费力。
因此,我们推荐使用中位绝对偏差(MAD) 自动设定阈值:
通常一开始使用5个MAD 作为宽松过滤策略。需要指出的是,质控并非一步到位,在后续步骤(如注释阶段)常常需要重新评估质控标准。
adata.var["mt"] = adata.var_names.str.startswith("MT-")  # 线粒体基因
adata.var["ribo"] = adata.var_names.str.startswith(("RPS", "RPL"))  # 核糖体基因
adata.var["hb"] = adata.var_names.str.contains("^HB[^(P)]")  # 血红蛋白基因
计算QC指标:
sc.pp.calculate_qc_metrics(
    adata, qc_vars=["mt", "ribo", "hb"], inplace=True, percent_top=[20], log1p=True
)
关键输出指标:
- • n_genes_by_counts:细胞中正计数基因数
- • total_counts:细胞总计数(文库大小)
- • pct_counts_mt:线粒体计数比例
质控图
绘制三个QC变量n_genes_by_counts、total_counts和pct_counts_mt。
p1 = sns.displot(adata.obs["total_counts"], bins=100, kde=False)
# sc.pl.violin(adata, 'total_counts')
p2 = sc.pl.violin(adata, "pct_counts_mt")
p3 = sc.pl.scatter(adata, "total_counts", "n_genes_by_counts", color="pct_counts_mt")
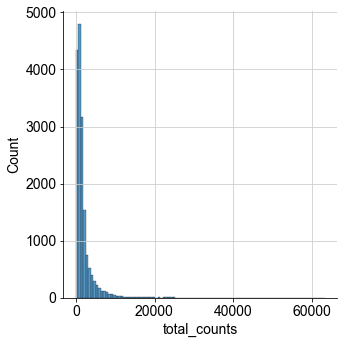
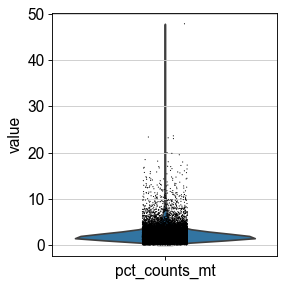
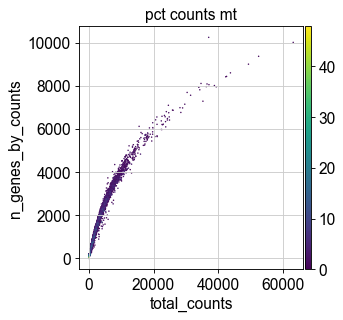
图上可以看到,某些细胞具有相对较高的线粒体计数百分比(通常与细胞降解相关),但大多数细胞的线粒体读数百分比低于20%(20%是经验性标准)。接下来,我们进行基于MAD的自动过滤:
# 定义过滤函数
def is_outlier(adata, metric: str, nmads: int):
    M = adata.obs[metric]
    outlier = (M < np.median(M) - nmads * median_abs_deviation(M)) | (
        np.median(M) + nmads * median_abs_deviation(M) < M
    )
    return outlier

# 应用5个MAD阈值
adata.obs["outlier"] = (
    is_outlier(adata, "log1p_total_counts", 5)
    | is_outlier(adata, "log1p_n_genes_by_counts", 5)
    | is_outlier(adata, "pct_counts_in_top_20_genes", 5)
)

# 线粒体基因使用3个MAD,并额外设置8%的硬阈值
adata.obs["mt_outlier"] = is_outlier(adata, "pct_counts_mt", 3) | (
    adata.obs["pct_counts_mt"] > 8
)

#检查过滤前后细胞数目
print(f"Total number of cells: {adata.n_obs}")
adata = adata[(~adata.obs.outlier) & (~adata.obs.mt_outlier)].copy()

print(f"Number of cells after filtering of low quality cells: {adata.n_obs}")
# Total number of cells: 16934
# Number of cells after filtering of low quality cells: 14814
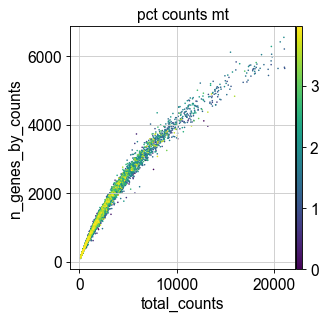
质控后检查:
p1 = sc.pl.scatter(adata, "total_counts", "n_genes_by_counts", color="pct_counts_mt")
03
去除环境DNA
液滴技术中存在环境RNA(ambient RNA)污染,这些来自细胞裂解的游离mRNA会与细胞内mRNA一起被测序,形成所谓的"汤"(soup)。
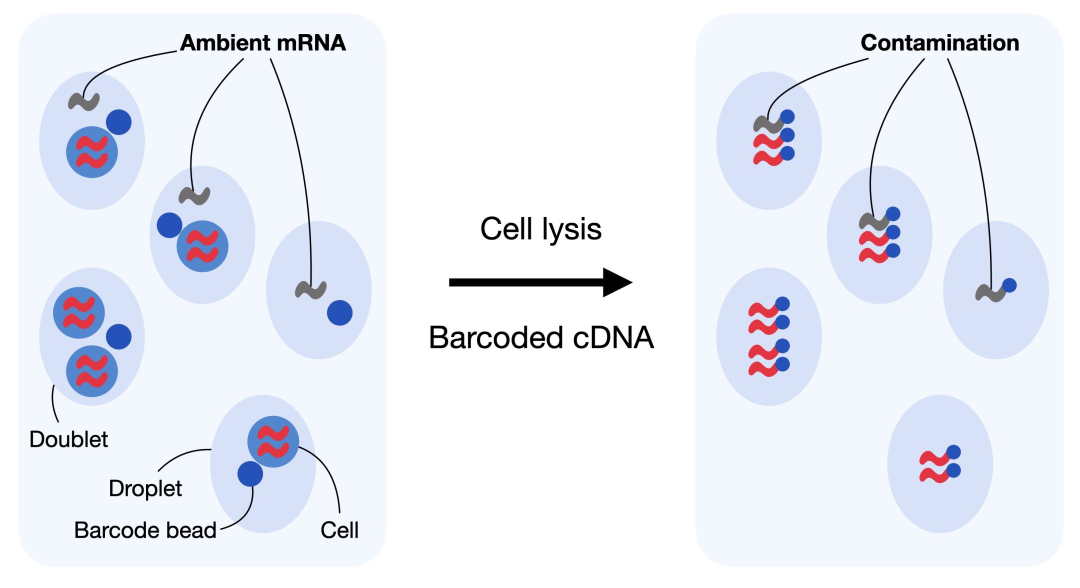 环境DNA污染,来源:scbp
SoupX校正方法
SoupX是目前主流的环境RNA校正工具,其工作原理包括三个步骤:
- 1. 估算汤的组成: 从空液滴中估计环境mRNA表达谱
- 2. 计算污染比例: 估计每个细胞特异性的污染分数
- 3. 校正表达矩阵: 根据环境RNA表达谱和估计的污染情况校正计数矩阵
先加载必要的库:
import logging

import anndata2ri
import rpy2.rinterface_lib.callbacks as rcb
import rpy2.robjects as ro

rcb.logger.setLevel(logging.ERROR)
ro.pandas2ri.activate()
anndata2ri.activate()

%load_ext rpy2.ipython

%%R
library(SoupX)
SoupX可以在没有聚类信息的情况下运行,但如果提供基本聚类,结果会更好。SoupX可以与cellranger产生的默认聚类一起使用,或通过手动定义聚类。
进行简单的PCA和leiden聚类:
# 创建副本
adata_pp = adata.copy()
# 标准化
sc.pp.normalize_per_cell(adata_pp)
sc.pp.log1p(adata_pp)
# pca,邻域,降维
sc.pp.pca(adata_pp)
sc.pp.neighbors(adata_pp)
sc.tl.leiden(adata_pp, key_added="soupx_groups")

# 将聚类结果导出为向量
soupx_groups = adata_pp.obs["soupx_groups"]
# 可以删除副本以节省内存
del adata_pp

# 再分别导出细胞名称、基因名称和过滤后的特征 × 条码矩阵(需要转置!)
cells = adata.obs_names
genes = adata.var_names
data = adata.X.T
除了我们一般用于分析的计数矩阵,filtered_feature_bc_matrix,SoupX还需要原始的、未经过滤的cellranger矩阵,即raw_feature_bc_matrix。后者含有空液滴的信息,能帮助SoupX计算噪音。
adata_raw = sc.read_10x_h5(
    filename="raw_feature_bc_matrix.h5",
    backup_url="https://figshare.com/ndownloader/files/39546217",
)
adata_raw.var_names_make_unique()
# 导出未过滤矩阵
data_tod = adata_raw.X.T
# 可以删掉了
del adata_raw
接下来运行SoupX:
%%R -i data -i data_tod -i genes -i cells -i soupx_groups -o out
# 指定数据的行和列名称
rownames(data) = genes
colnames(data) = cells
# 确保计数表和液滴表的正确稀疏格式
data <- as(data, "sparseMatrix")
data_tod <- as(data_tod, "sparseMatrix")

# 为SoupX生成SoupChannel对象
sc = SoupChannel(data_tod, data, calcSoupProfile = FALSE)

# 向SoupChannel对象添加额外元数据
soupProf = data.frame(row.names = rownames(data), est = rowSums(data)/sum(data), counts = rowSums(data))
sc = setSoupProfile(sc, soupProf)
# 在SoupChannel中设置聚类信息
sc = setClusters(sc, soupx_groups)

# 估计污染分数
sc  = autoEstCont(sc, doPlot=FALSE)
# 推断校正的计数表并舍入为整数
out = adjustCounts(sc, roundToInt = TRUE)
将校正后的矩阵导入AnnData:
adata.layers["counts"] = adata.X
adata.layers["soupX_counts"] = out.T
adata.X = adata.layers["soupX_counts"]
再过滤掉在至少20个细胞中未检测到的基因,因为这些基因不提供有用信息。
print(f"总基因数: {adata.n_vars}")

# 最少20个细胞 - 过滤掉0计数基因
sc.pp.filter_genes(adata, min_cells=20)
print(f"细胞过滤后的基因数: {adata.n_vars}")
# Total number of genes: 36601
# Number of genes after cell filter: 20171
04
去除双细胞
双细胞的类型
双细胞定义为在同一细胞条码下测序的两个细胞,例如,如果它们在同一液滴中被捕获。如果双细胞由相同细胞类型(但来自不同个体)形成,则称为同型,否则称为异型。
同型双细胞不一定可从计数矩阵中识别,但通常被认为是无害的,因为它们可以通过细胞hash或SNPs识别。因此,它们的识别不是双细胞检测方法的主要目标。
由不同细胞类型或状态形成的双细胞称为异型。它们的识别至关重要,因为它们很可能被错误分类,影响下游分析的准确性,因此需要在预处理数据时去除双细胞。
双细胞可以通过其高读数数量和检测特征来识别,或创建人工双细胞,并将这些与数据集中存在的细胞进行比较。本教程将展示R包scDblFinder的使用方法,其在基准测试中实现了最高的双细胞检测准确性以及良好的计算效率和稳定性(Xi and Li, 2021)。
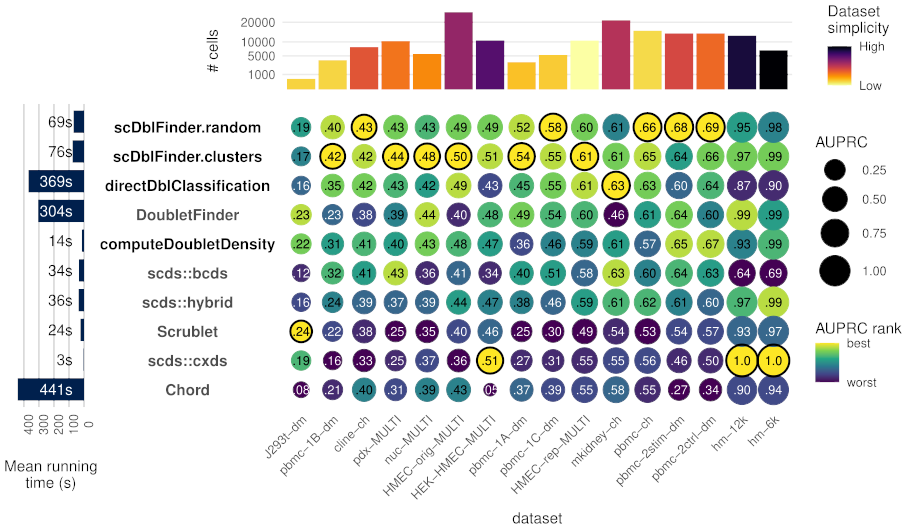 基准测试结果,Xi and Li, 2021
scDblFinder
scDblFinder通过以下步骤检测双细胞:
- 1. 随机选择两个液滴,通过平均它们的基因表达谱创建人工双细胞
- 2. 在PCA中计算每个液滴的k近邻图
- 3. 双细胞得分定义为k近邻图中人工双细胞的比例
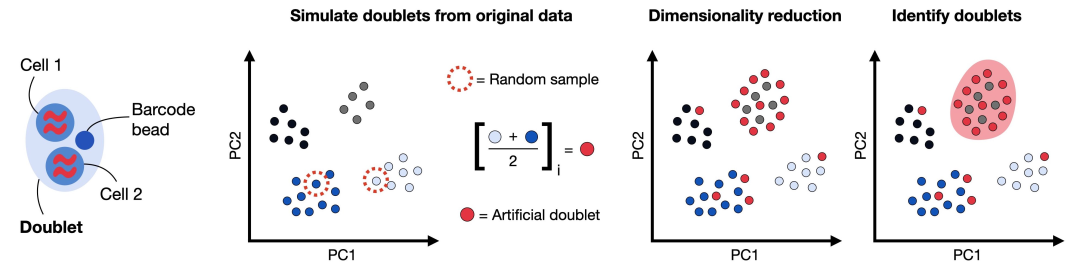 scDblFinder工作原理,来源:scbp
%%R
library(Seurat)
library(scater)
library(scDblFinder)
library(BiocParallel)

# 导出表达矩阵
data_mat = adata.X.T
scDblFinder的输入输出都是SingleCellExperiment对象,双细胞相关结果保存在元数据中:
•
sce$scDblFinder.score:最终双细胞得分(越高越可能是双细胞)•
sce$scDblFinder.ratio:细胞邻域中人工双细胞的比率•
sce$scDblFinder.class:分类(双细胞或单细胞)%%R -i data_mat -o doublet_score -o doublet_class
set.seed(123)
sce = scDblFinder(
SingleCellExperiment(
list(counts=data_mat),
)
)导出打分和分类结果
doublet_score = sce$scDblFinder.score
doublet_class = sce$scDblFinder.class
将结果添加到anndata:
adata.obs["scDblFinder_score"] = doublet_score
adata.obs["scDblFinder_class"] = doublet_class
adata.obs.scDblFinder_class.value_counts()
# singlet    11956
# doublet     2858
# Name: scDblFinder_class, dtype: int64

# 保存质控后数据
adata.write("s4d8_quality_control.h5ad")
建议暂时保留检测到的双细胞,在可视化阶段进一步评估。
05
后记
终于到了质控环节,大家学会质控的步骤和顺序了吗?小编给大家总结一下要点:
1. 质量控制是单细胞分析的基础步骤,正确的策略既能确保数据质量,又能保留重要的生物学信息。在后续聚类分析中,可根据结果重新评估和调整过滤参数。
2. 初步过滤应该使用MAD方法,设定宽松的阈值,避免偏向小亚群。重要程度:对细胞的过滤>对基因的过滤
3. 基本顺序是:低质量细胞-->环境DNA-->双细胞。双细胞过滤不一定一步到位,可以多次降维聚类评估效果。
本章英文原文及完整代码,可以在后台回复scbp06获取。
----------
单细胞领域大牛编写的最强硬核单细胞教程来啦!想要追更学习笔记,请给我们加一个小✨,这样最新的推送才会显示在主页: