跟着Theis Lab学单细胞: 细胞的“命运”轨迹
跟着Theis Lab学单细胞: 细胞的“命运”轨迹
单细胞最佳实践
拟时序
本章导读 SECTION PREVIEW
1. 什么是“拟时”?它是如何从看似杂乱的“快照”中被构建出来的?
2. 图方法、概率法... 各种轨迹推断(TI)算法背后的逻辑有何不同?
3. 根细胞 (Root Cell) :为什么说“选对起点”是拟时序分析中最关键的一步?
4. 实战演练:DPT 和 Palantir 都是著名工具,我们该如何比较并选择更可靠的拟时结果?
本节对应原书 13 Pseudotemporal ordering
单细胞测序技术(如scRNA-seq)为我们提供了前所未有的高分辨率来测量生物组织。因此,这些技术能帮助我们“解密”和理解细胞的异质性 以及生物过程的动态变化。
然而,经典的scRNA-seq方案在测序时会破坏细胞,这使得我们无法追踪同一个细胞(例如,它的基因表达谱)随时间的变化。尽管近期的技术进步(如Live-seq)允许我们连续记录转录组,但它们在实验上仍具挑战性,且目前难以扩展到大数据集。
因此,我们必须转而从测序获得的“快照”数据中,推断 出潜在的动态过程。
什么是Pseudotime?
你可能会问:既然是“快照”,那不就是一个时间点吗?如何推断“动态”?
这里的关键在于生物过程的异步性 (asynchronous nature)。即使样品是在同一个实验时间点获取的,我们也能观察到多种细胞类型。这是因为细胞的发育并不同步,因此一个“快照”样品里其实包含了发育过程中的一系列不同阶段的细胞(例如,从干细胞到祖细胞,再到成熟的终末细胞)。
轨迹推断 (Trajectory Inference, TI)领域的目标就是重建这个发育“景观”。它通过将观察到的细胞状态按照发育过程进行排序来实现这一目标。
这个过程会将离散的细胞注释(如“干细胞”、“祖细胞”)映射到一个连续的域上,这个连续的值就叫做拟时序(Pseudotime) 。
- 拟时序根据细胞在发育过程中的相对阶段 对其进行排序。
- 不成熟的细胞会被赋予较小的拟时序值,而成熟的细胞则被赋予较大的值。
- 例如,在研究骨髓样本时,造血干细胞(HSC)会被赋予较低的拟时序,而红细胞(Erythroid cells)则会被赋予较高的拟时序。
- 在scRNA-seq数据中,这个排序是基于细胞的转录组谱。
- 至关重要的一点是 :构建拟时序通常需要我们指定一个初始细胞 或根细胞 (root cell),即整个过程的起点。
拟时序是如何构建的?
拟时序的构建通常遵循一个通用流程:
- 降维 :首先,将超高维的单细胞数据投影到一个低维表示上。这是因为动态过程通常在一个低维流形(low-dimensional manifold)上进行。降维方法可能依赖于主成分(PCA,例如Palantir)或扩散成分(Diffusion Components,例如DPT)。
- 构建轨迹 :在低维空间中,通过以下几种主要策略之一来构建拟时序。
1. 聚类法 (Cluster approach)
首先对细胞进行聚类,然后识别这些聚类之间的连接。通过对聚类进行排序,就可以构建出一个拟时序。这其中可能会用到最小生成树(MST)来连接聚类。
2. 图方法 (Graph approach)
首先在细胞的低维表示之间找到连接,定义一个图(Graph)。基于这个图来定义聚类和顺序。例如,PAGA 会将图划分为Leiden聚类,并估计它们之间的连接。这种方法能保留数据的全局拓扑结构,并且计算效率高。
3. 流形学习法 (Manifold-learning)
与聚类法类似,但它使用主曲线(Principal curves)或图来估计潜在的轨迹,从而定义聚类间的连接。Slingshot 是这种方法的著名代表。
4. 概率框架法 (Probabilistic frameworks)
这种方法为有序的细胞对(cell-cell pairs)分配转移概率 。这个概率定量了“参考细胞是另一个细胞的祖先”的可能性。
- DPT (Diffusion Pseudotime,扩散拟时序) 将拟时序定义为随机游走(random walk)中连续状态之间的差异。
- Palantir 则将轨迹本身建模为马尔可夫链(Markov chains)。
- 这两种方法都依赖于概率框架,并且都需要指定一个根细胞,拟时序是相对于这个根细胞计算的。
★
小编注: 如何选择方法?
轨迹推断是一个研究很充分的领域,方法众多。要选择合适的方法,首先需要对生物学过程本身有所了解。比如,你需要知道这个过程是线性的 、循环的 、还是有分叉的 ? 不同的TI方法适用于不同的轨迹形态。如果你不确定,dynguidelines 提供了一个详尽的算法及其特性概述,可以帮助你进行选择。
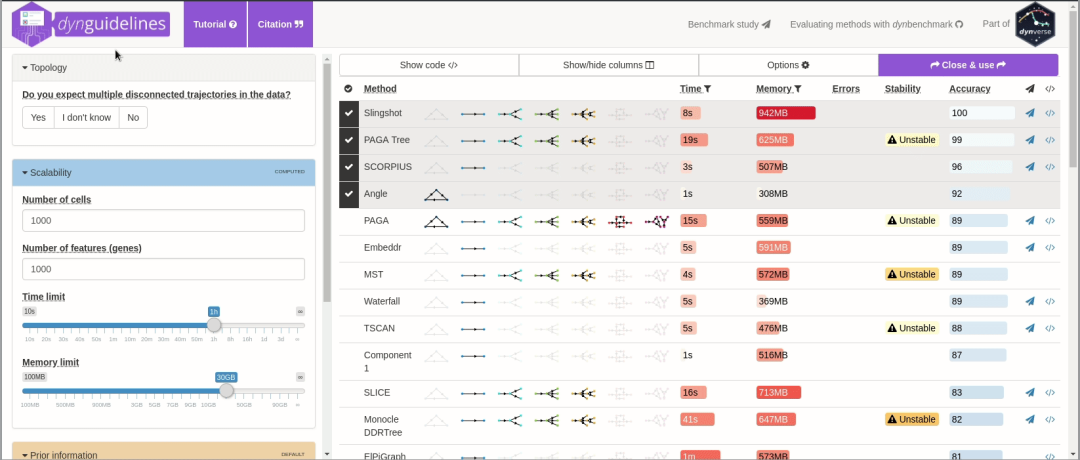 Dynguidelines界面预览
得到拟时序之后呢?
轨迹推断和拟时序本身就能提供有价值的见解,但它们通常只是更精细分析的“垫脚石”。
基于TI和拟时序,我们可以研究一些经典的生物学问题,例如:
- 识别终末状态 (terminal states)。
- 识别谱系分叉 (lineage bifurcation)。
- 鉴定驱动命运决定 (fate decisions)的基因。
例如,Palantir 通过将其构建的马尔可夫链中的“吸收态”(absorbing states)识别为终末状态。
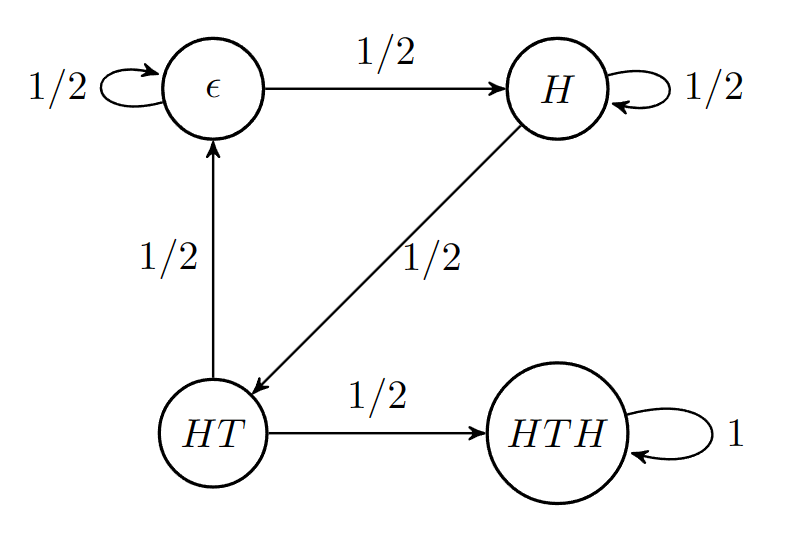 补课:一个简单的马尔可夫链。其中圆圈代表“状态”,数字/箭头代表在状态间转化的概率。“HTH”状态的箭头只进不出,称为“吸收态”。图源: Wikipedia
随着测序技术的发展,新的信息来源(如ATAC-seq、CITE-seq)和新策略(如RNA速率)正被整合进来,使得未来的TI工具能更准确、更稳健地估计轨迹。
实战:成人骨髓的拟时序推断
下面,我们通过一个成人骨髓数据集来展示如何构建和比较不同的拟时序。
环境设置和数据加载
import scanpy as sc
import pandas as pd
from pathlib import Path

# 设置数据目录
DATA_DIR = Path("../../data/")
DATA_DIR.mkdir(parents=True, exist_ok=True)

# 定义文件名
FILE_NAME = DATA_DIR / "bone_marrow.h5ad"

# 加载数据,如果本地没有,则从URL下载
adata = sc.read(
    filename=FILE_NAME,
    backup_url="[https://figshare.com/ndownloader/files/35826944](https://figshare.com/ndownloader/files/35826944)",
)

# 查看AnnData对象
print(adata)
输出:
AnnData object with n_obs × n_vars = 5780 × 27876
    obs: 'clusters', 'palantir_pseudotime', 'palantir_diff_potential'
    var: 'palantir'
    uns: 'clusters_colors', 'palantir_branch_probs_cell_types'
    obsm: 'MAGIC_imputed_data', 'X_tsne', 'palantir_branch_probs'
    layers: 'spliced', 'unspliced'
数据预处理
数据必须经过预处理后才能构建拟时序。“预处理”通常包括我们之前提过的一些基本步骤:过滤掉表达很少的基因、归一化、log转换、高变基因筛选、降维和kNN图。
# 1. 过滤:过滤掉在很少细胞中(这里少于20个)表达的基因
sc.pp.filter_genes(adata, min_counts=20)

# 2. 标准化:归一化细胞大小(Normalize total)
sc.pp.normalize_total(adata)

# 3. 转换:log1p转换,减少异常值影响
sc.pp.log1p(adata)

# 4. 筛选:鉴定高变基因
sc.pp.highly_variable_genes(adata)

# 5. 降维:PCA
sc.tl.pca(adata)

# 6. 建图:构建最近邻图,我们选择10个PC
sc.pp.neighbors(adata, n_pcs=10)

# 绘制t-SNE散点图,按'clusters'着色
sc.pl.scatter(adata, basis="tsne", color="clusters")
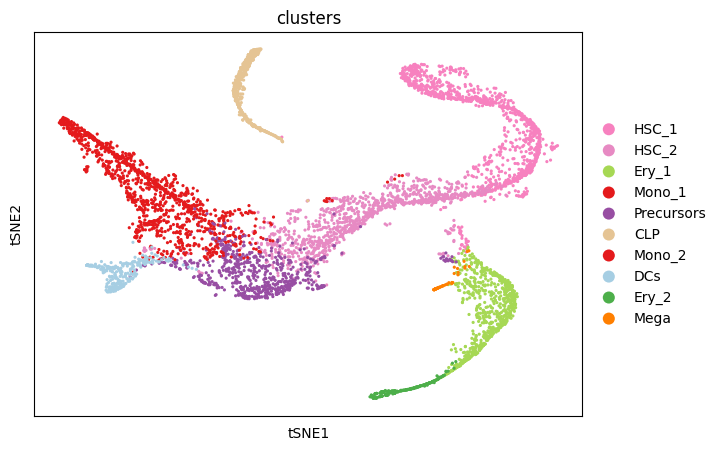
可以看到,细胞类型很好地聚集在一起,并且发育的层级结构也是可见的。
扩散拟时序的构建
现在,我们来计算扩散拟时(Diffusion pseudotime, DPT)。
# 1. 计算扩散图 (Diffusion Map)
sc.tl.diffmap(adata)

# 2. 识别根细胞
# 我们知道骨髓分化是从造血干细胞(HSC)开始的
# 但我们不知道数据集中具体哪个细胞是起点
# 策略:我们研究单个扩散成分(DC),
# 找到在某个维度(这里是DC3)上最极端的那个干细胞
root_ixs = adata.obsm["X_diffmap"][:, 3].argmin()

# 绘图确认
sc.pl.scatter(
    adata,
    basis="diffmap",
    color=["clusters"],
    components=[2, 3],
)

# 将选择的根细胞索引存储在 anndata 对象中
adata.uns["iroot"] = root_ixs

# 3. 计算 DPT
sc.tl.dpt(adata)
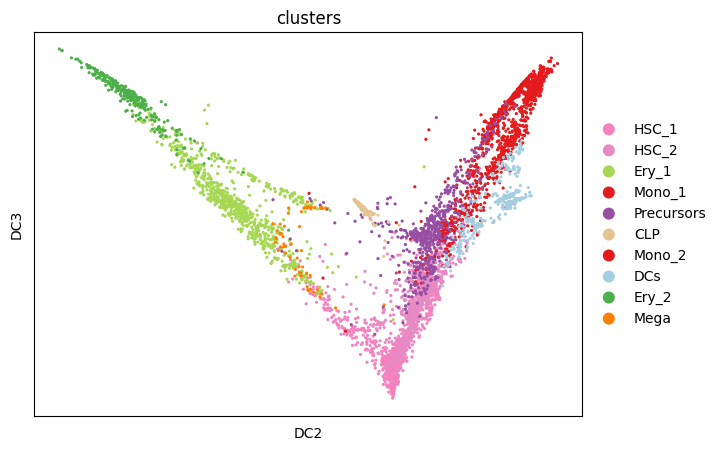
几乎所有的TI方法都需要(至少近似地)知道生物过程的起点。选择“根细胞”是拟时序分析中最关键也最棘手的一步。
上述代码的策略非常具有代表性:我们虽然不知道是哪一个细胞,但我们的生物学先验知识知道是哪一个细胞类型(HSC)。因此,一个常见的做法是在HSC聚类中,寻找在某个降维空间(这里是扩散图的第3个成分)上处于最末端(值最小/最大)的那个细胞,并将其“钦定”为根细胞。
如果想要用与生物学更相关的方法帮助选择 “根细胞”,Cytotrace 是一个不错的选择,它能预测细胞的分化潜力,从而对拟时序所模拟的发育过程提供进一步的支持。
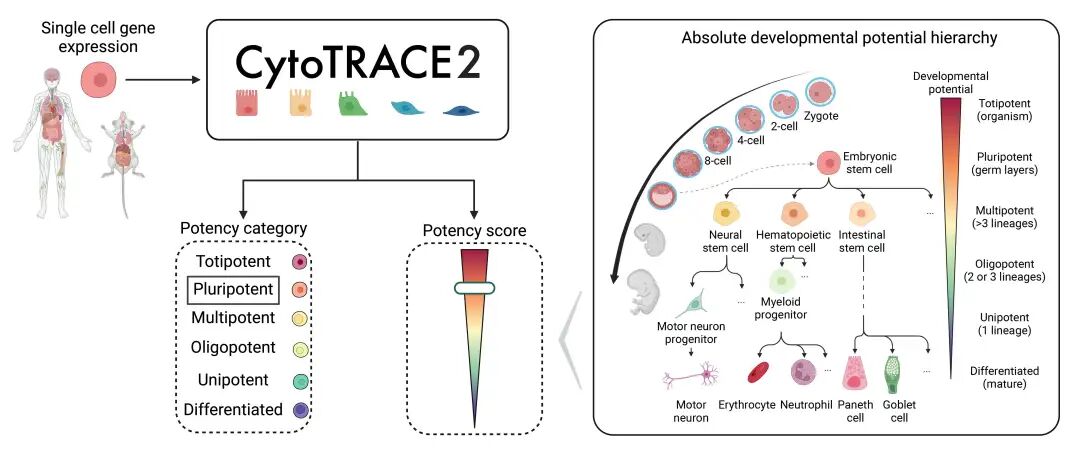 来源:PyPI
比较不同的拟时序 (DPT vs. Palantir)
不同的拟时方法会给出不同的结果。我们把刚计算的DPT与数据集中预先计算好的Palantir拟时进行比较:
sc.pl.scatter(
    adata,
    basis="tsne",
    color=["dpt_pseudotime", "palantir_pseudotime"],
    color_map="gnuplot2",
)
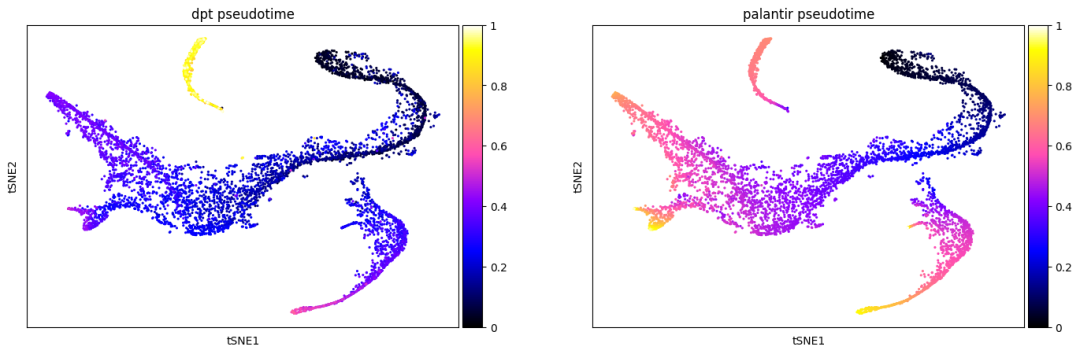
观察到:
DPT:在CLP细胞簇中,DPT拟时值(黄色)异常地高。
Palantir:拟时值(颜色)随着发育成熟度(从HSC到各个谱系)连续增加。
我们再按照细胞簇画出拟时序的小提琴图:
sc.pl.violin(
    adata,
    keys=["dpt_pseudotime", "palantir_pseudotime"],
    groupby="clusters",
    rotation=45,
    # 按已知发育顺序排列
    order=[
        "HSC_1",
        "HSC_2",
        "Precursors",
        "Ery_1",
        "Ery_2",
        "Mono_1",
        "Mono_2",
        "CLP",
        "DCs",
        "Mega",
    ],
)
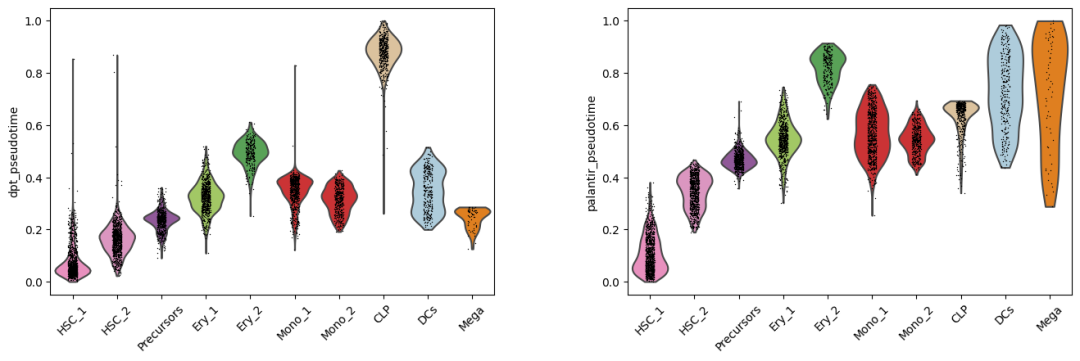
观察到:
DPT:再次显示CLP簇是一个异常值。此外,HSC_1和HSC_2(本应是发育起点)中的许多细胞也具有偏高的拟时值。这与我们的生物学先验知识(这些簇是发育过程的起点)相矛盾。
Palantir:小提琴图的顺序(从HSC_1到Mega)清晰地显示了拟时值的平滑增加。
结论: 综合这些观察和关于骨髓发育的先验知识,我们会选择Palantir 进行后续分析。
总结和后记
关于拟时序分析,有这几个关键点:
需要先验知识: TI方法(如DPT、Palantir)通常需要(至少近似地)知道生物过程的起点(即根细胞)。
方法匹配过程: 生物过程的性质(例如,是线性的、分叉的还是循环的)决定了哪种TI算法是适用的。
善用工具: dynguidelines 是一个很好的资源,可以帮助你根据数据特性选择合适的TI方法。
在R中,大家喜欢的方法还有Slingshot、Monocle2/3等。大家觉得,最好用/最难用的方法是哪个呢?欢迎在评论区分享你的经验!本章英文原文及完整代码,可以在后台回复scbp13 获取。
Bioinfo自习室交流群欢迎各位生信爱好者加入:
----------
单细胞领域大牛编写的最强硬核单细胞教程来啦!想要追更学习笔记,请给我们加个✨,不错过最新推送: