STARsolo真比cellranger快10倍?
STARsolo真比cellranger快10倍?
如果你正在做单细胞 RNA 测序分析,大概率听说过 CellRanger。如果你还恰好做过bulk RNA-seq的上游,那你肯定也知道著名的比对软件STAR。
但你可能不知道,STAR还自带一个专门用于单细胞定量分析的模块STARsolo,它比cellranger更轻量、更灵活、开箱即用,也没有操作系统的限制,在笔记本上进行单细胞上游定量也不是幻想!本期教程就手把手带大家用STARsolo实现单细胞上游定量。
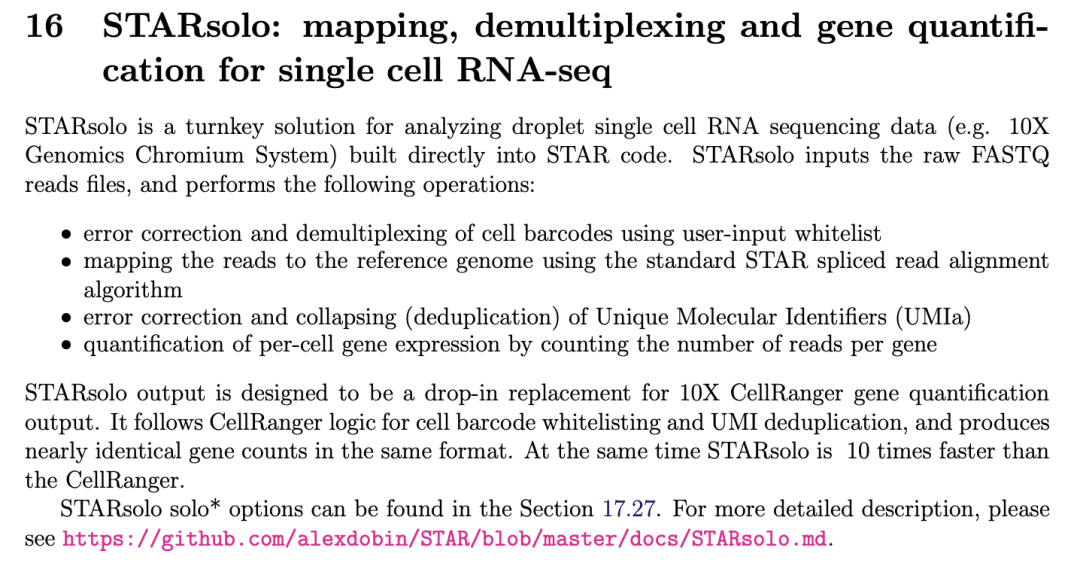 source: STAR manual
安装
⚠️已经安装过STAR的朋友们不用再次安装,STARsolo和STAR是同一个软件!
图省事的家人们可以直接使用conda安装:
conda install bioconda::star
# or
conda install -c bioconda star
注意,M芯片的Mac需要一些特殊的安装技巧,详见 Github Issue #2142 以及之前的推文。如果觉得太复杂,也可以用docker版本(大约会有10%-20%的性能流失)。小编也帮你们编译好了一个mac上完美运行的binary,整理在本期的代码包中。
基因组索引
如果之前已经构建过参考基因组的索引,可以直接使用,一般与bulk RNA-seq通用。
自己重新构建索引的示例代码如下(老鼠GRCm39基因组):
⚠️ 注意:这一步最好上服务器,需要大约30-50GB内存。取决于机器性能,大约需要十几分钟--几个小时不等。
STAR --runThreadN 16 \
     --runMode genomeGenerate \
     --genomeDir GRCm39 \
     --genomeFastaFiles GRCm39.primary_assembly.genome.fa \
     --sjdbGTFfile gencode.vM36.basic.annotation.gtf \
     --sjdbOverhang 100
这里的GRCm39.primary_assembly.genome.fa(基因组fasta)和gencode.vM36.basic.annotation.gtf (基因组注释)文件需要自己下载。我使用的是GENCODE数据库的版本。
如果不知道怎么构建或者没有资源,不用担心,文末代码包也给你们附赠了完整的索引。
⚠️再注意:如果想用cellranger的索引文件(如
refdata-gex-GRCm39-2024-A/star),需要降级STAR到2.7.2a,本文未测试。
条形码白名单(可选)
你可能已经知道,在单细胞实验中,每个细胞由独特的短核苷酸序列“条形码”(barcode)标识。白名单就是所有“合法”条形码的清单,比如10x就有自己的白名单。
如果自己下载过cellranger的安装包,可以查看cellranger-x.y.z/lib/python/cellranger/barcodes/这个目录下就是各种条形码白名单文件啦。
即使没有白名单文件,STARsolo也可以正常运行,不过白名单文件提供了多一层质量保证,可以将无效的UMI先过滤掉。
实战
本文使用小鼠脑细胞数据集作为示例(已包含在本文代码包),来源见文末参考文献。测试平台是MacOS 26.0.1。
# 设置最多打开文件数(很重要!不设置star容易报错)
ulimit -n 2048

# 获取当前所在目录
SCRIPT_DIR="$( cd "$( dirname "${BASH_SOURCE[0]}" )" && pwd )"

# 样本名
SAMPLE="Mouse_brain"
# 数据目录
DATA_DIR="${SCRIPT_DIR}/data"
# 索引目录
STAR_INDEX="${SCRIPT_DIR}/reference/GRCm39_2.7.11b"
# 白名单目录(10x v2)
WHITELIST="${SCRIPT_DIR}/whitelist/737K-august-2016.txt"
# 输出目录
OUTPUT_DIR="${SCRIPT_DIR}/results/${SAMPLE}"
# star二进制目录
STAR_BIN="${SCRIPT_DIR}/bin/STAR"

# 创建输出目录
mkdir -p "${OUTPUT_DIR}"

# 运行STARsolo(cellranger类似结果优化版)
"${STAR_BIN}" --runThreadN 8 \ # 线程数
  --genomeDir "${STAR_INDEX}" \
  --readFilesIn "${DATA_DIR}"/SRR8599150_S1_L001_R2_001.fastq.gz "${DATA_DIR}"/SRR8599150_S1_L001_R1_001.fastq.gz \
  --readFilesCommand "gunzip -c" \
  --outFileNamePrefix "${OUTPUT_DIR}/${SAMPLE}_" \
  --outSAMtype None \
  --soloType CB_UMI_Simple \
  --soloCBwhitelist "${WHITELIST}" \
  --soloCBstart 1 \
  --soloCBlen 16 \
  --soloUMIstart 17 \
  --soloUMIlen 10 \
  --soloBarcodeReadLength 0 \
  --soloStrand Forward \
  --soloFeatures GeneFull \ # 包含内含子,符合cellranger >v7
  --soloUMIdedup 1MM_CR \
  --soloUMIfiltering MultiGeneUMI_CR \
  --soloCellFilter EmptyDrops_CR
⚠️注意:--readFilesIn 后面先 R2 后 R1!这是最容易搞错的地方。
在不创建BAM文件的前提下,STARsolo只用了54s就完成了,表现相当不错。相比之下,cellranger(docker版, v9.0.1)用了7分钟。(如果不进行二次分析,估计大概5分钟左右)
来看看输出目录的结构:
Mouse_brain_Solo.out/
├── Barcodes.stats              # 细胞条形码质量和过滤统计
├── GeneFull/                   # 基因定量结果(外显子 + 内含子)
│   ├── Summary.csv            # 主要指标摘要(细胞数、UMI、比对统计)
│   ├── UMIperCellSorted.txt   # 每个条形码的UMI计数(已排序,用于细胞识别)
│   ├── Features.stats         # 每个基因的统计(UMI计数、检测到的细胞数)
│   ├── filtered/              # 仅包含细胞的液滴(过滤后)
│   │   ├── barcodes.tsv      # 细胞条形码(EmptyDrops_CR过滤)
│   │   ├── features.tsv      # 基因ID和名称
│   │   └── matrix.mtx        # 稀疏UMI计数矩阵(细胞 × 基因)
│   └── raw/                   # 所有条形码(过滤前)
│       ├── barcodes.tsv      # 白名单中的所有条形码
│       ├── features.tsv      # 与filtered/相同的基因注释
│       └── matrix.mtx        # 未过滤的UMI计数矩阵(所有条形码)
其中,filtered/文件夹里就是我们熟悉的三个文件啦,可以加载进R或者python进行下游分析。 如果想用cellbender等软件进行进一步去污染的话,可以使用raw/文件夹下的三个文件。
那么,细胞、基因和UMI数量跟cellranger对比如何呢?
| 指标 | CellRanger | STARsolo | 差异 |
|---|---|---|---|
| 估计细胞数 | 4,308 | 4,291 | -17 (-0.4%) |
| 条形码重叠率 | 4,308 (100%) | 4,279 (99.3%) | -29个细胞 |
| 中位UMI/细胞 | 739 | 659 | -80 (-10.8%) |
| 中位基因数/细胞 | 472 | 441 | -31 (-6.6%) |
| 检测到的总基因数 | 17,742 | 24,216 | +6,474 (+36.5%) |
可以看到,细胞层面基本上是一致的,但在中位UMI/中位细胞数上,STARsolo略低,而检测到的总基因数量偏高。这可能是因为参考索引的不同,以及算法上的差异。
测序质量相关指标也非常相似:
| 指标 | CellRanger | STARsolo | 差异 |
|---|---|---|---|
| 总reads数 | 8,860,361 | 8,860,361 | 0 |
| 有效条形码率 | 84.5% | 84.5% | 0% |
| Q30 CB+UMI | 91.2% | 91.3% | +0.1% |
| Q30 RNA读段 | 56.7% | 56.7% | 0% |
| 测序饱和度 | 10.6% | 10.9% | +0.3% |
| 比对到基因组的reads | 56.4% | 55.3% | -1.1% |
| 细胞中reads占比 | 90.3% | 90.5% | +0.2% |
进阶:RNA速率
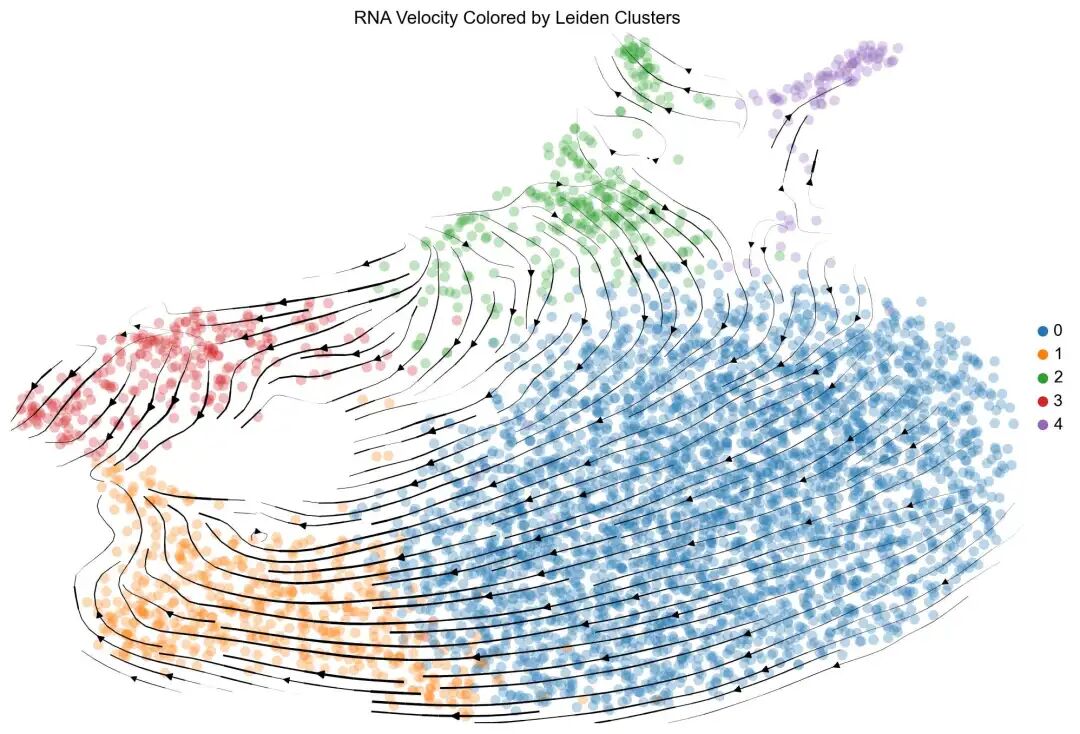
STARsolo还有一个优势:它集成了RNA速率的功能,也就是说,它可以在定量的同时一步到位生成spliced/unspliced数据直接用于下游RNA速率分析。需要改的地方有两个:
- 将
--soloFeatures参数改为GeneFull Gene Velocyto,也就是同时加上Gene(外显子级别定量)和Velocyto。 - 将
--outSAMtype改为BAM SortedByCoordinate,也就是生成bam文件。
你就可以同时获得基因定量和RNA速率定量了。
核心参数速查表
| 参数类别 | 参数名 | 默认值 | 选项 | 用途 |
|---|---|---|---|---|
| 单细胞类型 | --soloType |
- | CB_UMI_Simple / CB_UMI_Complex / SmartSeq |
定义单细胞协议类型 |
| 条形码位置 | --soloCBstart |
1 | 数字 | 条形码起始位置(bp) |
| --soloCBlen| 16| 16 (10x) / 12 (Seqwell)| 条形码长度
UMI位置| --soloUMIstart| 17| 17 (10x v3) / 17 (10x v2)| UMI起始位置
| --soloUMIlen| 12| 12 (v3) / 10 (v2) / 8 (其他)| UMI长度
白名单| --soloCBwhitelist| -| 文件路径 / None| 条形码白名单
链方向| --soloStrand| Forward| Forward / Reverse / Unstranded| 测序链方向
定量特征| --soloFeatures| Gene| Gene / GeneFull / Velocyto| 定量什么区域
UMI去重| --soloUMIdedup| 1MM_All| 1MM_All / 1MM_CR / Exact| UMI去重算法
细胞过滤| --soloCellFilter| EmptyDrops_CR| EmptyDrops_CR / TopCells / None| 细胞识别算法
UMI过滤| --soloUMIfiltering| -| MultiGeneUMI_CR / -| 多基因UMI过滤
输出类型| --outSAMtype| None| BAM SortedByCoordinate / None| 是否输出BAM
本文所用代码与示例数据,可后台回复starsolo获取,包括:
- STAR小鼠基因组索引(GRCm39,版本2.7.4a,STAR>2.7.4a)
- STAR二进制文件,修复了M芯片Mac索引读取以及无法输出reads的问题(其他平台没有测试过)
- STARsolo脚本,包含标准流程和RNA速率两个版本
- 小鼠大脑示例数据fastq文件
- 10x v2和v3的条形码白名单
- starsolo结果以及cellranger结果
- 示例scanpy和scvelo流程
所有脚本和数据都已调试好,开箱即用~
参考文献: