下游笔记2:标准化的数据还能还原?教你一招
下游笔记2:标准化的数据还能还原?教你一招
📢 本期干货预告:
• 判断数据是否标准化过的实用技巧
• 从归一化数据反推原始counts的代码实战
• 各种标准化方法的还原思路
大家好啊!我又来更新下游笔记啦!这一期给大家分享一个小技巧:如何从标准化的数据反推回原始的counts矩阵 。这个技巧在处理公开数据的时候特别有用,因为有时候作者只提供了归一化后的矩阵,但是我们想用一些需要原始counts的方法(比如SCTransform)重新分析数据。
🤔 为什么要反推原始counts?
在开始之前,我们先聊聊为什么会有这样的需求。通常来说,单细胞测序数据分析的第一步就是标准化。大家可能听说过CPM、CP10K、TPM这些概念,它们都是标准化方法。标准化之后的数据会更适合下游分析,因为消除了测序深度的影响。
📌 主要应用场景:
1. 想用新方法重新标准化数据(比如用SCTransform替代传统的log标准化)
2. 需要比较不同样本/数据集的原始表达水平
3. 做某些特定的分析需要原始counts(比如差异表达分析)
🔍 如何判断数据是否归一化过?
在开始反推之前,我们得先知道拿到的数据是否经过归一化,以及是用什么方法归一化的。这里给大家几个小技巧:
1️⃣ 看数据的数量级
# 原始数据
#counts <- obj[["RNA"]]$counts
# CPM
#normalized <- NormalizeData(obj, normalization.method = "RC", scale.factor=1e6)[["RNA"]]$data
# log1p(CP10K)
#lognorm <- NormalizeData(obj, normalization.method = "LogNormalize")[["RNA"]]$data

# 原始counts通常是整数,从0到几百或几千
>max(counts)
[1]4838

# CPM/CP10K标准化后通常在0-1e6之间
>max(normalized)# CPM
[1]727843.1

# log标准化后通常不会超过20
>max(lognorm)# log1p(CP10K)
[1] 8.892808
2️⃣ 看每个细胞的总和
# 查看前几个细胞的总表达量
> colSums(counts)[1:5]
1502 2431 1861 1073 2179
> colSums(normalized)[1:5]#CPM
1e+06 1e+06 1e+06 1e+06 1e+06
> colSums(lognorm)[1:5]# log1p(CP10K)
1691.305 1512.919 1982.604 1467.348 1828.618
重要特征:
• CPM标准化后,每个细胞的总和应该约等于1e6
• CP10K标准化后,每个细胞的总和应该约等于1e4
3️⃣ 看是否有小数
# 如果有很多小数,那么大概率是归一化过的
> head(matrix[,1])
Gene1    Gene2    Gene3    Gene4    Gene5
0.00000  3.24156  0.12456  1.95632  0.00000
4️⃣ 看管家基因的相对表达量
一个很实用的技巧是观察管家基因的相对表达量,尤其是基因长度差异较大的管家基因。这个方法特别适合判断数据是否经过了考虑基因长度的标准化(如TPM/RPKM)。
以下是几个常用的管家基因及其长度:
• ACTB (β-actin): ~1.9kb
• GAPDH: ~1.4kb
• RPL13A: ~1.0kb
• SDHA: ~2.3kb
提取管家基因表达量
housekeeping <- lognorm[c("ACTB", "GAPDH", "SDHA"),]
计算ACTB/GAPDH比值
actb_gapdh_ratio <- mean(housekeeping["ACTB",] )/mean(housekeeping["GAPDH",])
[1] 1.18 # CP10K标准化
判断标准:
• 在CPM/CP10K标准化中:ACTB/GAPDH比值约为1.1
• 在TPM/RPKM标准化中:ACTB/GAPDH比值约为0.85(因为考虑了基因长度)
• SDHA(最长的基因)在TPM/RPKM中的表达量会显著低于CPM中的表达量
🔍 小提示:
在单细胞数据中,由于dropout效应,建议看多个细胞的平均值。同时要注意,不同组织/细胞类型中管家基因的表达可能有差异。
💻 从log1p CP10K反推原始counts
好了,让我们直接上代码!假设我们拿到的是一个log1p CP10K标准化后的矩阵,我们要:
反推步骤:
1. 先去掉log1p的效果(exp(x)-1)
2. 然后还原CP10K的效果(乘以每个细胞的总counts/10000)
3. 最后把结果取整
# 假设我们的输入矩阵叫lognorm
# Step 1: 去掉log1p的效果
unlog_mat <- expm1(lognorm)# 等同于exp(norm_mat) - 1

# Step 2: 从一个细胞中找到最小的非零值
get_min_nonzero <-function(x){
min(x[x >0])
}

# Step 3: 对每个细胞,用最小非零值作为基准还原
raw_counts <- apply(unlog_mat,2,function(x){
    min_val <- get_min_nonzero(x)
round(x/min_val)# 取整
})
🔎 验证结果
# 1. 看看是否都是整数
all(raw_counts ==round(raw_counts))# 应该是TRUE

# 2. 标准化新得到的counts,看看是否能重现原始的norm_mat
library(Seurat)
test_obj <-CreateSeuratObject(raw_counts)
test_obj <-NormalizeData(test_obj)

# 3. 比较原始的norm_mat和重新标准化的结果
plot(lognorm[,1],
     test_obj[["RNA"]]@data[,1],
     xlab ="Original normalized data",
     ylab ="Re-normalized data",
     main ="Comparison of normalization")
abline(0,1,col="red")  # 如果完美重现,所有点应该落在这条线上
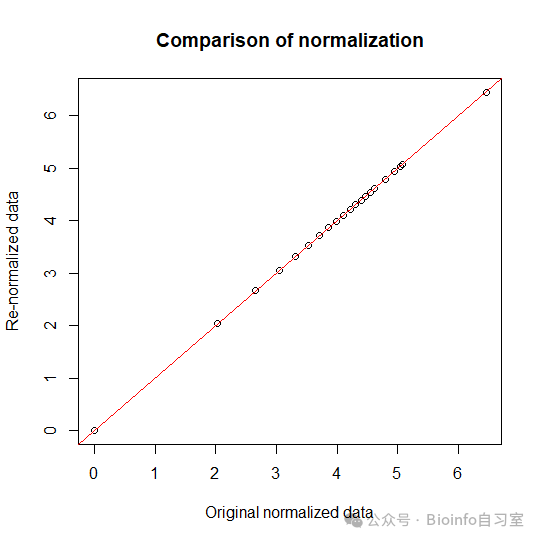
Amazing!
⚠️ 这样做合理吗?
这个方法的核心假设是:在一个UMI-based的单细胞数据中,每个细胞里最小的非零count应该是1 。这个假设在大多数UMI数据中是成立的,因为:
✅ UMI技术可以精确计数每个转录本
✅ count必须是整数
✅ 最小的非零count就是1个转录本被测到
⚠️ 注意事项:
这个方法并不适用于所有情况:
1. 如果原始数据不是UMI-based的(比如Smart-seq2),这个假设就不一定成立
2. 如果数据经过了复杂的标准化(比如SCTransform),这个方法就不适用
3. 如果数据质量不太好(比如dropout严重),结果可能会有偏差
🔄 扩展:其他归一化方法的还原
同样的思路也适用于其他标准化方法:
| 标准化方法 | 还原思路 | 是否推荐 |
|---|---|---|
| log1p CPM | 把10000换成1e6 | ✅ |
| log2 | 用2为底的指数函数 | ✅ |
| TPM | 需考虑基因长度 | ❌ |
📝 小结
这个技巧虽然看起来有点"逆向操作",但在实际工作中确实很有用。特别是在处理公开数据,或者想用新方法重新分析数据的时候。不过也要记住,这种反推始终是一种估计,不能完全还原原始数据。如果可能的话,最好还是找原始的counts数据来分析!
💌 如果你在用这个方法的时候遇到了问题,或者有其他想法,欢迎在评论区留言讨论!我们下期再见啦!
#生物信息学 #单细胞测序 #数据分析 #R语言