把AI请回家:本地LLM入门指北
把AI请回家:本地LLM入门指北
最近很火的DeepSeek R1,大家都用了吗?你可能不知道,其实并不需要高大上的服务器,也不需要很多的专业知识,普通的个人电脑也可以跑上强大的模型!本期为大家带来在LM Studio本地部署模型的教程,绝对新手友好,一起来看看吧~
有网页版了,为什么还需要本地大模型呢?
本地部署相比使用在线API具有显著优势:它能够确保数据隐私与安全,所有的对话内容和敏感数据都完全保留在本地;从长远来看,一次性的硬件投入后使用成本更可控,特别适合需要频繁使用的场景;此外,本地部署让你能够在离线环境下使用模型,无需担心网络延迟或API限制。最重要的是,你可以根据具体需求调整模型参数和系统提示词,获得完全的控制权。简单来说,本地运行的大模型主要有隐私、成本和自由度 的优势;当然劣势也很明显:你的硬件决定了你能跑什么样的模型。一般来说,商业级的大模型参数量都在千亿级别,个人电脑取决于配置,能流畅运行的模型参数量一般在几亿-几百亿之间,参数精度也会下降,相比之下就是“小”模型了。
本地运行的“小”模型能干什么?
“小”模型一定就比不上大模型吗?其实,本地部署的模型也完全能胜任许多日常任务。7B规模的模型最为轻量,适合日常对话、简单写作和代码补全等基础任务,响应速度快,是入门级选择。14B规模的模型在性能和资源占用上较为均衡,适合专业写作、文献阅读和中等复杂度的编程任务。32B规模的模型则具备更强的推理能力和更广的知识面,适合处理复杂推理、多轮专业对话和高难度创作任务。在科研工作中,不同规模的模型各有特长。以文献综述为例,7B模型擅长单篇论文的总结,可以准确提取关键方法和结论;13B模型能够同时处理3-5篇相关论文,进行方法对比和结果分析;34B模型则可以处理更大规模的系统性综述,综合10篇以上论文的内容,并提供深入的见解和建议。在实验分析方面,7B模型可以协助完成数据预处理工作,生成基础的统计分析代码;13B模型能够在实验设计阶段提供有价值的方法学建议;而34B模型则可以参与更复杂的实验方案优化,协助进行多变量分析和建模工作。
部署你的第一个私人AI
在开始本地部署之前,了解硬件需求和选择合适的模型至关重要。对于显存需求,不同规模的模型要求差异较大。以量化后的模型为例,7B参数规模的模型最低需要6GB显存,14B参数需要10GB显存,而34B参数的大模型则需要20GB以上的显存。就算没有独立显卡,绝大多数的消费级CPU也可以流畅运行1B-7B的模型。LM Studio可以说是最用户友好的部署工具了,有比较直观的图形界面,也提供诸如本地API、调参、上下文的高级功能。它支持Windows、MacOS和Linux,在官网(lmstudio.ai)就可以下载。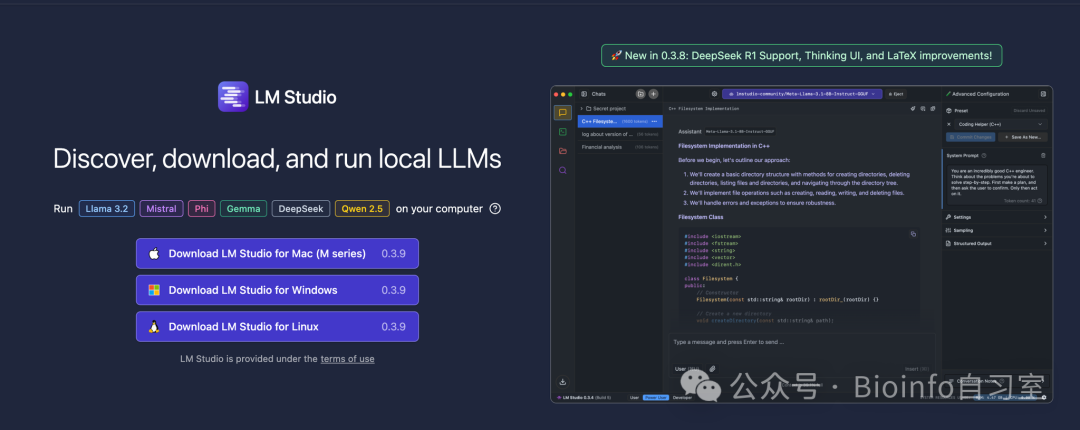
下载完成后打开,点击左侧工具栏的搜索🔍图标,就可以探索开源模型社区Hugging Face里丰富的资源啦!看到心仪的模型,点击右下角的“下载”就可以了。比如这里的Deepseek R1蒸馏到阿里千问的7B模型(澄清一个常见的误区:这些小型的Deepseek模型并不是Deepseek R1的本体,而是由R1做“教师”训练出来的模型“学生”,学到了“教师模型”的技能和知识,也就是千问的7B模型学会了R1的知识和推理功能)。
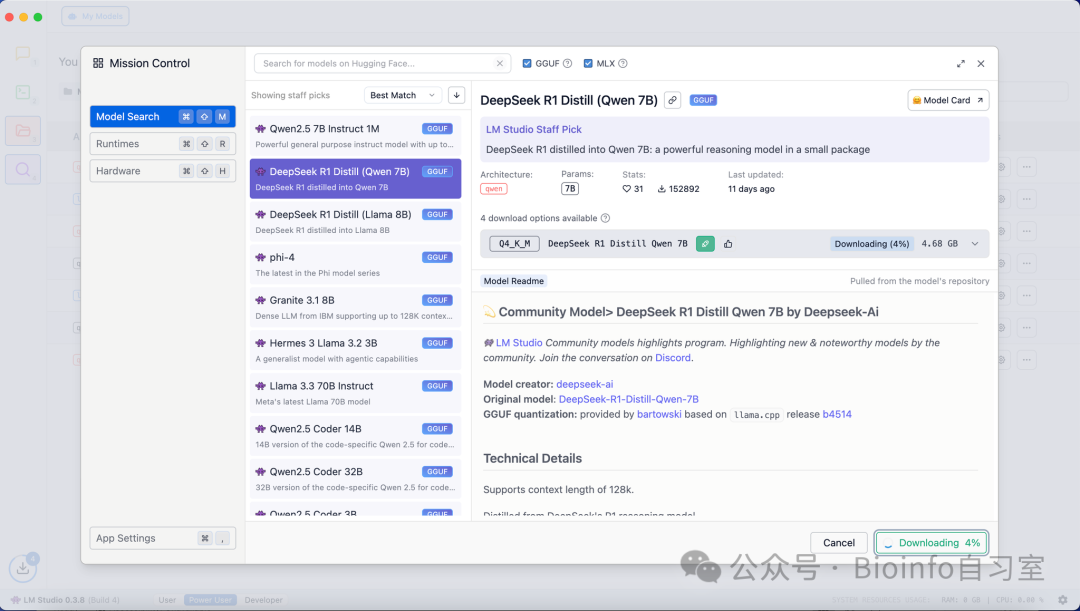 对于M芯片的Mac,常见的模型格式有两种:GGUF和MLX。MLX基于苹果自己开发的机器学习框架,所以性能和优化会更好,但是并不是所有模型都有这种格式;GGUF是通用的格式,选择更加多样。但是模型本体的权重和参数并没有区别。模型下载好之后,你可以点击弹出窗口的“Load Model”加载刚下好的模型,或者点击左侧工具栏的聊天💬图标,在对话界面自己选择想要加载的模型。其余的使用方法,跟网页界面是一样的。
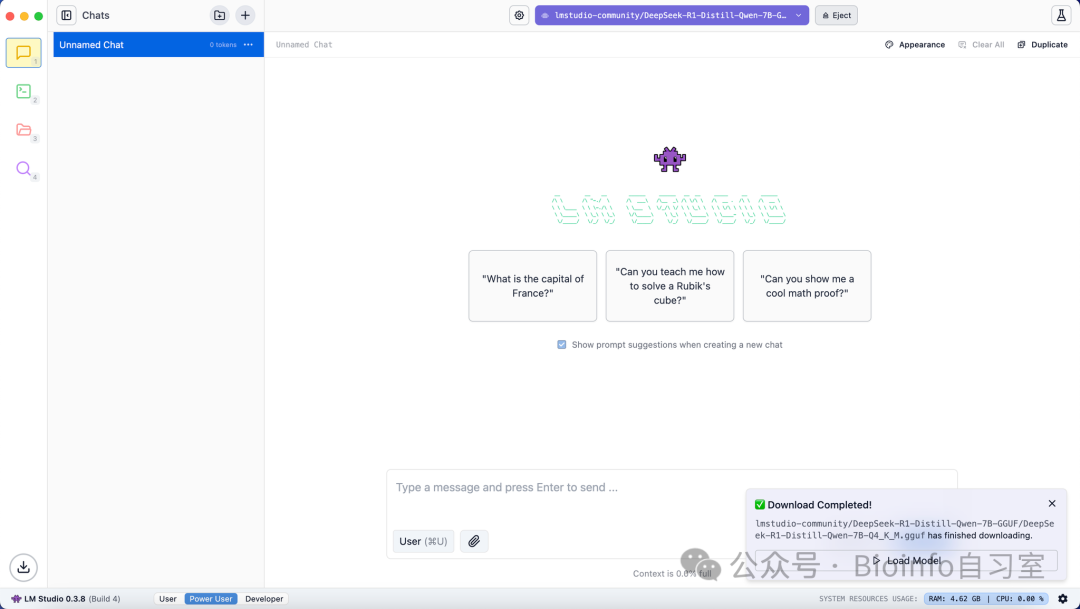
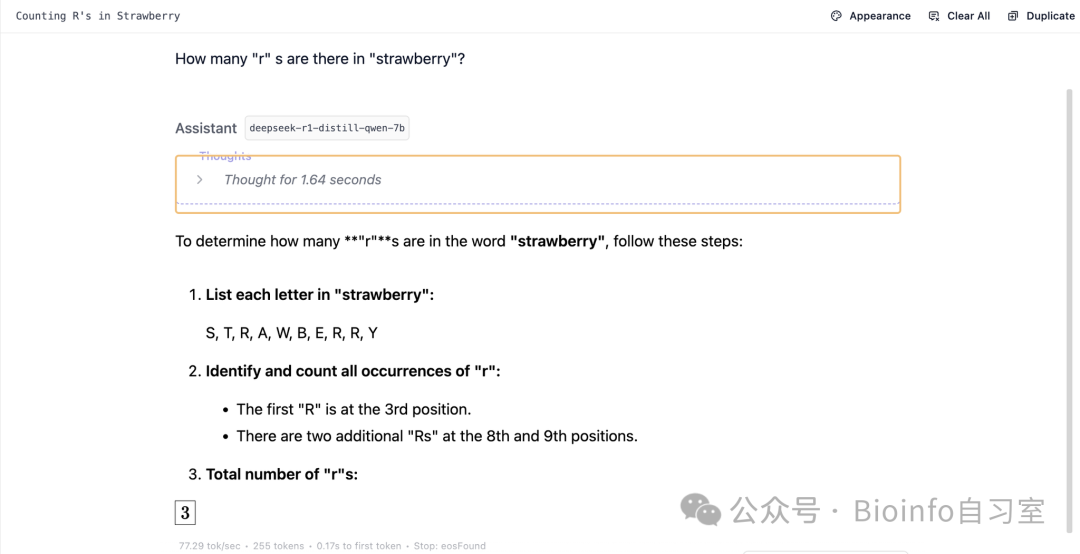
来试试经典的草莓难题:5秒钟就答出来了,而且答对了!
 记得领取Bioinfo自习室为大家准备的红包哦!
完

点赞分享在看留言