未来已来:LLM X 单细胞的时代开始了
未来已来:LLM X 单细胞的时代开始了
相信大家最近都被刷屏了。9月12日,OpenAI 发布了最新的强大语言模型o1,引入了“思维链”模式,使得 LLM 可以像人类一样拆解复杂问题并分步推理,甚至可以看到 LLM 的思考过程。据称,o1能做复杂的数学运算,取得奥赛金牌级别的成绩,还能进行科研,提出合理的研究方向,表现丝毫不逊于该专业的博士生 。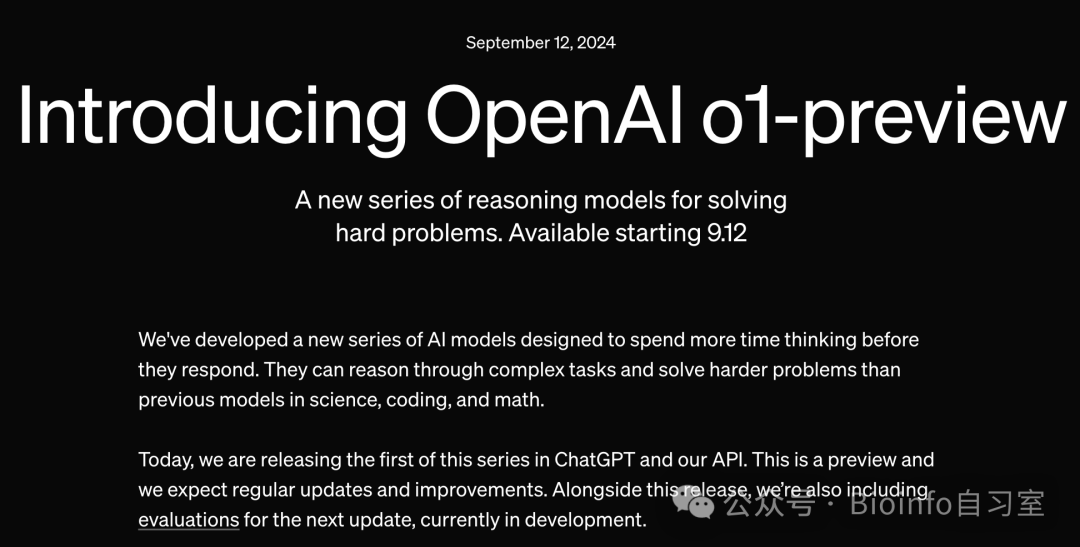 Source: https://openai.com/index/introducing-openai-o1-preview/不知道大家注意到没有,在官方的发布页面上特意提到了其中一个使用场景: “协助研究者注释细胞测序数据” 。单细胞组学,作为生物学研究的未来之光,终于也得到了大模型的青睐。
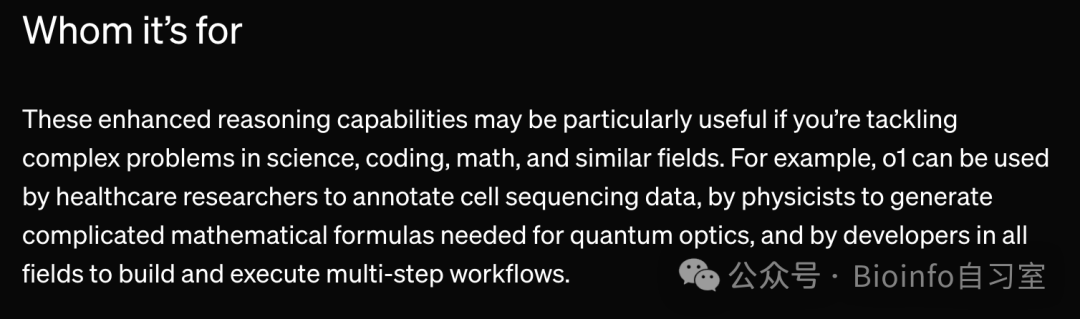 Source: https://openai.com/index/introducing-openai-o1-preview/传统的单细胞注释一般是以**手动注释** 为最终标准。手动注释是一个复杂而精细的过程,涉及多层面的分析和判断。这个过程主要包括两个关键步骤:
- 1. 识别差异表达基因: 研究者需要在不同细胞群体间比较基因表达谱,找出显著上调或下调的基因。
- 2. 解读基因表达模式: 分析标志性基因在各个细胞群中的表达水平及其分布特征。
这两个步骤不仅要研究者对目标细胞或组织有着深入而全面的知识储备 ,比如细胞类型特异的基因,各种细胞状态(如活化、分化、应激等)下的基因表达,还要能识别和排除技术噪音 ,比如污染、空细胞、多细胞、由于实验操作导致的应激态细胞等等。正是由于手动注释如此依赖专业知识和经验,它往往被视为一种"艺术",需要长期的训练和实践才能精通。然而,随着单细胞数据规模的急剧扩大和复杂性的提高,纯粹依赖手动注释的方法正面临着效率和一致性的挑战。于是,陆陆续续有不少自动注释和辅助注释的方法被开发出来。学者们的策略大致分为几种(不互斥):
- 1. 标志基因 :通过预定义的标志性基因集,用匹配或者“打分”(probability or expression based)的模式确定细胞类型。代表方法有scType、SCINA 等等。
- 2. 数据映射 :利用已有标注的参考数据集,自动推断细胞类型。代表方法有SingleR、Azimuth 等等
- 3. 机器学习 :通过机器学习模型,从数据中自动学习细胞类型的注释规则。代表方法有CellTypist、ACTINN 等等
- 4. 功能分析 :通过基因调控网络或者通路富集的方法辅助注释。代表方法有GSEA、SCENIC 等等。
然而,这几种策略都各有优劣,比如速度的快慢、对于参考基因或者数据集的要求、对计算资源的要求、对未知细胞的发现能力等等。因此,目前的主流观点还是在自动注释之后手动核对,或者使用多种方法互相验证,因此对研究人员仍然有不低的要求。这个部分就可以让LLM代劳了。 其实用GPT辅助注释单细胞数据早就不是新鲜事了。早在2024年3月,一篇让我震惊**“这也能发Nature Methods”** 的文章就描述了如何通过给GPT提供分群标志基因让GPT预测细胞类型 ,并且平均正确率(预测类型和手动标注一致的频率)达到75%以上。具体的方法非常简单:列举每个分群的前几个差异基因(作为标志基因),让GPT输出细胞类型。作者还顺手写了一个小R包GPTCelltype ,只有一个函数,50行代码,可以在实现在R里输入一个Seurat object,然后调用GPT的API,并把预测结果输出成一个vector。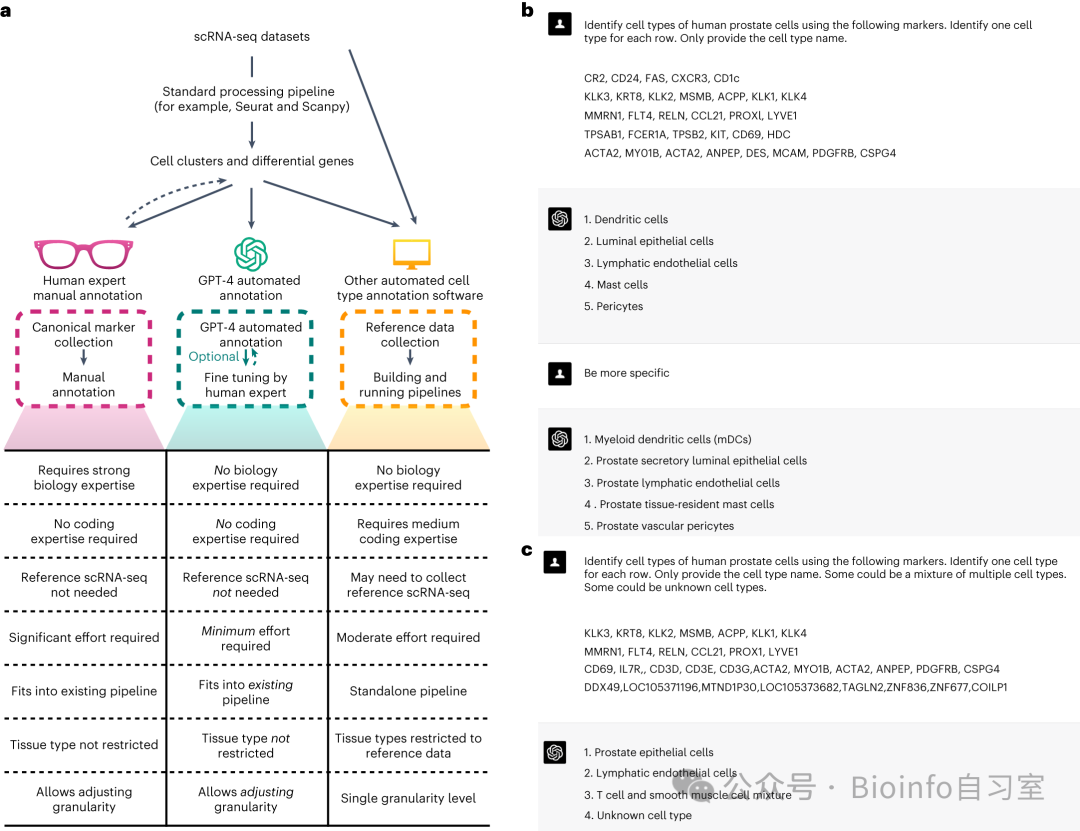 Source: Hou, W., Ji, Z. Assessing GPT-4 for cell type annotation in single-cell RNA-seq analysis. Nat Methods 21, 1462–1465 (2024). https://doi.org/10.1038/s41592-024-02235-4还有些研究者致力于训练单细胞专用生成式大模型,比如同样是发在Nature Methods上的scGPT ,用了三千万个细胞的单细胞数据训练,用于注释、整合、预测扰动响应等任务。但是这个门槛比较高,需要自己有服务器来部署训练这个大模型,也没有包装好的R包接入Seurat生态系统。
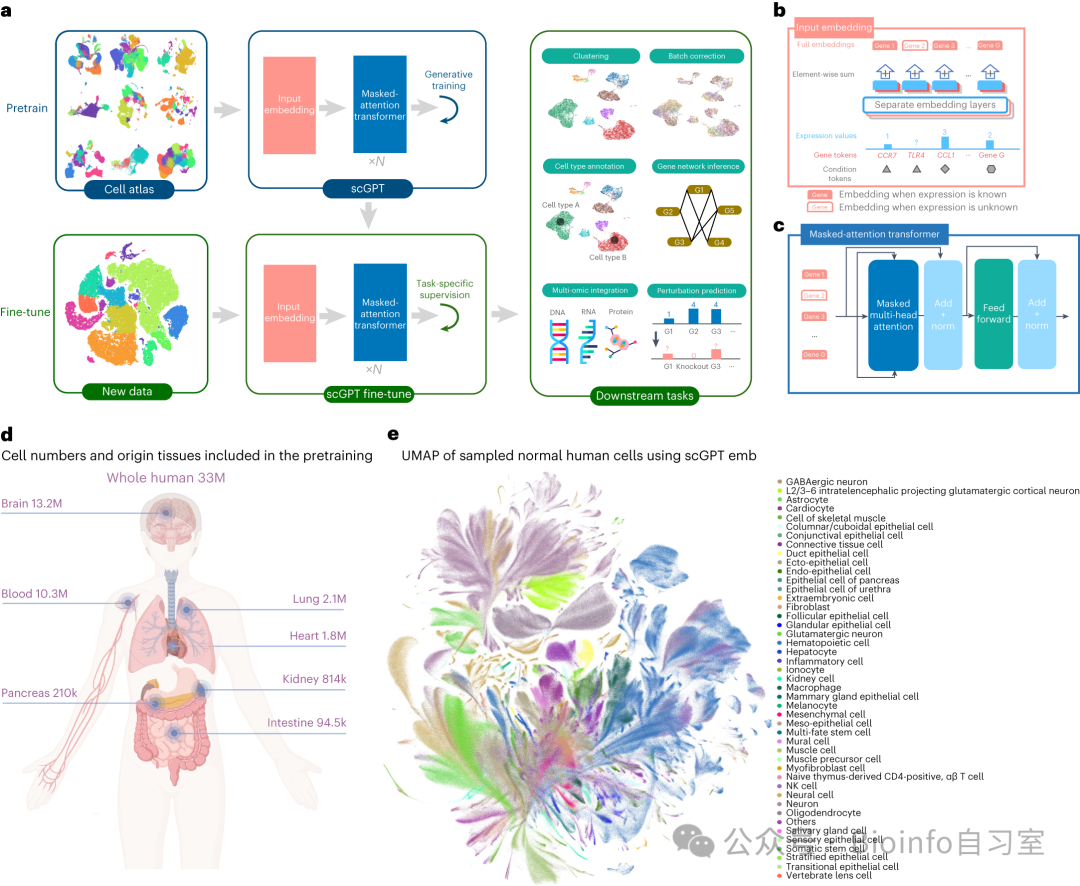 Source: Cui, H., Wang, C., Maan, H. et al. scGPT: toward building a foundation model for single-cell multi-omics using generative AI. Nat Methods 21, 1470–1480 (2024). https://doi.org/10.1038/s41592-024-02201-0
目前为止,将LLM使用在实际科研过程里的行为还有争议。科研人员对 LLM 的犹豫也许来源于LLM 的思考过程不透明 ,以及LLM 的结果不稳定 ,这也是其他 AI 模型(如深度神经网络)的通病。它的算法是个黑箱 ,你只知道输入和输出,并不知道 AI 为什么作出这样的判断。同时,像 GPT-4 和 Claude 这样的大模型更像黑箱,因为你无法得知训练数据具体都包括哪些。LLM也大不同于传统的机器学习模型或者统计学/数学模型,它的结果没有p-value、概率或者置信区间,在注重significance 和可复现性 的学术界,LLM被接受的速度这么快,也从侧面反映出LLM的强大。LLM对于分析的帮助是毋庸置疑的。对于非专业的生信爱好者来讲,利用现有的、无需重新训练的LLM辅助分析省时又省力,且通过prompt engineering,或者提供更多的信息,也能显著提升LLM的准确度和可信度。
就拿细胞注释来讲,在GPTCelltype的基础上做一些prompt engineering就能得到更好的输出结果。比如,现有的指引是:“'Identify cell types of ',tissuename,' cells using the following markers separately for each row. Only provide the cell type name. Do not show numbers before the name. Some can be a mixture of multiple cell types. ” 你可以给LLM加上一个role ,比如“You're an expert in molecular and cellular biology”,暗示LLM调取相关知识;再给输出加入一些限制 ,比如“Provide the predicted cell type in the following format: Cluster - Cell Type. No additional explanation.”来让格式更统一更易读;还可以细化指令 ,比如“Do not use Unknown as a cell type. Provide your best guess.”来防止AI“偷懒”直接告诉你“不知道”。给LLM提供更多信息 也能提升结果准确度。比如,除了上调的基因,还可以提供下调的基因。当几个cluster同属某一大类,差异基因里没有该类细胞的标志基因(如上皮细胞都有Epcam,免疫细胞都有Ptprc)时,可以额外提供标志基因的表达信息 、GSEA的富集情况 ,如富集最高的几个通路等等。还可以多次询问LLM,或者比对不同模型的输出结果 来提升模型表现。在我的尝试中,结合这几种策略能让准确度再次提升。如下图,以GSE185344(病人前列腺癌单细胞测序,约5万个细胞)为例,优化指令 并提供GSEA富集结果 后,GPT-4就能区分开smooth muscle和fibroblast,以及NK cell和T cell。同时,Myeloid cell也能进一步区分出neutrophil和macrophages,最终结果跟手动注释的几乎是完全吻合的。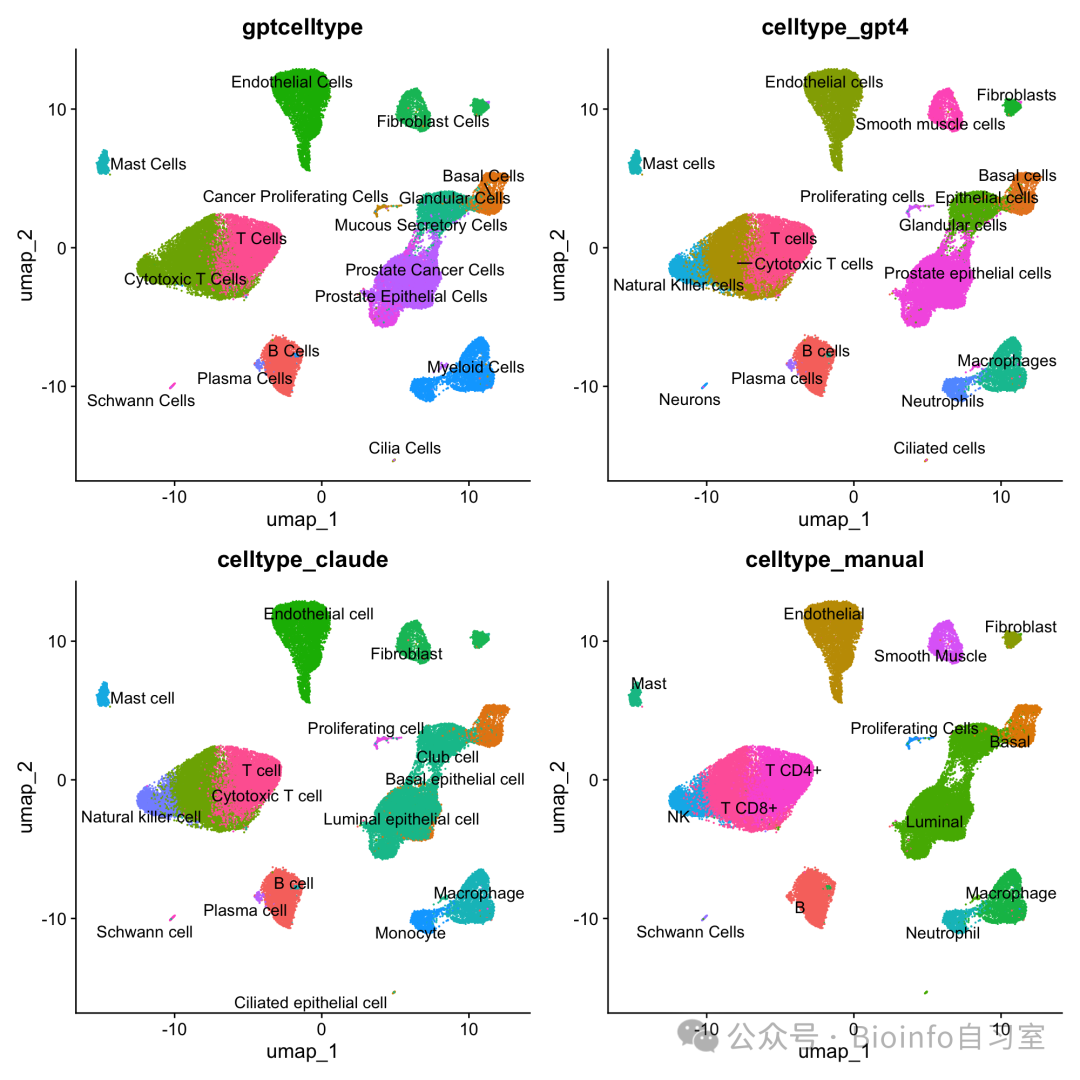
几种注释方法的对比,数据来源:GSE185344。其中左上为原版GPTcelltype(使用gpt-4),右上为优化了prompt的效果。左下为Claude3.5使用同样prompt的结果,右下为纯手动注释的结果。可以看到LLM的表现都很不错!
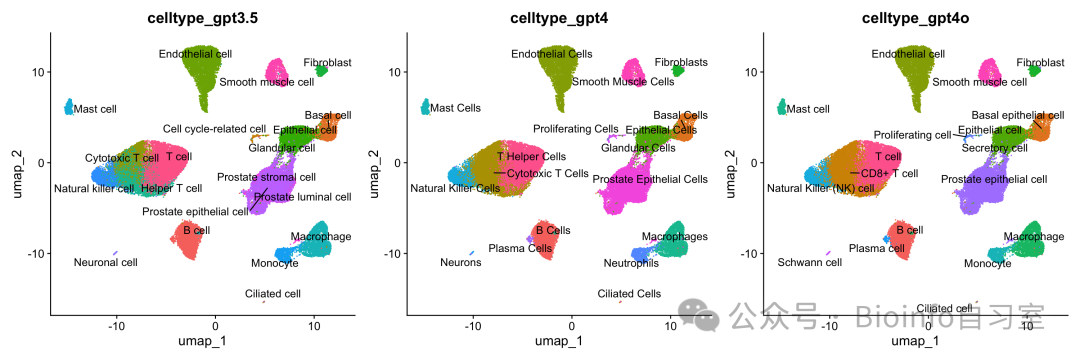
在模型的选择方面,同样使用API接口,gpt-3.5-turbo的速度是最快的(2-3秒即可给出结果)也是最便宜的,单次注释花费不到$0.01;gpt-4o紧随其后,单次注释耗时4-5秒左右,花费约$0.02;最贵的是gpt-4,耗时约十几秒,单次注释就要花费$0.4-0.5,贵了几十倍...claude3.5 sonnet的表现和gpt-4o类似,但是单次注释约$0.06。各个模型的表现差别不是很大,但gpt-4是唯一一个能准确注释Neutrophil的模型。
未来,这样直接与LLM交互,辅助分析的模式很可能会迅速延续到单细胞数据分析的其他方面。给LLM提供差异基因或者通路富集结果 ,LLM可以识别保守的标志基因和通路,帮助多模态或是跨物种的整合,或者根据最显著的基因/通路预测细胞对药物和基因扰动的响应。 LLM也可以通过解读无监督聚类产生的**“元基因”** 或者**“gene module”** 的生物学意义,帮助发现保守或者变化的生物学功能 ,以及发现基因调控网络 。LLM有着不断更新的庞大知识库,所以在数据解读、预测 的方面有得天独厚的优势。以上就是我的一些想法,希望能对你有一些启发。有不准确的地方欢迎交流指正